Aktualisiert am 10. September 2026.
Produktforschungs-KI sollte nicht daran gemessen werden, wie viele Themen sie findet, wie schnell sie eine Zusammenfassung schreibt oder wie ausgefeilt das Dashboard aussieht. Das sind Aktivitätsmetriken. Sie zeigen, dass das System etwas getan hat, nicht ob das Team eine bessere Produktentscheidung getroffen hat.
Die nützliche Frage ist präziser:
Hat dieser Produktforschungs-KI-Workflow eine Entscheidung verändert, die Ihr Team mit Belegen vertreten kann?
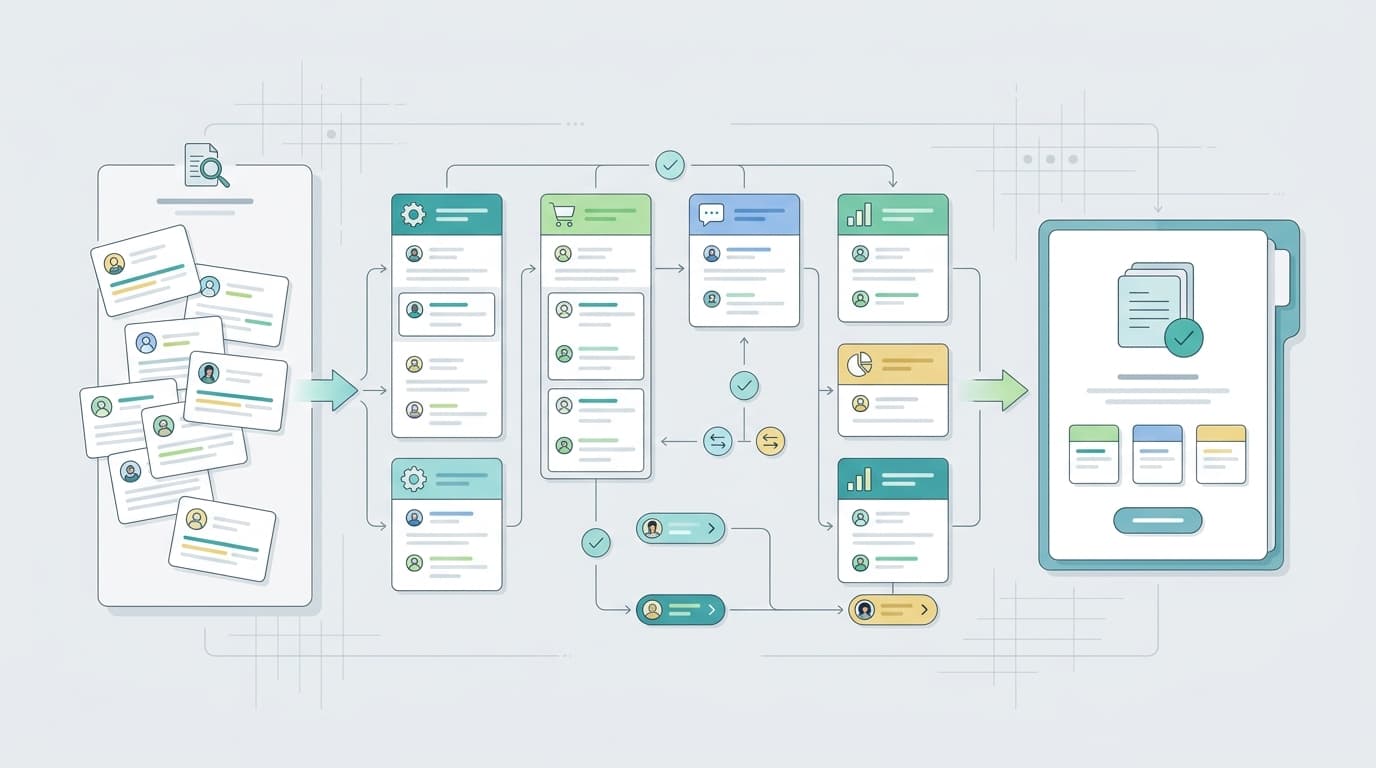
Das ist der Maßstab, den dieser Leitfaden verwendet. Die folgenden Kennzahlen helfen Produkt-, E-Commerce-, Research-, Growth- und Gründerteams dabei zu messen, ob Produktforschungs-KI aus Bewertungen, Wettbewerbsbelegen, Kategoriesignalen, Support-Tickets, Interviews und internen Notizen entscheidungsreife Arbeit liefert.
Wenn Sie zuerst die Kategorien-Definition benötigen, beginnen Sie mit was Produktforschungs-KI ist. Wenn Sie Software auswählen, nutzen Sie den Produktforschungs-KI-Vergleich und das Bewertungsframework für Produktforschungs-KI-Tools. Wenn Sie bereits einen Workflow im Einsatz haben, behandelt der praktische Leitfaden zur Produktforschungs-KI den operativen Takt. Diese Seite ist enger gefasst: Sie liefert Ihnen die Kennzahlen, die zeigen, ob es sich lohnt, den Workflow beizubehalten.
Der Kennzahlen-Stack für Produktforschungs-KI
Verwenden Sie diese Kennzahlen zusammen. Eine einzelne Zahl wird Ihnen nicht sagen, ob Produktforschungs-KI funktioniert.
| Metrik | Was sie misst | Wie man sie berechnet oder prüft | Was ein schwaches Ergebnis bedeutet |
|---|---|---|---|
| Entscheidungstauglichkeitsrate | Ob Outputs eine benannte Produktentscheidung beantworten | Akzeptierte Outputs, die mit einem Entscheidungssatz verknüpft sind / insgesamt geprüfte Outputs | Die KI erstellt Forschungsartefakte ohne klaren Auftrag |
| Evidenzabdeckungsrate | Ob Erkenntnisse genügend Quellennachweise enthalten | Erkenntnisse mit Quellenbeispielen, Kohorte und Gegenbelegen / akzeptierte Erkenntnisse | Themen mögen plausibel sein, sind aber schwer zu vertreten |
| Nachvollziehbarkeitsrate | Ob ein Teammitglied die Quelle hinter jeder Behauptung prüfen kann | Wesentliche Behauptungen mit Links, Datensatz-IDs, Prüfbeispielen oder Exportzeilen / wesentliche Behauptungen | Der Output hält einer Prüfung durch einen skeptischen Verantwortlichen nicht stand |
| Kohortenstabilität | Ob Wiederholungen dieselbe Evidenzgrenze verwenden | Produktmenge, Wettbewerbermenge, Zeitfenster, Markt, Bewertungsband und Ausschlüsse zwischen Läufen vergleichen | Die Antwort kann sich ändern, weil sich die Eingabe unbemerkt geändert hat |
| Trennung von Nachfrage und Schmerz | Ob Marktnachfrage und Kundenschmerz getrennt bleiben | Jede Empfehlung getrennt nach Nachfrage-Evidenz und Schmerz-Evidenz bewerten | Das Team jagt vielleicht einer lauten Beschwerde in einem schwachen Markt oder einer heißen Kategorie ohne lösbares Problem hinterher |
| Widerspruchserhalt | Ob Minderheits- oder widersprüchliche Evidenz sichtbar bleibt | Akzeptierte Erkenntnisse mit mindestens einer Randbedingung oder einem Gegenbeispiel / akzeptierte Erkenntnisse | Die KI glättet Segmentierungssignale über |
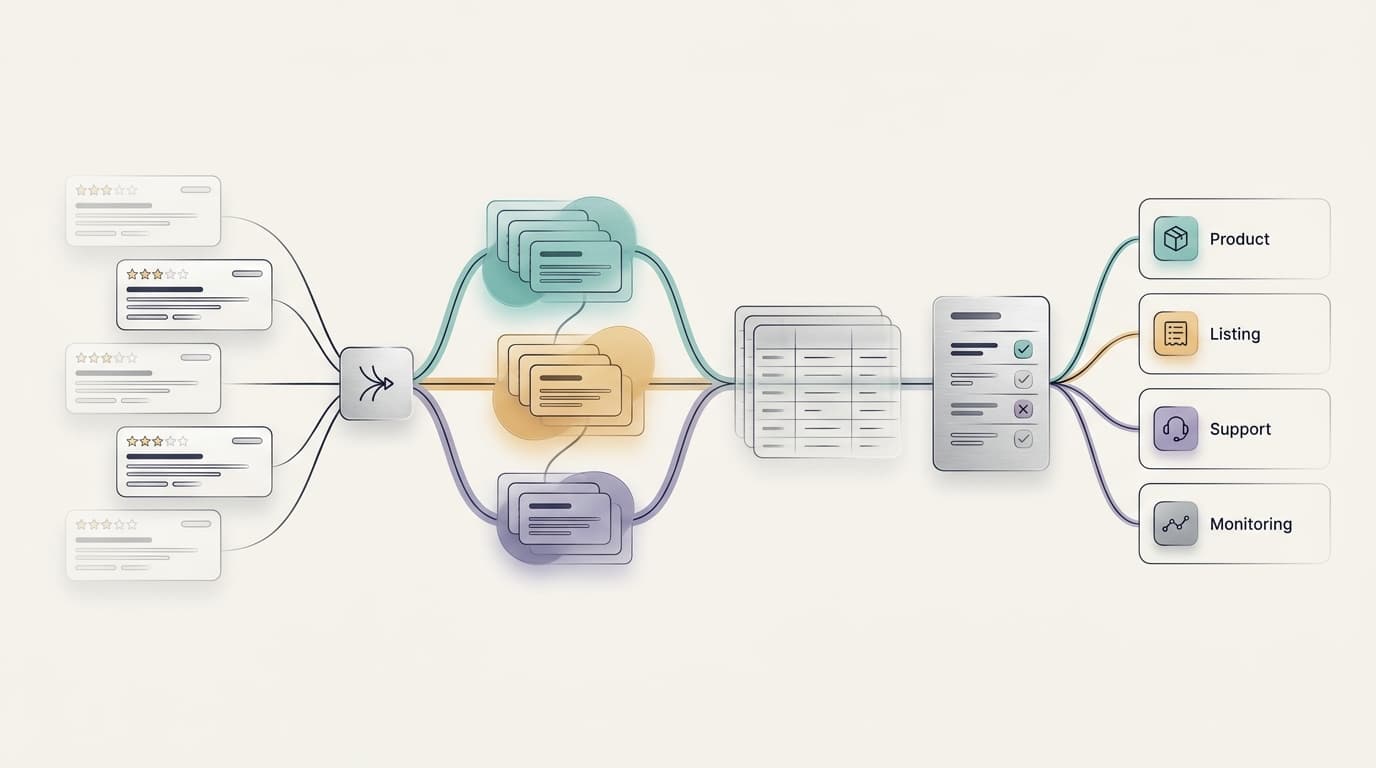
| Umsetzungsrate | Ob der Output zu einem nutzbaren nächsten Artefakt wird | Outputs, die ein PRD, ein Listing-Briefing, eine Roadmap-Notiz, einen Testplan, ein Support-Makro oder einen No-Action-Datensatz erzeugen / geprüfte Outputs | Der Workflow endet bei der Zusammenfassung statt bei der Entscheidung |
| Vollständigkeit der Übergabe an den Verantwortlichen | Ob jemand akzeptiert, ablehnt oder weitere Evidenz anfordert | Outputs mit benanntem Verantwortlichen und Entscheidungsstatus / weitergeleitete Outputs | Erkenntnisse landen in gemeinsamen Dokumenten ohne Operator |
| Eingesparte Zeit pro akzeptierter Entscheidung | Ob Geschwindigkeitsgewinne für Entscheidungen gelten, nicht nur für Entwürfe | Basale Forschungsstunden minus KI-unterstützte Stunden nur für akzeptierte Entscheidungen | Der Workflow spart womöglich Schreibzeit, fügt aber Prüf- und Reparaturzeit hinzu |
| Wiederverwendungs- und Aktualisierungsrate | Ob der Workflow wiederholt werden kann, ohne neu zu beginnen | Gespeicherte Analysen, die in späteren Entscheidungen aktualisiert oder wiederverwendet werden / geeignete Analysen | Das Team behandelt Produktforschungs-KI als einmaliges Prompting |
| Verknüpfung mit nachgelagerten Ergebnissen | Ob Entscheidungen nach der Aktion überprüft werden | KI-gestützte Entscheidungen mit einem Nachprüfungssignal und Ergebnis / KI-gestützte Entscheidungen | Das Team kann nicht lernen, welche Forschungssignale nützliche Arbeit vorhersagen |
Die Reihenfolge ist wichtig. Beginnen Sie mit Entscheidungstauglichkeit, Evidenzabdeckung, Nachvollziehbarkeit und Kohortenstabilität. Wenn diese versagen, werden spätere Metriken zu Vanity-Kennzahlen.
Beginnen Sie mit einem Entscheidungssatz
Bevor Sie Produktforschungs-KI messen, definieren Sie die Entscheidung, die sie unterstützen muss:
Wir müssen entscheiden, ob wir [bauen, verbessern, launchen, repositionieren, bündeln, aus dem Sortiment nehmen oder beobachten] [spezifisches Produkt, Feature, SKU, Listing, Wettbewerbsreaktion oder Kategorie] für [Kundensegment oder Markt] bis [Datum] [Datum] umsetzen.
Dieser Satz ist die Messgrenze. Ohne ihn kann ein Modell einen flüssigen Bericht erstellen, den niemand akzeptieren oder ablehnen kann.
Zum Beispiel:
| Schwaches Mess-Setup | Stärkeres Mess-Setup |
|---|---|
| "Analysieren Sie Bewertungen für diese Produktkategorie." | "Entscheiden Sie, ob Beschwerden über die Haltbarkeit eine überarbeitete Material-Spezifikation für den nächsten Accessoire-Launch rechtfertigen." |
| "Finden Sie Pain Points von Kunden." | "Entscheiden Sie, welche Wettbewerberbeschwerde das nächste Listing-Update prägen sollte." |
| "Fassen Sie Marktchancen zusammen." | "Entscheiden Sie, ob diese Kategorie sowohl Nachfrage als auch wiederholte, ungelöste Käuferfrustration aufweist." |
| "Erstellen Sie einen Produktforschungsbericht." | "Entscheiden Sie, ob die Roadmap die Vereinfachung der Einrichtung oder ein neues Bundle priorisieren sollte." |
Die starke Version sagt Ihnen, welche Kennzahlen wichtig sind. Sie können Evidenzabdeckung, Quellen-Traceability, Übergabe an den Verantwortlichen und das nachgelagerte Ergebnis messen. Die schwache Version misst im Wesentlichen nur, ob die KI etwas geschrieben hat.
Metric 1: Decision fitness rate
Die Decision-Fitness-Rate ist der Prozentsatz der Produktforschungs-KI-Ausgaben, die eine benannte Entscheidung beantworten.
Verwenden Sie diesen Check:
| Ausgabe-Frage | Bestehensbedingung |
|---|---|
| Nennt die Ausgabe das Produkt, die Kategorie, die SKU, das Feature, das Segment oder den Wettbewerber im Scope? | Ja, das Objekt der Entscheidung ist eindeutig |
| Sagt sie, welche Aktion in Betracht gezogen wird? | Bauen, verbessern, launchen, repositionieren, bündeln, retire, testen oder beobachten |
| Nennt sie einen Entscheidungsträger? | Produkt, E-Commerce, Growth, Gründer, Research, Support, Marketing oder Operations |
| Enthält sie eine Frist oder einen Review-Zeitpunkt? | Das Team weiß, wann die Entscheidung getroffen werden muss |
| Gibt sie eine Empfehlung plus Begründung? | Die Ausgabe tut mehr, als nur Themen aufzulisten |
Bewerten Sie einen allgemeinen Insight-Report nicht als entscheidungsgeeignet, nur weil er interessant ist. Produktforschungs-KI erhält nur dann Anerkennung, wenn ein Team die Ausgabe nutzen kann, um einen spezifischen Schritt zu treffen oder abzulehnen.
Metric 2: Evidence coverage rate
Die Evidence-Coverage fragt, ob jede akzeptierte Erkenntnis ausreichend belegt ist.
Eine Erkenntnis sollte Folgendes enthalten:
- Quellentyp, wie Bewertung, Wettbewerberbewertung, Support-Ticket, Survey-Antwort, Vertriebsnotiz, Interview, Produktanalytik oder Marktdaten
- Kohorte, einschließlich Markt, Produktset, Wettbewerber-Set, Zeitfenster, Bewertungsband, Segment und Ausschlüssen, sofern relevant
- repräsentative Quellenevidenz
- Thema oder Mechanismus
- Schweregrad oder geschäftliche Konsequenz
- Gegenbeleg oder Randbedingung
- empfohlenes nächstes Artefakt
Wenn ein Befund sagt "Käufer mögen das Setup nicht," ist das nicht abgedeckt. Wenn er sagt "Erstkäufer in den letzten 90 Tagen erwähnen in Low-Star-Bewertungen immer wieder verwirrende Setup-Anweisungen, während erfahrene Käufer sich meist über fehlende erweiterte Steuerelemente beschweren," hat das Team etwas, das es prüfen kann.
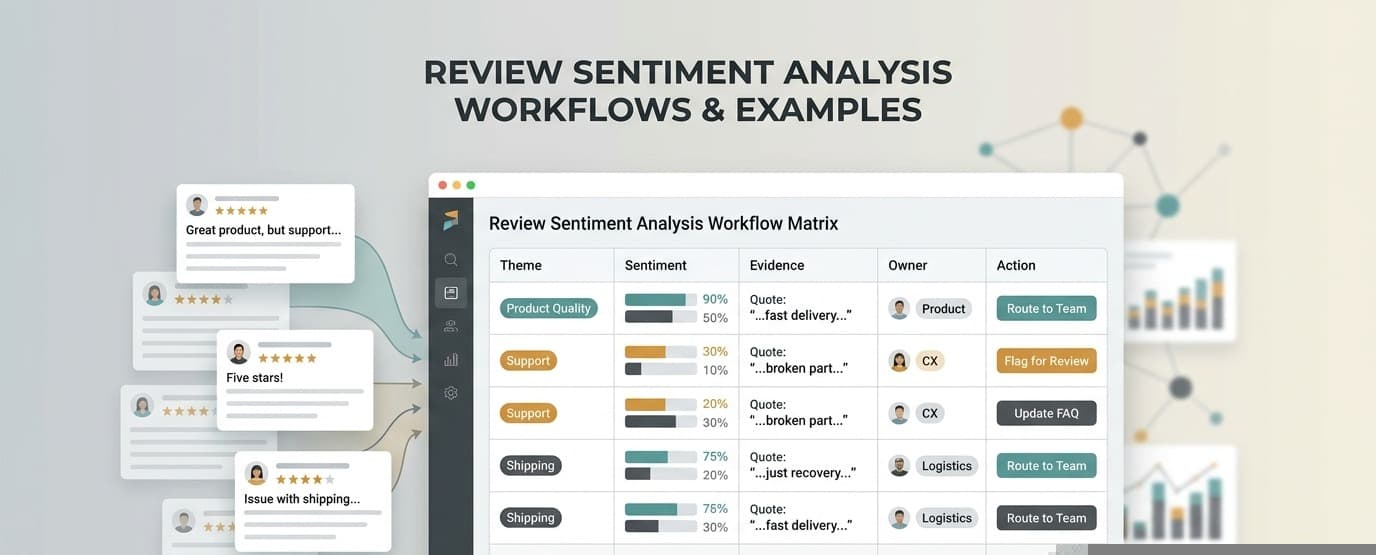
Für E-Commerce- und Marketplace-Arbeit sind Bewertungen besonders nützlich, weil sie die Sprache der Käufer bewahren. Die Product Research-Seite von VOC.AI positioniert den Workflow rund um bewertungsgestützte Nachfrage, Kategorie-Signale und Käufer-Abwägungen. Die Seite Voice of Customer Analysis stellt Kundenbewertungen als Evidenz für Produktausrichtung, Käufer-Sprache und marktreife Entscheidungen dar.
Messgröße 3: Rückverfolgbarkeitsrate
Die Rückverfolgbarkeitsrate misst, ob ein Teammitglied die Evidenz hinter einer Aussage anklicken, prüfen oder auditieren kann.
Verfolgen Sie sie auf Aussage-Ebene:
| Aussageart | Minimale Rückverfolgbarkeit |
|---|---|
| Bewertungsthema | Bewertungs-IDs, Bewertungslinks, Produkt oder ASIN, Bewertung, Datumsbereich und Beispielsprache |
| Wettbewerbslücke | Wettbewerbs-Produktset, Attribut, Bewertungs-Evidenz, Bewertungskontext und Quellenbeispiele |
| Marktchance | Kategorie, Zeitfenster, Nachfragesignal, Wettbewerbskontext und Quellenweg |
| Supportproblem | Ticket-IDs oder Exportzeilen, Kontosegment, Lebenszyklus-Moment und Schweregrad |
| Interview- oder Umfragesignal | Teilnehmersegment, Datum, Fragenkontext, Zitat oder Antwort-ID |
| API-generierte Ausgabe | Stabile Quell-IDs, Filter, Schema-Version und Wiederholungsweg |
Rückverfolgbarkeit ist keine Bürokratie. Sie verhindert, dass eine geschliffene KI-Zusammenfassung zu einer Produktanforderung wird, die niemand verteidigen kann.
Für wiederkehrende Workflows braucht Rückverfolgbarkeit Struktur. Die Review Analysis API von VOC.AI beschreibt den programmatischen Zugriff auf Review-, Keyword-, Sales- und Listing-Daten über API- und MCP-Oberflächen. Das ist relevant, wenn Teams Produktforschungs-KI-Ergebnisse in interne Dashboards, Agents oder wiederholbare Berichte einfließen lassen müssen.
Messgröße 4: Kohortenstabilität
Kohortenstabilität sagt Ihnen, ob dieselbe Frage gegen dieselbe Evidenzgrenze gestellt wird.
Protokollieren Sie diese Felder vor jedem Lauf:
| Kohortenfeld | Warum es wichtig ist |
|---|---|
| Produkt- oder SKU-Set | Verhindert das Vermischen alter Versionen, Varianten, Zubehör oder nicht zusammenhängender Produkte |
| Wettbewerbsset | Verhindert, dass Vergleichsarbeit in Richtung leichterer oder lautstärkerer Wettbewerber abdriftet |
| Marketplace oder Region | Bewertungen und Nachfrage können sich je nach Markt ändern |
| Zeitfenster | Alte Beschwerden können nach einer Behebung bestehen bleiben; neue Beschwerden können eine jüngste Änderung widerspiegeln |
| Bewertungsbereich | Ein-Stern-Bewertungen und Fünf-Sterne-Bewertungen beantworten unterschiedliche Fragen |
| Segment oder Anwendungsfall | Anfänger, Power-User, preisbewusste Käufer und Premium-Käufer wollen oft Unterschiedliches |
| Ausschlüsse | Entfernt irrelevante Ersatzteile, Versandprobleme, Spam und nicht unterstützte Kategorien |
Wenn ein erneuter Lauf die Antwort verändert, prüfe zuerst die Kohorte und erst danach das Modell. Viele KI-Fehler in der Produktforschung sind Eingrenzungsfehler auf Input-Ebene.
Metric 5: Nachfrage-Schmerz-Trennung
Produktteams müssen zwei verschiedene Dinge wissen:
- Nachfrage: Menschen kaufen, suchen, vergleichen oder treten in die Kategorie ein.
- Schmerz: Menschen sind enttäuscht genug, um sich zu beschweren, zurückzugeben, zu kündigen, zu wechseln oder nach einer besseren Version zu fragen.
Gute Produktforschungs-KI hält diese Scores getrennt, bis das Entscheidungsgespräch stattfindet.
| Situation | Was es bedeutet | Implikation für die Entscheidung |
|---|---|---|
| Hohe Nachfrage, hoher Schmerz | Die Kategorie ist aktiv und Käufer sind sichtbar unzureichend versorgt | Build-, Fix-, Bundle- oder Repositionierungsoptionen prüfen |
| Hohe Nachfrage, geringer Schmerz | Die Kategorie ist aktiv, aber die Einstiegschance könnte schwach sein | Vor einer Investition nach Differenzierung suchen |
| Geringe Nachfrage, hoher Schmerz | Das Problem ist real, rechtfertigt aber möglicherweise keinen großen Wetteinsatz | Ein Nischenangebot, eine Support-Lösung oder eine Nur-überwachen-Entscheidung in Betracht ziehen |
| Geringe Nachfrage, geringer Schmerz | Es gibt wenig aktuelle Evidenz für Maßnahmen | Ablehnen oder später erneut prüfen |
Die Market Insight-Seite von VOC.AI konzentriert sich auf Kategoriebewegungen, Umsatzschätzungen, Marktanteile, Wettbewerber-Tracking, Produktforschung und Review-Signale. Diese Marktschicht sollte Rezensionsevidenz nicht ersetzen. Sie sollte daneben stehen, damit das Team entscheiden kann, ob eine schmerzhafte Beschwerde in einem Markt liegt, bei dem sich ein Eingreifen lohnt.
Metric 6: Bewahrung von Widersprüchen
Die Bewahrung von Widersprüchen misst, ob die Produktforschungs-KI unbequeme Evidenz sichtbar hält.
Beispiele:
- Käufer beschweren sich, ein Produkt wirke schwer, andere loben dasselbe Gewicht jedoch als robust.
- Anfänger verlangen einfachere Bedienelemente, während Experten das Fehlen erweiterter Einstellungen bemängeln.
- Premium-Käufer mögen keine billigen Materialien, während Budget-Käufer einen höheren Preis ablehnen.
- Eine Funktion wird in Fünf-Sterne-Bewertungen gelobt und in Ein-Stern-Bewertungen kritisiert, weil Segmente sie unterschiedlich nutzen.
- Ein Wettbewerber gewinnt bei der Einfachheit, verliert aber bei der Haltbarkeit.
Wenn die Ausgabe diese Widersprüche entfernt, entfernt sie auch die Segmentierungs-Einsicht. Eine Erkenntnis sollte nur dann als widerspruchserhalten bewertet werden, wenn sie mindestens ein Gegenbeispiel, eine Ausnahme oder eine Segmentgrenze enthält.
Metric 7: Umsetzungsrate
Die Umsetzungsrate fragt, ob die Ausgabe ein nutzbares nächstes Artefakt erzeugt.
Verwende dieses Mapping:
| Fundungstyp | Nächstes Artefakt | Verantwortliche Person |
|---|---|---|
| Wiederholter Defekt | Defekt-Briefing mit Quellbeispielen und Schweregrad | Produkt oder Qualität |
| Fehlendes Feature | Opportunity-Briefing oder Roadmap-Kandidat | Produkt |
| Listing-Abweichung | Listing-Text-Briefing mit Käufersprache | E-Commerce oder Marketing |
| Schwäche des Wettbewerbers | Positionierungs-Briefing oder Launch-Winkel | Growth oder Produktmarketing |
| Nachfrage in der Kategorie bei schwachem Schmerz | Nur-überwachen-Eintrag mit Datum für erneute Prüfung | Gründer oder Category Owner |
| Support-Verwirrung | Support-Makro, Setup-Leitfaden oder Onboarding-Fix | Support, CX oder Lifecycle |
| Mehrdeutige Belege | Plan für Folgeinterview, Umfrage oder manuelle Prüfung | Research |
Zähle nur Outputs, die zu einem dieser Artefakte oder zu einem klaren Eintrag ohne Handlungsbedarf werden. Eine saubere Zusammenfassung ohne nächstes Artefakt sollte nicht bestehen.
Messgröße 8: Abschluss der Übergabe an die verantwortliche Person
Der Abschluss der Übergabe an die verantwortliche Person ist einfach: Hat jemand akzeptiert, abgelehnt oder um weitere Belege gebeten?
Verfolge vier Zustände:
| Zustand | Bedeutung |
|---|---|
| Akzeptiert | Die verantwortliche Person wird auf den Output reagieren |
| Abgelehnt | Die verantwortliche Person hat die Belege geprüft und keine Maßnahme gewählt |
| Benötigt mehr Belege | Die verantwortliche Person hat den fehlenden Nachweis benannt |
| Ohne Verantwortliche Person | Niemand ist für die Entscheidung verantwortlich |
Fundungen ohne verantwortliche Person sind kein Backlog. Sie sind Verschwendung. Produktforschungs-KI sollte Mehrdeutigkeit reduzieren, nicht eine weitere Warteschlange interessanter Kommentare erzeugen.
Messgröße 9: Gesparte Zeit pro akzeptierter Entscheidung
Die meisten Teams messen KI-Zeitersparnis zu früh. Sie vergleichen „Stunden für das Erstellen eines Berichts“ mit „Minuten für das Erzeugen einer Zusammenfassung“. Das lässt die Reparaturkosten außer Acht.
Messe nur akzeptierte Entscheidungen:
Gesparte Zeit pro akzeptierter Entscheidung = Basislinie der Forschungsstunden - KI-unterstützte Stunden, einschließlich Einrichtung, Bereinigung, Prüfung, Korrektur, Abstimmung mit der verantwortlichen Person und Erstellung des finalen Artefakts.
Wenn ein Bericht 15 Minuten braucht, um generiert zu werden, aber drei Stunden zur Reparatur, hat der Workflow nicht drei Stunden gespart. Er hat die Arbeit verlagert.
Messgröße 10: Wiederverwendungs- und Aktualisierungsrate
Produktforschungs-KI sollte zukünftige Entscheidungen einfacher machen.
Verfolge, ob gespeicherte Analysen wiederverwendet werden können:
- Kann derselbe Kohorten-Stand nächsten Monat aktualisiert werden?
- Kann ein Teammitglied den Workflow erneut ausführen, ohne den ursprünglichen Prompt-Autor?
- Kann der Output zu einer wiederkehrenden Scorecard, Watchlist oder Eingabe für ein Produkt-Review-Meeting werden?
- Kann das Team „was sich geändert hat“ vergleichen, statt mit einem leeren Prompt zu beginnen?
- Können Quell-IDs, Filter und Outputs exportiert oder in ein anderes System weitergeleitet werden?
Wiederverwendung ist besonders wichtig, wenn Produktforschung kein einmaliges Projekt ist. Wenn dein Team jede Woche Bewertungen, Wettbewerber, Kategorien und Support-Muster scannt, sind gespeicherte Kohorten und wiederholbare Outputs Teil des Werts.
Messgröße 11: Verknüpfung mit nachgelagerten Ergebnissen
Die Verknüpfung mit nachgelagerten Ergebnissen ist die Feedback-Schleife, nachdem das Team handelt.
Für jede akzeptierte Entscheidung notiere:
| Feld | Beispiel |
|---|---|
| Entscheidung | Vereinfachung des Setups priorisieren statt eines neuen Bundles |
| Belege | Aktuelle Themen aus Bewertungen mit niedriger Sternebewertung, Support-Tickets, Wettbewerbsvergleiche |
| Maßnahme | Setup-Flow, Listing-Text und Support-Makro aktualisieren |
| Erwartetes Signal | Weniger Beschwerden zum Setup in der nächsten Review-Kohorte |
| Datum der erneuten Prüfung | 30 oder 60 Tage nach der Änderung |
| Ergebnis | Verbessert, unverändert, verschlechtert oder nicht schlüssig |
| Erkenntnis | Welche Quelle das Ergebnis am besten vorhergesagt hat |
Beanspruchen Sie keine Kausalität zu stark. Ein Output einer Produktforschungs-KI "beweist" nicht, dass ein späteres Ergebnis aufgrund der Empfehlung eingetreten ist. Die Kennzahl sagt nur, ob das Team das nächste Signal überprüft und daraus gelernt hat.
Schlechte Kennzahlen, die ersetzt werden sollten
Manche Kennzahlen wirken nützlich, weil sie leicht zu zählen sind. Ersetzen Sie sie durch Entscheidungskennzahlen.
| Schlechte Kennzahl | Warum sie in die Irre führt | Ersetzen durch |
|---|---|---|
| Anzahl der gefundenen Themen | Mehr Themen können weniger Fokus bedeuten | Entscheidungs-Fit-Rate |
| Durchschnittlicher Sentiment-Score | Sentiment erklärt nicht, was gebaut oder behoben werden soll | Abdeckung der Belege und Umsetzbarkeitsrate |
| Anzahl der verarbeiteten Bewertungen | Allein die Menge beweist keine Qualität | Nachvollziehbarkeitsrate und Kohortenstabilität |
| Prompt-Anzahl | Aktivität ist kein Fortschritt bei Entscheidungen | Vollständigkeit der Übergabe an den Verantwortlichen |
| Dashboard-Logins | Nutzung kann passives Durchstöbern sein | Akzeptierte Entscheidungen und nachgelagerte Nachprüfungen |
| Geschwindigkeit der Berichtserstellung | Schnelle Entwürfe können dennoch aufwändige Nacharbeit erfordern | Pro akzeptierter Entscheidung eingesparte Zeit |
| Anzahl der Empfehlungen | Empfehlungen ohne Belege schaffen Risiken | Erhalt von Widersprüchen und Nachvollziehbarkeit |
Es geht nicht darum, Effizienz zu ignorieren. Es geht darum, Effizienz erst dann zu messen, wenn die Belege und die Entscheidungsqualität tatsächlich gut sind.
Ein 14-tägiger Pilot für KI-Kennzahlen in der Produktforschung
Nutzen Sie diesen Pilot, bevor Sie entscheiden, ob der Workflow weitere Investitionen verdient.
| Tag | Arbeit | Ergebnis |
|---|---|---|
| 1 | Wählen Sie eine Produktentscheidung aus, die in den nächsten 30 Tagen fällig ist | Entscheidungssatz |
| 2 | Sperren Sie die Evidenz-Kohorte | Produktmenge, Wettbewerbermenge, Quellenliste, Zeitfenster, Ausschlüsse |
| 3-4 | Führen Sie den Produktforschungs-KI-Workflow aus | Entwurfsbefunde mit Evidenz |
| 5 | Prüfen Sie Nachvollziehbarkeit und Abdeckung | Quellenprüfung auf Behauptungsebene |
| 6 | Fügen Sie einen Widerspruchs-Durchgang hinzu | Gegenbelege und Segmentgrenzen |
| 7 | Wandeln Sie die Befunde in ein nachgelagertes Artefakt um | PRD, Listing-Brief, Roadmap-Notiz, Testplan, Support-Makro oder No-Action-Protokoll |
| 8 | Leiten Sie es an den Verantwortlichen weiter | Akzeptieren, ablehnen oder weitere Evidenz anfordern |
| 9-10 | Beheben Sie nur, was der Verantwortliche benötigt | Abschließendes Entscheidungspaket |
| 11 | Bewerten Sie die eingesparte Zeit gegenüber der Baseline | Zeitberechnung für akzeptierte Entscheidungen |
| 12 | Speichern Sie die Kohorte und die Workflow-Eingaben | Wiederholungsbereiter Datensatz |
| 13 | Definieren Sie das nachgelagerte Signal | Erneute Prüfung von Metrik und Datum |
| 14 | Entscheiden Sie, ob der Workflow beibehalten, geändert oder gestoppt werden soll | Pilot-Scorecard |
Der Pilot ist nur erfolgreich, wenn der Verantwortliche eine Entscheidung treffen oder ablehnen kann. Wenn das Ergebnis ein besseres Forschungsarchiv ist, muss der Produktforschungs-KI-Workflow weiter verbessert werden.
Vorlage für die Produktforschungs-KI-Scorecard
Verwenden Sie diese Scorecard im Pilotprojekt. Bewerten Sie jede Zeile von 0 bis 3.
| Metrik | Gewichtung | 0 bedeutet | 3 bedeutet |
|---|---|---|---|
| Entscheidungsfit-Rate | 15% | Die Ausgabe ist nicht an eine benannte Entscheidung gebunden | Die Ausgabe beantwortet direkt einen Entscheidungssatz |
| Abdeckungsrate der Evidenz | 15% | Themen haben wenig Quellenkontext | Erkenntnisse enthalten Quellenevidenz, Kohorte, Schweregrad und Gegenbelege |
| Nachverfolgbarkeitsrate | 15% | Behauptungen können nicht überprüft werden | Wichtige Behauptungen lassen sich auf Quelllinks, IDs, Zeilen oder Prüfbeispiele zurückverfolgen |
| Kohortenstabilität | 10% | Eingaben driften zwischen Läufen | Kohortenfelder sind gesperrt und erneut ausführbar |
| Trennung von Nachfrage und Schmerz | 10% | Nachfrage- und Beschwerdesignale werden zusammengeführt | Marktnachfrage und Käuferprobleme werden separat bewertet |
| Erhalt von Widersprüchen | 10% | Die Ausgabe verbirgt Uneinigkeit | Segmentgrenzen und Gegenbeispiele sind sichtbar |
| Aktionsfähigkeitsrate | 10% | Die Ausgabe endet bei der Zusammenfassung | Die Ausgabe wird zu einem benannten nächsten Artefakt oder zu einem No-Action-Datensatz |
| Abschluss der Übergabe an den Verantwortlichen | 5% | Niemand akzeptiert oder lehnt die Erkenntnis ab | Der Verantwortlichkeitsstatus wird erfasst |
| Gesparte Zeit pro akzeptierter Entscheidung | 5% | Der Nacharbeitsaufwand macht Zeitgewinne zunichte | Akzeptierte Entscheidungen benötigen insgesamt weniger Teamzeit |
| Wiederverwendungs- und Aktualisierungsrate | 3% | Der Workflow ist einmalig | Kohorte und Prompts können aktualisiert werden |
| Verknüpfung mit nachgelagerten Ergebnissen | 2% | Keine Nachprüfung ist geplant | Erwartetes Signal und Nachprüfdatum werden erfasst |
Mitteln Sie einen Nullwert bei Nachverfolgbarkeit, Evidenzabdeckung oder Kohortenstabilität nicht weg. Das sind Blocker. Ein KI-Workflow für die Produktforschung, der seine Arbeit nicht zeigen kann, ist nicht bereit für ernsthafte Produktentscheidungen.
Wie VOC.AI in dieses Messmodell passt
VOC.AI passt in die Messung von KI für Produktforschung, wenn Kundenbewertungen, Wettbewerbsdaten, Marktkontext und wiederholbare Workflows wichtig sind.
- Verwenden Sie Product Research, wenn die Entscheidung lautet, was als Nächstes entwickelt, verbessert, getestet, verpackt oder neu positioniert werden soll.
- Verwenden Sie Market Insight, wenn das Team Kategoriebewegungen, Markanteilskontext, Umsatzschätzungen, Wettbewerbsverfolgung, Produktforschung und Bewertungssignale neben den Bewertungsevidenzen benötigt.
- Verwenden Sie Voice of Customer Analysis, wenn das Team Themen aus Kundenbewertungen, die Sprache der Käufer, Pain Points, Erwartungen und die Produktausrichtung benötigt.
- Verwenden Sie Review Analysis API, wenn der Workflow strukturierte Bewertungs-, Keyword-, Umsatz- und Listing-Daten in internen Tools, Agents oder wiederkehrenden Berichten benötigt.
- Verwenden Sie Pricing, wenn das Team entscheidet, welche Plattform-, API- oder MCP-Option zum Pilotprojekt und zum wiederkehrenden Workflow passt.
Das bedeutet nicht, dass VOC.AI in jedem Produktforschungs-KI-Workflow die einzige Quelle sein sollte. Wenn die Entscheidung von Produkt-Telemetrie, Finanzdaten, Fertigungsbeschränkungen, Offline-Interviews oder Unternehmens-CRM-Daten abhängt, verbinden Sie auch diese Systeme. Verwenden Sie VOC.AI dort, wo Käuferbewertungen, Marktkontext, Wettbewerber-Lücken und durch Bewertungen gestützte Produktevidenz die fehlende Ebene sind.
FAQ
Welche Kennzahlen sind für Produktforschungs-KI am wichtigsten?
Beginnen Sie mit Entscheidungstauglichkeit, Evidenzabdeckung, Nachverfolgbarkeit, Kohortenstabilität, Trennung von Nachfrage und Schmerzpunkt, Erhalt von Widersprüchen, Umsetzbarkeit, Übergabe an den Verantwortlichen, gesparte Zeit pro akzeptierter Entscheidung, Wiederverwendung und der Verknüpfung mit nachgelagerten Ergebnissen.
Welche Kennzahl sollte man zuerst prüfen?
Entscheidungstauglichkeit. Wenn das Ergebnis nicht an eine benannte Produktentscheidung gekoppelt ist, sind die übrigen Kennzahlen verfrüht.
Sollte Produktforschungs-KI an der eingesparten Zeit gemessen werden?
Ja, aber erst nachdem die Entscheidung akzeptiert wurde. Messen Sie die insgesamt pro akzeptierter Entscheidung eingesparte Zeit, einschließlich Einrichtung, Bereinigung, Prüfung, Korrekturen und Erstellung des finalen Artefakts.
Wie misst man die Evidenzqualität in Produktforschungs-KI?
Prüfen Sie, ob jede akzeptierte Erkenntnis Quellenbeispiele, Quellentyp, Kohortendefinition, Schweregrad, Gegenbelege und einen Weg zurück zur zugrunde liegenden Bewertung, dem Ticket, dem Interview, der Umfrageantwort oder der Datenzeile enthält.
Was ist eine schlechte Kennzahl für Produktforschungs-KI?
Die Anzahl der Themen ist in der Regel eine schlechte Kennzahl. Zehn nicht gestützte Themen sind weniger nützlich als eine Erkenntnis mit klarer Evidenz, einem benannten Verantwortlichen, einem nächsten Artefakt und einem Datum für die erneute Prüfung.
Wie oft sollten Teams die Ergebnisse der Produktforschungs-KI aktualisieren?
Aktualisieren Sie das Ergebnis, wenn sich die Evidenz ändert oder wenn die Entscheidung ihr Prüfdatum erreicht. Für schnelllebige E-Commerce-Kategorien sollten viele Teams nach Änderungen an Listings, Konkurrenzstarts, Bewertungsverschiebungen, Support-Spitzen oder neuen Bewertungskohorten erneut prüfen.
Fazit
Kennzahlen für Produktforschungs-KI sollten Entscheidungen messen, nicht Aktivität.
Beginnen Sie mit einem Entscheidungssatz. Sperren Sie die Evidenzkohorte. Verlangen Sie quellenbasierte Erkenntnisse. Bewahren Sie Widersprüche. Leiten Sie das Ergebnis an einen Verantwortlichen weiter. Messen Sie die eingesparte Zeit nur bei akzeptierten Entscheidungen. Prüfen Sie dann das nachgelagerte Signal erneut, nachdem das Team gehandelt hat.
So wird Produktforschungs-KI zu einem wiederholbaren Entscheidungs-Workflow statt zu einer weiteren schnellen Möglichkeit, einen Forschungsbericht zu erstellen.