L’analyse des avis Amazon ne devrait pas se contenter de résumer une pile de commentaires. Pour les équipes qui recherchent une analyse des avis Amazon : comparaison et alternatives, la vraie question est de savoir quelle approche peut vous aider à décider ce qu’il faut changer, ce qu’il faut examiner et à quoi il ne faut pas réagir de manière excessive.
C’est pourquoi la meilleure alternative n’est pas toujours le produit qui possède la liste de fonctionnalités la plus longue. Un tableur peut suffire pour une décision de lancement. Les outils natifs d’Amazon peuvent couvrir une question liée à une catégorie. Une plateforme spécialisée d’analyse des avis peut être plus pertinente lorsque plusieurs équipes ont besoin de preuves reproductibles. Un pipeline API peut être justifié lorsque les informations issues des avis doivent circuler dans vos propres systèmes.
Mis à jour le 11 août 2026, ce guide compare six approches de l’analyse des avis Amazon selon les tâches qu’elles peuvent prendre en charge de manière fiable :
- Lecture manuelle et tableurs
- Assistants IA à usage général
- Insights natifs d’Amazon sur les avis
- Suites Amazon seller généralistes
- Plateformes spécialisées d’analyse des avis
- Pipelines API personnalisés
L’objectif n’est pas de couronner un gagnant universel. Il s’agit de vous aider à choisir l’approche la plus légère capable de répondre à votre question de décision sans masquer les preuves. Vous obtiendrez également une méthode pour réduire une longue liste à trois à cinq finalistes, les noter avec des pondérations spécifiques à la décision, évaluer la reproductibilité, estimer le coût d’exploitation, tester les options natives/alimentées par API, tester l’exportabilité, exécuter un script de démonstration fournisseur et transférer le gagnant en production sans verrouillage évitable.
La mise à jour du 11 août ajoute une couche de renouvellement et de remplacement : une façon pratique de décider s’il faut conserver le flux de travail actuel, le restreindre à une couverture native Amazon, ajouter une couche spécialisée, ou le remplacer par un processus piloté par API. Les analyses d’avis natives d’Amazon et des seller suites sont de plus en plus liées aux surfaces de retour client propres à Amazon et aux contrats API ; la première question porte donc moins sur la capacité d’un outil à afficher des sujets que sur sa capacité à préserver le corpus, les preuves, le dénominateur, la logique de comparaison, la transmission et la piste de migration dont votre équipe a besoin après l’apparition du résumé natif.
Que comparer en premier : l’interface, les preuves ou le modèle d’exploitation ?
La plupart des acheteurs commencent par des captures d’écran de l’interface parce qu’elles sont faciles à comparer. C’est la mauvaise première couche pour l’analyse des avis Amazon. Une interface soignée peut néanmoins masquer l’ensemble des avis, fusionner des plaintes distinctes ou établir des comparaisons avec des fenêtres incohérentes.
Utilisez plutôt cet ordre.
| Couche d'achat | À quoi cela répond | À inspecter | Mode d'échec si omis |
|---|---|---|---|
| Modèle opérationnel | Qui possède l'accès aux données, la taxonomie, l'assurance qualité et le travail récurrent ? | Outil natif, suite, plateforme spécialisée, flux de travail assisté par IA ou pipeline API | L'équipe achète un outil qui ne correspond pas au rythme ou au responsable |
| Couche de preuve | Chaque constat important peut-il être retracé jusqu'aux avis sources et aux règles de dénominateur ? | Manifeste du corpus, extraits d'avis, notes de confiance, contre-exemples, fenêtres de dates et filtres | Les parties prenantes contestent les conclusions et les analystes reconstruisent le travail manuellement |
| Couche de décision | La sortie peut-elle devenir un véritable artefact d'action ? | Brief produit, brief de listing, rapport qualité, tableau des écarts concurrents, alerte, ticket ou réponse API | Le tableau de bord est intéressant mais ne modifie pas ce que fait l'équipe |
| Couche de sortie | L'équipe peut-elle partir sans perdre la taxonomie, les preuves ou l'historique ? | Exports, schéma, ID, historique des versions et répétition de la migration | Le flux de travail choisi devient coûteux à modifier même si la qualité se dégrade |
Cet ordre change la façon dont vous comparez les alternatives. Les tableurs manuels peuvent battre un outil lorsque la décision est étroite et que l'analyste doit lire chaque avis. Une suite vendeur plus large peut battre un outil spécialisé lorsque les flux de travail de mots-clés et de fiches produits comptent davantage qu'une preuve approfondie issue des retours. Un outil spécialisé peut battre les deux lorsque l'intelligence des avis constitue un apport hebdomadaire interfonctionnel. Un pipeline API peut battre la catégorie des interfaces lorsque la destination est un système interne.
Mise à jour du marché d'août 2026 : comparer les sujets natifs séparément des preuves de décision
Les comparaisons d'analytics des avis Amazon séparaient autrefois clairement les « outils natifs » des « outils vendeurs tiers ». Cette frontière est moins nette aujourd'hui. L'API officielle Customer Feedback d'Amazon expose des sujets agrégés de retours clients pour les workflows ASIN éligibles, et la documentation actuelle de Review Insights de Helium 10 indique que la fonctionnalité est alimentée par l'API Customer Feedback d'Amazon. En d'autres termes, un module d'avis d'une suite vendeur peut désormais être plus proche d'une couche de sujets native d'Amazon que d'un workflow de fouille d'avis totalement indépendant.
C'est utile, mais cela change l'évaluation. Les résumés de sujets alimentés par une API peuvent réduire les frictions de configuration et améliorer la légitimité de la plateforme. Ils ne répondent pas automatiquement à la question de savoir si votre équipe peut auditer chaque affirmation, comparer les concurrents avec le même dénominateur, exporter les preuves ou relier les enseignements issus des avis à une décision produit, listing, qualité ou surveillance.
Utilisez cette distinction avant de présélectionner les outils.
| Couche | Ce qu’elle prouve | Ce qu’elle ne prouve pas |
|---|---|---|
| Couche de sujets native | Amazon a reconnu des sujets positifs ou négatifs, des extraits d’avis, l’impact sur les notes, des tendances ou des données de sujets renvoyées par l’API pour le contexte ASIN éligible | Que le workflow prend en charge votre taxonomie personnalisée, votre dénominateur concurrent multi-ASIN, les preuves multicanales ou les exigences d’exportation / d’audit |
| Workflow de suite vendeur | La vue des avis se trouve à côté des outils de mots-clés, de listing, de recherche produit ou d’opérations que votre équipe utilise peut-être déjà | Que l’analytique des avis est suffisamment approfondie pour constituer un système d’insights récurrent plutôt qu’un simple module de soutien |
| Couche d’analytique spécialisée | Le système est conçu autour de la synthèse récurrente des preuves, de la traçabilité, de la comparaison et du transfert | Qu’il remplace toutes les tâches d’une suite vendeur, ou qu’il doive l’emporter lorsqu’une vue native répond déjà à une question précise |
| Couche API ou entrepôt de données | L’organisation peut intégrer des sujets d’avis ou des champs analysés dans ses propres systèmes | Que la responsabilité d’ingénierie, l’assurance qualité, le stockage des preuves et la maintenance coûtent moins cher que l’achat d’un workflow maintenu |
Pour le travail sur l’analytique des avis Amazon : comparaison et alternatives, voici l’implication pratique : ne considérez pas « alimenté par les données Amazon » comme un facteur éliminatoire ni comme une réponse complète. Considérez-le comme une couche de source parmi d’autres. Le gagnant doit encore réussir le dossier de preuves, le test d’acceptation, le modèle de coût et l’exercice de réversibilité ci-dessous.
Dossier de preuves minimal viable
Avant de lancer les démonstrations, définissez le dossier de preuves que chaque alternative doit produire. Ce dossier doit être assez compact pour être créé en une seule session de travail, tout en étant suffisamment complet pour qu’un responsable produit, marketing, qualité ou opérations puisse le remettre en question.
| Champ du dossier | Norme requise |
|---|---|
| Manifeste du corpus | ASIN, marketplace, date d’extraction, nombre d’avis, fenêtre de dates, filtres d’étoiles, filtres de langue, gestion des variantes et exclusions |
| Table des thèmes | Thèmes classés avec libellés en langage clair, mécanisme, sentiment, produit ou concurrent concerné, et nombre ou part avec dénominateur |
| Annexe de preuves | Extraits exacts d’avis pour les principales affirmations, au moins un contre-exemple par thème majeur, note, date, ASIN, marketplace et identifiant de source lorsque disponible |
| Vue des changements récents | Une période récente comparée à une période de référence en utilisant la même taxonomie et un dénominateur visible |
| Artefact de décision | Une sortie concrète : brief de copy de fiche, mémo sur un problème produit, tableau d’écarts concurrentiels, enquête qualité, alerte de surveillance ou réponse API |
| Journal des incertitudes | Avis ambigus, preuves faibles, schémas suspects, désaccords de taxonomie et affirmations nécessitant une validation par le support, les retours ou les données de ventes |
| Note de reproduction | Les paramètres, le prompt, la vue enregistrée, la requête ou la version du workflow nécessaires à un autre analyste pour relancer la même analyse |
Si une alternative ne peut pas produire ce dossier, elle peut malgré tout être utile pour l’exploration, mais elle ne doit pas être considérée comme un système d’analytique des avis prêt pour la production.
Pack d’approvisionnement d’août 2026 : quoi collecter avant la réunion de présélection
La plupart des comparaisons d’outils d’analyse des avis Amazon s’arrêtent à un tableau de fonctionnalités. Ce n’est pas suffisant pour une enquête commerciale. Un acheteur a besoin d’un dossier permettant aux parties prenantes produit, e-commerce, recherche, opérations, ingénierie et sécurité d’examiner les mêmes éléments de preuve avant qu’un finaliste ne soit retenu.
Préparez le dossier avant la réunion de sélection, et non après que les achats aient émotionnellement choisi un gagnant.
| Section du dossier | À inclure | Pourquoi cela modifie la comparaison |
|---|---|---|
| Question de décision | Une décision que le workflow doit prendre en charge, comme une note sur un problème produit, un brief sur la langue d’une fiche, un rapport d’écart concurrentiel ou une alerte de surveillance | Empêche les fournisseurs d’optimiser la démonstration autour de tableaux de bord génériques |
| Périmètre du produit | ASIN cibles, ASIN concurrents, marketplace, langue, fenêtre de dates, gestion des variations enfant et objectif de nombre d’avis | Rend les lacunes de couverture visibles avant le début de la preuve |
| Règle de preuve | Texte exact de l’avis, ID source lorsque disponible, ASIN, note, date, marketplace, filtre, dénominateur et attentes concernant les contre-exemples | Sépare l’analytique des résumés invérifiables |
| Référence native | Ce que les informations d’avis natives d’Amazon ou les données de sujets de l’API Customer Feedback fournissent déjà pour le même périmètre produit | Évite à l’équipe de payer pour un workflow qui ne fait que reconditionner une base déjà disponible |
| Justification de la sélection | Pourquoi chaque finaliste reste dans la comparaison : natif, suite vendeur, plateforme spécialisée, workflow assisté par l’IA ou pipeline API | Maintient un équilibre entre les modèles opérationnels au lieu de cinq tableaux de bord similaires |
| Éléments de démonstration | Les captures d’écran sont autorisées, mais chaque finaliste doit aussi fournir un export, un brief, un tableau, une alerte, un ticket ou un exemple d’API pouvant être examiné hors de l’appel | Teste si le workflow fonctionne en dehors de l’interface |
| Notes des parties prenantes | Objections des équipes produit, référencement, qualité, support, recherche, ingénierie et sécurité, avec responsable et statut de suivi | Rend le processus d’achat transversal sans le transformer en consensus flou |
| Résultat du filtre | Réussi, réussi sous conditions ou échec pour la couverture, la traçabilité, la logique de comparaison, la logique de tendance, la sortie du workflow, la gouvernance, le coût et la capacité de sortie | Empêche qu’un score total élevé masque une faiblesse éliminatoire |
Le dossier doit être suffisamment court pour être examiné en une seule réunion. S’il faut une journée pour l’expliquer, la comparaison est encore trop abstraite.
Utilisez un ordre du jour de revue des parties prenantes
Animez la réunion de sélection avec un ordre du jour fixe :
- Confirmez la question de décision. Si les parties prenantes ne sont pas d’accord sur la décision, suspendez la comparaison des outils.
- Examinez la référence native. Identifiez quelles questions les sujets natifs Amazon, les extraits, les tendances ou les données de sujets renvoyées par l’API répondent déjà.
- Examinez le dossier de preuves. Ouvrez au moins trois avis sources derrière les principales affirmations et un contre-exemple.
- Mettez la comparaison à l’épreuve. Demandez-vous si le produit focal et les produits concurrents utilisent le même dénominateur, la même fenêtre et la même taxonomie.
- Examinez l’artefact de sortie. Déterminez si un responsable non analyste pourrait agir à partir de celui-ci sans reconstruire le travail.
- Vérifiez la responsabilité opérationnelle. Identifiez qui maintient la taxonomie, l’assurance qualité, les exportations, les alertes, les intégrations, les autorisations et les relances.
- Définissez les seuils de preuve. Décidez quelle défaillance éliminerait le finaliste pendant la preuve de 14 jours.
Ce programme est délibérément pratique. Il fait passer la conversation de « quel outil est le meilleur ? » à « quel modèle opérationnel peut produire un artefact de décision défendable pour notre gamme de produits ? »
Ajoutez des questions spécifiques aux parties prenantes
Différentes parties prenantes doivent remettre en question différentes parties du flux de travail d’analyse des avis Amazon.
| Partie prenante | Question à poser | Preuve qui devrait la satisfaire |
|---|---|---|
| Chef de produit | Quel thème modifie la feuille de route, et quels avis prouvent le mécanisme ? | Tableau des thèmes avec preuves exactes des avis, contre-exemples, niveau de confiance et recommandation prête pour le responsable |
| Responsable e-commerce ou de la fiche produit | Quelles formulations d’acheteurs devraient influencer le titre, les puces, les images ou le contenu A+ ? | Groupes de phrases textuelles avec note, date, ASIN, place de marché et notes de décision |
| Responsable qualité ou opérations | Le problème est-il lié à la conception du produit, à l’emballage, à l’exécution, aux attentes ou à l’utilisation ? | Mécanismes de réclamation segmentés, vue des changements récents, contexte des variantes et questions de validation ouvertes |
| Responsable recherche ou insights | La taxonomie préserve-t-elle le sens à travers les produits et le temps ? | Codebook, échantillon de référence codé par des humains, journal des désaccords et résultat de répétabilité |
| Responsable ingénierie ou données | Les données peuvent-elles être transférées vers les systèmes internes sans perte de preuves ? | Schéma d’exportation, échantillon d’API, identifiants, horodatages, versioning, limites et comportement des erreurs |
| Relecteur sécurité ou conformité | L’accès, la conservation, les autorisations, l’historique d’audit et les pratiques de traitement des avis sont-ils acceptables ? | Documentation du fournisseur, contrôles de rôle, comportement de suppression, notes sur le flux de données et exceptions de politique |
| Acheteur finance ou opérations | Le flux de travail réduit-il suffisamment le travail répété pour justifier le coût ? | Modèle de coût opérationnel annuel, estimation de configuration, estimation d’assurance qualité et coût par artefact de décision accepté |
Si un finaliste ne peut pas satisfaire une question d’une partie prenante, nommez précisément l’écart. Un champ API manquant, un périmètre de place de marché flou ou une annexe de preuves impossible à exporter sont plus faciles à résoudre qu’une préoccupation vague selon laquelle l’outil semble incomplet.
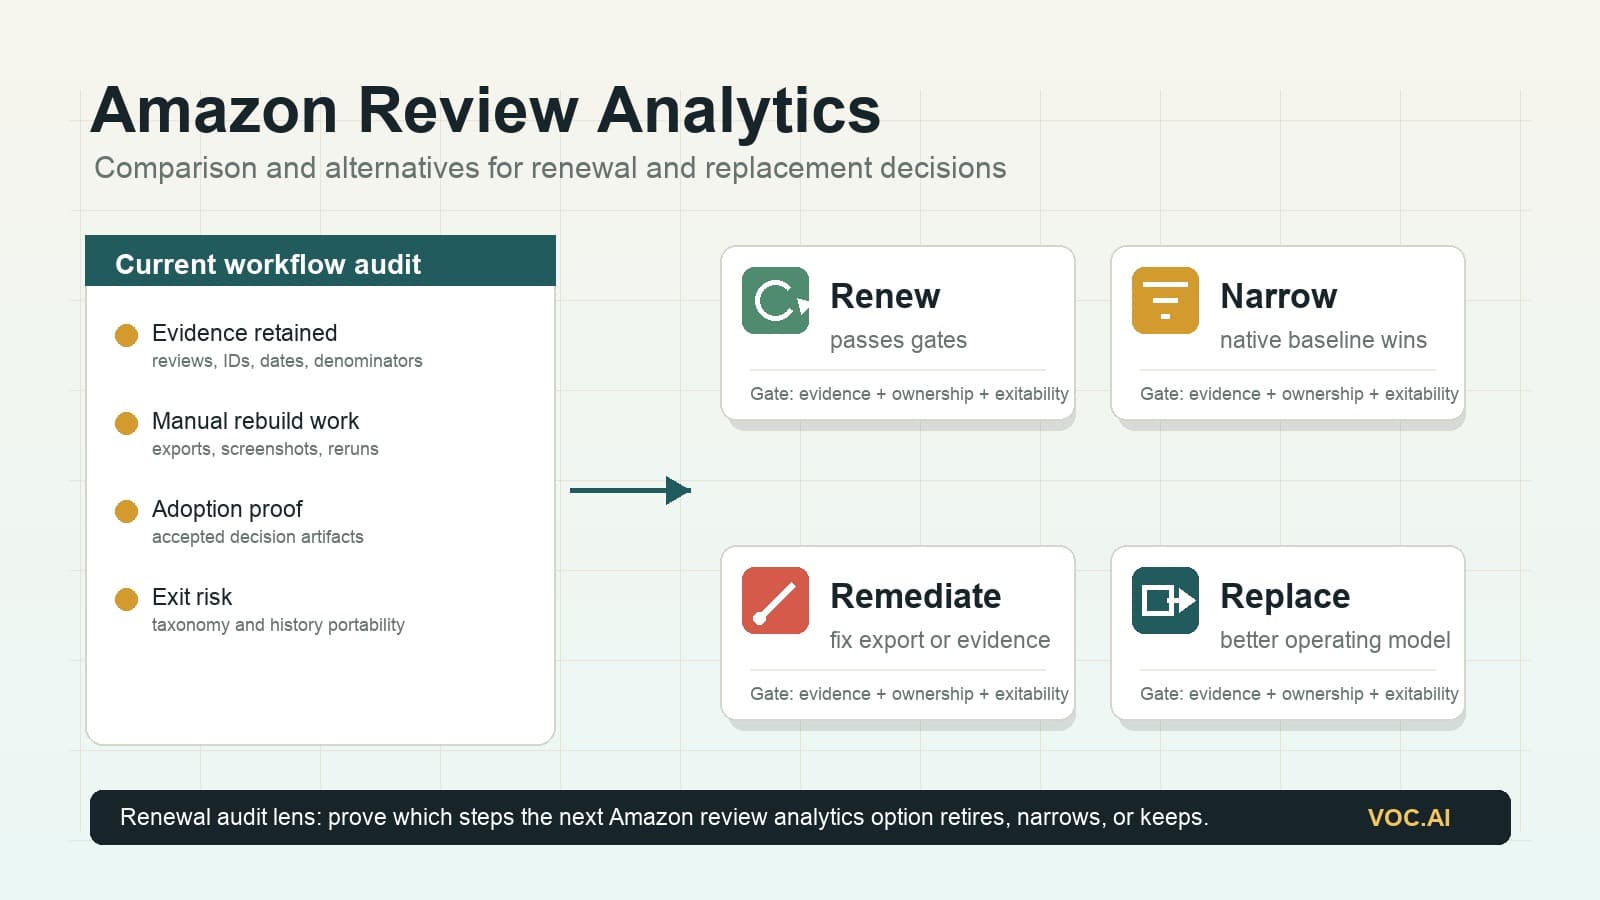
Audit de renouvellement d’août 2026 : décider s’il faut conserver, réduire, ajouter ou remplacer
De nombreuses équipes n’en arrivent pas à l’analyse des avis Amazon : comparaison et alternatives avec une page blanche. Elles disposent déjà d’un tableur, d’un module de suite vendeur, d’un workflow natif Amazon, d’un résumé d’avis ou d’un pipeline interne à moitié terminé. La question la plus difficile n’est pas « Quel outil devons-nous acheter ? » Elle est : « Avons-nous suffisamment de preuves pour renouveler le workflow actuel, ou devons-nous en remplacer une partie ? »
Réalisez un audit de renouvellement 30 à 45 jours avant l’échéance du contrat, la planification annuelle ou un examen majeur d’une gamme de produits. L’audit doit utiliser le même niveau de preuve qu’un nouvel achat, mais il doit aussi examiner la continuité historique : quelles taxonomies, quels liens entre sources et avis, quels exports, tableaux de bord, alertes et décisions survivraient si le workflow changeait.
| Résultat du renouvellement | Décision qu’il suggère | Ce qu’il faut inspecter avant d’agir |
|---|---|---|
| Les sujets natifs Amazon répondent à la principale question produit et les parties prenantes utilisent rarement des résultats plus approfondis | Resserrer le workflow autour d’insights d’avis natifs Amazon ou de sujets alimentés par API | Éligibilité, couverture des places de marché, fraîcheur des sujets, besoins d’export, et si la vue native conserve encore suffisamment de preuves de décision |
| L’analyse des avis de la suite vendeur n’est utile que lorsqu’elle est associée à des workflows de mots-clés, de listing ou de recherche produit | La conserver comme module de support, et non comme système de référence | Si les preuves d’avis peuvent encore être exportées, citées et comparées en dehors de la suite |
| Les analystes reconstruisent manuellement les annexes de preuves après chaque revue de tableau de bord | Ajouter une couche spécialisée d’intelligence des avis ou refondre le workflow de preuves | Traçabilité des thèmes, identifiants au niveau des avis, schéma d’export, vues enregistrées et délai de passation au propriétaire |
| Les équipes produit, qualité et listing utilisent des taxonomies différentes pour les mêmes avis | Consolider la taxonomie et l’assurance qualité avant d’étendre les outils | Propriété du codebook, journaux de désaccords, versioning des libellés et cartographie des anciens libellés vers les nouveaux |
| Les équipes internes ont besoin des données d’avis dans le BI, les tickets, les alertes ou des modèles propriétaires | Comparer l’accès API spécialisé à un pipeline personnalisé | Champs API, limites de débit, historique des requêtes, stockage des preuves, versioning du schéma et propriété technique |
| Les coûts augmentent mais les artefacts de décision acceptés restent stables | Renégocier, réduire le périmètre ou remplacer | Coût de la licence/API, heures analystes, temps d’assurance qualité, temps d’ingénierie, ASIN surveillés et livrables acceptés par mois |
L’audit de renouvellement évite un échec courant : renouveler un outil parce qu’il produit encore des tableaux de bord attrayants alors que le workflow de décision réel a migré ailleurs. Si les preuves ne sont plus utilisées, le workflow n’est pas simplement peu adopté. Ce n’est plus le bon modèle opérationnel.
Utilisez un registre des preuves de l’état actuel
Avant de comparer les options de remplacement, dressez l’inventaire de ce que fait déjà le workflow actuel. Utilisez une ligne par décision récurrente, et non une ligne par fonctionnalité.
| Champ du registre | Que consigner |
|---|---|
| Décision | Révision du produit, réécriture de l’annonce, écart concurrentiel, enquête qualité, alerte de suivi ou compte rendu exécutif |
| Entrée actuelle | Vue native des sujets, export des avis, suite vendeur, tableau de bord spécialisé, réponse API, feuille de calcul ou analyse assistée par IA |
| Éléments probants conservés | Extraits d’avis, ID source, dates, ASIN, marketplace, dénominateur, contre-exemples et filtres enregistrés |
| Sortie conservée | Brief, CSV, ticket, tableau de bord, alerte, charge utile API, codebook ou présentation |
| Travail de reconstruction | Nettoyage manuel, assemblage de captures d’écran, relances de prompts, réconciliation de feuilles de calcul, explication aux parties prenantes ou correction technique |
| Preuve d’adoption | Qui a utilisé la sortie, quelle décision a changé et si l’artefact de décision a été accepté sans reprise |
| Risque de remplacement | Données impossibles à exporter, historique de taxonomie susceptible d’être perdu, intégrations nécessitant une reprise ou examen juridique/de sécurité requis |
Ce registre offre aux évaluateurs du renouvellement une base de comparaison bien meilleure que le seul coût du contrat. Un flux de travail bon marché qui exige deux jours de reconstruction manuelle pour chaque décision majeure peut coûter plus cher qu’un système plus onéreux qui préserve les preuves, la responsabilité et la reproductibilité.
Évaluez le flux de travail actuel avec les mêmes critères que les nouveaux finalistes
Ne faites pas de cadeau à l’existant. Évaluez-le selon les mêmes critères minimaux que ceux que vous appliqueriez à une nouvelle alternative d’analyse des avis Amazon :
- L’équipe peut-elle voir exactement quels avis, ASIN, marketplaces, dates, filtres et variantes ont été analysés ?
- Chaque thème important peut-il être relié au langage client d’origine et à au moins un contre-exemple ?
- La même taxonomie peut-elle comparer un produit cible, un concurrent et une période récente sans changements de dénominateur cachés ?
- Un propriétaire non analyste peut-il utiliser la sortie sans reconstruire le travail ?
- Les preuves, la taxonomie et l’historique des décisions peuvent-ils être exportés avant le renouvellement ?
- Une exécution répétée peut-elle expliquer les changements causés par de nouveaux avis, des modifications de configuration ou des changements de modèle ?
- Le flux de travail peut-il prouver sa valeur via des artefacts de produit, d’annonce, de qualité ou de suivi acceptés ?
Si l’existant échoue à une étape non négociable, la décision de renouvellement devrait devenir un remplacement contrôlé ou un plan de remédiation. S’il passe les critères mais comporte des modules supplémentaires non utilisés, la bonne décision peut être de réduire le périmètre plutôt que de changer de fournisseur.
Définissez à l’avance les déclencheurs de remplacement
Le remplacement ne doit pas dépendre de la personne la plus frustrée lors de la réunion de renouvellement. Définissez les déclencheurs avant l’audit :
| Déclencheur | Pourquoi c’est important | Seuil d’exemple |
|---|---|---|
| Perte de preuves | Les parties prenantes ne peuvent pas faire confiance au constat ni le réexaminer | Plus de 10 % des revendications prioritaires n’ont pas de preuve de la revue de source ou de contexte de dénominateur |
| Reconstruction du workflow | L’outil produit des résultats qui nécessitent une reconstruction manuelle répétée | Plus d’une journée de travail par mois consacrée à assembler des annexes de preuves à partir de captures d’écran, d’exports ou de nouvelles exécutions |
| Décalage de couverture | Le workflow actuel ne correspond plus à l’endroit où l’entreprise se fait concurrence | Les marketplaces, concurrents, langues, variantes ou gammes de produits requis manquent dans l’analyse récurrente |
| Échec d’adoption | L’outil est consulté mais pas utilisé pour les décisions | Moins de deux artefacts de décision acceptés par trimestre pour un workflow de revue récurrente |
| Faille de gouvernance | L’accès, la conservation, les exports, le traitement via API ou l’historique d’audit ne sont pas conformes à la politique | Les responsables de la sécurité, du juridique ou des données ne peuvent pas approuver le workflow en production sans exceptions |
| Risque de sortie | Le changement ferait perdre la taxonomie, les preuves ou la continuité historique | Aucun export exploitable des preuves, du codebook, de l’historique des décisions ou des mappages d’intégration avant le renouvellement |
Ces seuils sont des exemples, pas des standards universels. L’objectif est de faire passer la conversation sur le renouvellement du registre des préférences à celui du travail observé.
Décider entre quatre résultats de renouvellement
À la fin de l’audit, choisissez l’un des quatre résultats :
- Renouveler en l’état. À n’utiliser que lorsque le workflow franchit les seuils de preuve, de résultat, d’adoption, de gouvernance, de coût et de capacité de sortie.
- Renouveler avec un périmètre plus restreint. Conservez l’outil pour les tâches qu’il prend réellement en charge, et retirez du modèle opérationnel les attentes gonflées.
- Renouveler avec remédiation. Ne conservez le workflow que si des lacunes spécifiques sont corrigées à une date nommée, comme le schéma d’export, l’annexe de preuves, les contrôles de taxonomie ou la passation aux parties prenantes.
- Remplacer ou reconstruire. Lancez une preuve de remplacement lorsque l’outil en place ne peut pas prendre en charge le workflow de décision actuel, ne peut pas exporter la trace des preuves ou coûte plus que ne le justifient ses artefacts de décision acceptés.
C’est là que les comparaisons d’Amazon review analytics deviennent plus honnêtes. Un outil natif peut être la bonne réponse après un pilote spécialisé. Une suite seller peut rester dans la pile en tant que module de support. Une plateforme spécialisée peut devenir le système d’enregistrement. Un pipeline API peut l’emporter lorsque les preuves doivent circuler vers des systèmes propriétaires. L’audit de renouvellement oblige le choix à suivre le travail.
Amazon review analytics : comparaison et alternatives par modèle opérationnel
Pour le travail de comparaison et d’alternatives autour d’Amazon review analytics, le modèle opérationnel compte, car chaque option transfère la responsabilité à une équipe différente.
| Approche | Idéal pour | Principal atout | Principale limite | À choisir si |
|---|---|---|---|---|
| Lecture manuelle et feuilles de calcul | Analyse ponctuelle d’un petit ensemble d’avis | Contrôle maximal sur ce qui est codé | Lent, difficile à reproduire, facile à faire diverger entre analystes | Vous avez une question précise et étroite et pouvez examiner vous-même les avis स्रोत |
| Assistant IA à usage général | Exploration rapide et création d’une taxonomie initiale | Prompts flexibles et synthèse rapide | La collecte des données, la traçabilité et la reproductibilité dépendent de votre processus | Vous disposez déjà d’un ensemble d’avis conforme à la loi et avez besoin d’une première analyse |
| Insights d’avis natifs Amazon | Questions produit ou de niche dans Seller Central | Contexte natif et faible friction de configuration | L’accès, le périmètre, les exports et la flexibilité du flux de travail peuvent ne pas convenir à toutes les équipes | Votre décision se situe principalement dans Amazon et la couverture native est suffisante |
| Suite Amazon vendeur polyvalente | Équipes ayant aussi besoin d’outils de mots-clés, de fiches produit, de publicité ou de recherche produit | Plusieurs flux de travail vendeur dans un seul abonnement | L’analyse des avis peut n’être qu’un module plutôt que le cœur du système | La consolidation compte davantage qu’une conception approfondie du flux de travail d’analyse des avis |
| Plateforme spécialisée | Intelligence répétable sur les avis à travers produits et concurrents | Analyse plus poussée des thèmes, récupération des preuves, comparaison et suivi | Ajoute un système dédié à la pile | Le langage des avis alimente des décisions récurrentes de produit, de fiche, de support ou de recherche |
| Pipeline API personnalisé | Flux de travail à haut volume ou intégrés | Contrôle des modèles de données, de l’automatisation et des intégrations internes | Charge d’ingénierie, de gouvernance, de QA et de maintenance | L’intelligence des avis doit alimenter des tableaux de bord, des modèles ou des processus opérationnels propriétaires |
Une plateforme spécialisée et un pipeline API personnalisé sont souvent évalués ensemble, mais ils résolvent des problèmes de propriété différents. L’un achète un flux de travail maintenu ; l’autre le construit.
Commencez par la décision, pas par le tableau de bord
Avant de comparer les outils, rédigez une phrase qui définit la décision.
Par exemple :
- Quels griefs récurrents devraient modifier notre prochaine révision produit ?
- Quelles formulations d’acheteurs devraient influencer le texte de notre fiche produit ?
- Une baisse soudaine de la note est-elle liée à l’emballage, à la qualité, aux attentes ou à l’exécution ?
- Quelle faiblesse d’un concurrent apparaît suffisamment souvent pour être examinée ?
- Quels thèmes d’avis augmentent après un changement de fournisseur ou d’emballage ?
Cela compte parce que « analyser les avis » n’est pas une exigence exploitable. Des décisions différentes nécessitent des niveaux de couverture, des fenêtres temporelles, des ensembles de comparaison et des normes de preuve différents.
Un projet de texte de fiche produit peut nécessiter des formulations exactes et des scénarios d’utilisation. Une enquête qualité a besoin de dates, de variantes, de lots et de changements de tendance. Un projet d’approvisionnement a besoin d’une couverture des concurrents et de la catégorie. Un flux de travail de surveillance hebdomadaire a besoin d’alertes, de responsabilités et de dates de recontrôle.
Si l’outil ne peut pas préserver le lien entre un thème et les avis qui le sous-tendent, le résultat est une suggestion — pas une preuve.
Les 10 critères qui distinguent une analytics utile de simples résumés soignés
Utilisez ces critères pour comparer les alternatives d’analyse des avis Amazon.
1. Couverture des avis
Demandez ce que l’analyse inclut réellement :
- Un ASIN ou un portefeuille ?
- Vos produits, ceux des concurrents ou des ensembles au niveau de la catégorie ?
- Quels marketplaces et quelles langues ?
- Quelle plage de dates ?
- Les fiches parent, les variantes enfant, ou les deux ?
- Tous les avis disponibles ou une sélection limitée ?
La couverture change la conclusion. Un flux de sujets natif ou alimenté par API peut constituer une base de référence solide lorsqu’il correspond à votre ASIN, marketplace, langue et contraintes d’éligibilité. Il s’agit toutefois d’une base de preuves différente d’une analyse personnalisée sur corpus complet ou multi-ASIN si le workflow ne peut pas montrer le même dénominateur, les mêmes filtres, la même fenêtre temporelle et les mêmes exclusions dont votre décision a besoin.
La bonne question n’est pas « Analyse-t-il les avis ? » C’est « Quels avis déterminent la réponse ? »
2. Qualité des thèmes
Le sentiment de base classe les retours en positifs, neutres et négatifs. Une analyse utile doit aussi identifier l’objet de ce sentiment.
Recherchez des thèmes tels que :
- Durabilité
- Ajustement ou taille
- Friction à l’installation
- Dommages liés à l’emballage
- Accessoires manquants
- Autonomie de la batterie
- Toucher du matériau
- Décalage avec les attentes
- Cas d’utilisation ou type d’acheteur
Les libellés des thèmes doivent être suffisamment précis pour orienter l’action. « Retour négatif sur le produit » n’a pas de propriétaire. « Le couvercle se fissure après des cycles répétés au lave-vaisselle » peut être transmis aux équipes produit et qualité.
3. Preuves textuelles
Un système solide vous permet de passer d’un graphique aux extraits d’avis pertinents. Cela aide les équipes à :
- Vérifier si le libellé correspond au langage utilisé
- Voir le contexte que le résumé a compressé
- Identifier les expressions que les clients utilisent naturellement
- Trouver des exceptions et des contre-exemples
- Éviter de présenter un texte généré comme une citation client
La récupération des preuves est l’une des différences les plus nettes entre l’analyse des avis et la synthèse générique de texte.
4. Logique de comparaison
L’analyse des avis des concurrents doit comparer ce qui est comparable. Vérifiez si vous pouvez contrôler :
- Le jeu de produits
- La fenêtre temporelle
- La plage d’étoiles
- La variante ou le modèle
- Le marketplace
- La définition du thème
- Les différences de volume d’avis
Un concurrent peut avoir davantage de plaintes simplement parce qu’il a davantage d’avis. Un produit plus récent peut sembler meilleur parce que moins de problèmes de durabilité à long terme ont eu le temps d’apparaître. Des comptes sans dénominateurs peuvent induire en erreur.
5. Tendances dans le temps
Un comptage des thèmes sur l’ensemble de la période peut masquer l’événement que vous devez voir. Recherchez la possibilité de comparer des périodes et de détecter les changements après :
- Un changement de fournisseur
- Une révision de l’emballage
- Une réécriture de l’annonce
- Un changement de prix
- Un pic saisonnier de la demande
- Une mise à jour du produit
Amazon décrit Customer Review Insights comme affichant les sujets positifs et négatifs, l’impact des sujets sur les évaluations par étoiles, des extraits d’avis et des tendances sur six mois au sein de Product Opportunity Explorer. Cette vue native peut suffire pour certaines questions liées aux produits et aux niches.
6. Filtres et segmentation
Les filtres utiles dépendent de la décision, mais les plus courants incluent la note, la date, le produit, le concurrent, la variation, le marketplace, la langue et le thème.
Ne considérez pas un tableau de bord riche en filtres comme automatiquement rigoureux. Les filtres ne sont utiles que si la couverture sous-jacente est claire et si les éléments de preuve qui en résultent peuvent être inspectés.
7. Résultats du flux de travail
Le résultat doit correspondre à l’action suivante. Par exemple :
- Une contribution aux exigences produit
- Un brief sur le langage de la fiche produit
- Un rapport sur un problème d’emballage
- Une mise à jour de la FAQ du support
- Un tableau des écarts par rapport aux concurrents
- Une alerte de suivi
- Un mémo de décision hebdomadaire
Si le flux de travail se termine par un « tableau de bord intéressant », l’équipe doit quand même reconstruire l’analyse avant d’agir.
8. Reproductibilité
Une autre personne peut-elle relancer la même analyse la semaine suivante et comprendre ce qui a changé ?
La reproductibilité exige plus que des invites enregistrées. Elle peut inclure une taxonomie stable, un ensemble de produits nommé, une plage de dates, des filtres, une version d’analyse, des liens vers les éléments de preuve et des résultats exportables.
C’est là que l’analyse manuelle et les assistants IA généralistes ont souvent besoin d’une conception de processus supplémentaire. Ils peuvent être puissants, mais c’est l’équipe qui maîtrise la méthode.
9. Intégration et exportation
Réfléchissez à l’endroit où les résultats doivent aller :
- CSV ou feuille de calcul
- Système de gestion de produit
- Tableau de bord de business intelligence
- Entrepôt de données
- Plateforme de support
- Référentiel interne de recherche
- Flux de travail d’alerte automatisée
L’API Customer Feedback d’Amazon peut renvoyer des thèmes d’avis positifs et négatifs pour un ASIN à des applications autorisées. VOC AI décrit également une Review Analysis API pour les champs d’avis d’origine et les données de conclusion analysées par l’IA. Une API devient pertinente lorsque la destination compte autant que l’interface d’analyse.
10. Gouvernance et conformité
L’analyse des avis doit vous aider à tirer des enseignements des retours clients, et non à les manipuler.
Le FTC Consumer Reviews and Testimonials Rule traite de pratiques telles que les faux avis, les incitations conditionnées au sentiment, les avis d’initiés non divulgués et la suppression d’avis. La règle est entrée en vigueur le 21 octobre 2024.
Votre évaluation doit couvrir l’accès aux données, la conservation, les autorisations utilisateur, les exportations, l’auditabilité et la manière dont les résumés générés sont séparés du langage original des clients. Elle doit également confirmer que la collecte des avis et leur utilisation en aval respectent les conditions applicables de la plateforme et la politique interne.
Exécutez un benchmark de reproductibilité avant de comparer les listes de fonctionnalités
Les listes de fonctionnalités vous disent ce qu’un produit prétend faire. Un benchmark de reproductibilité teste si l’approche peut produire une réponse stable et inspectable lorsque l’entrée, la question et les règles restent les mêmes.
Cela importe parce que l’analyse des avis Amazon combine souvent plusieurs étapes variables : sélection du corpus, déduplication, traitement des langues, attribution des thèmes, classification du sentiment, choix du dénominateur, logique de comparaison et génération d’explications. Deux tableaux de bord attrayants peuvent aboutir à des conclusions différentes à partir des mêmes avis. La question utile n’est pas de savoir s’ils divergent. C’est de savoir si vous pouvez localiser et expliquer la divergence.
Constituez un pack de benchmark unique avant les démonstrations fournisseurs ou les essais. Utilisez le même pack pour l’analyse manuelle, les outils natifs, les suites vendeurs, les plateformes spécialisées et les flux de travail pilotés par API.
Assemblez un pack de test fixe
Choisissez un ensemble de produits focal comprenant des avis ordinaires et des cas difficiles :
- Un ASIN focal avec suffisamment d’historique d’avis pour montrer des thèmes récurrents
- Un concurrent proche avec un cas d’usage similaire
- Un produit avec des variantes, des bundles ou des différences de configuration significatives
- Un marketplace et une fenêtre de dates fixes
- Des avis avec un sentiment mitigé, de l’ironie, des éloges conditionnels et plusieurs problèmes
- Des avis qui mentionnent dans le même texte l’emballage, l’exécution, les attentes et les performances du produit
- Au moins cinq avis qu’un analyste humain considère comme ambigus
Enregistrez les ASIN, le marketplace, la date d’extraction, le nombre d’avis, la fenêtre de dates, les filtres et toute exclusion. Si un workflow ne peut pas révéler le corpus analysé ou son dénominateur, signalez-le comme une limitation de mesure avant d’examiner sa sortie.
Pour les options pilotées par API, conservez le schéma de requête et de réponse avec le résultat. Amazon maintient un modèle Customer Feedback API public, qui constitue un exemple utile des contrats versionnés que les acheteurs techniques devraient s’attendre à examiner.
Posez les mêmes cinq questions à chaque option
Ne laissez pas chaque démonstration choisir la question qui met le mieux son interface en valeur. Exigez de chaque finaliste qu’il réponde au même ensemble :
- Quels sont les trois mécanismes de réclamation récurrents les plus importants pour l’ASIN focal ?
- Quelle réclamation a le plus changé sur la période récente par rapport à la période de référence ?
- Quel thème distingue le plus clairement l’ASIN focal du concurrent ?
- Quelle conclusion est la plus incertaine, et quelles preuves réduiraient cette incertitude ?
- Quelle action unique sur le produit, la fiche ou le suivi un propriétaire devrait-il entreprendre ensuite ?
Les questions testent délibérément des capacités différentes. La première teste la couverture et la taxonomie. La deuxième teste les dénominateurs et les fenêtres temporelles. La troisième teste la logique de comparaison. La quatrième teste la confiance et les contre-preuves. La cinquième teste si la sortie peut franchir la frontière entre l’analyse et un flux de décision.
Créez un jeu de référence codé par des humains
Sélectionnez 30 à 50 avis du lot de test et demandez à deux personnes de les coder indépendamment. Utilisez un schéma compact :
| Champ | Exemple de règle |
|---|---|
| Thème principal | Le principal résultat client ou mécanisme du problème |
| Thème secondaire | Un problème supplémentaire distinct, pas un synonyme du thème principal |
| Sentiment | Positif, négatif, mitigé ou peu clair au niveau du thème |
| Mécanisme | Ce qui a causé le résultat loué ou critiqué |
| Portée de la preuve | Les mots exacts qui soutiennent le code |
| Confiance | Élevée, moyenne ou faible avec une courte raison |
| Contexte | Variante, scénario d’utilisation, emballage, exécution ou attente lorsque disponible |
Résolvez les désaccords et conservez à la fois les codes originaux et le résultat arbitrée. Il ne s’agit pas d’une vérité terrain parfaite. C’est une référence transparente qui expose la manière dont chaque approche traite les cas limites connus.
Si votre équipe a besoin d’un cadre d’approvisionnement plus large, utilisez ce benchmark avec une grille d’évaluation d’un outil d’analyse des avis clients plutôt que de remplacer le jugement par un seul chiffre de précision.
Évaluer séparément l’accord, la stabilité et la traçabilité
Un score unique de « précision » masque des modes d’échec importants. Évaluez au moins ces quatre dimensions de 0 à 2 :
| Dimension du benchmark | 0 | 1 | 2 |
|---|---|---|---|
| Accord sur les thèmes | Les thèmes humains importants sont omis ou fortement déformés | Les thèmes principaux apparaissent, mais les frontières ou les mécanismes sont incohérents | Les thèmes principaux et les mécanismes s’alignent suffisamment pour appuyer la décision |
| Stabilité d’une exécution à l’autre | Répéter le même test produit des priorités matériellement différentes sans explication | Les priorités sont similaires, mais les libellés, les comptes ou les preuves à l’appui évoluent | Les exécutions répétées préservent la conclusion ou expliquent clairement le changement induit par la version |
| Traçabilité des preuves | Les conclusions ne peuvent pas être reliées à des avis individuels ou à des références source approuvées | Certains exemples sont visibles, mais le dénominateur ou l’ensemble complet des preuves n’est pas clair | Chaque conclusion importante dispose de preuves récupérables, du contexte du corpus et d’une base de calcul |
| Diagnostic des désaccords | L’équipe ne peut pas identifier pourquoi le résultat diffère de la référence | Les différences peuvent être trouvées par reconstruction manuelle | Le workflow expose les filtres, la taxonomie, la confiance, les exceptions et les preuves concernées |
Exécutez le même benchmark deux fois sans modifier le corpus ni les instructions. Si le résultat change, demandez-vous si la différence vient d’une version du modèle, d’un changement de taxonomie, d’une actualisation du corpus, d’une génération aléatoire, d’un filtre caché ou d’une règle de calcul. Une réponse stable mais fausse n’est pas bonne, mais une réponse instable que l’on ne peut pas expliquer est difficile à gouverner.
Tenir un journal des désaccords
Pour chaque divergence importante, consignez :
- La revendication ou le thème classé qui a changé
- Les avis ou enregistrements concernés
- Si la différence relève d’un problème de couverture, de codage, de sentiment, de dénominateur, de récence ou d’explication
- Si un relecteur humain peut la corriger
- Si la correction persiste à l’exécution suivante
- Si la divergence modifie l’action recommandée
Ce journal est plus utile que la collecte de captures d’écran isolées. Il montre si le workflow s’améliore grâce à des modifications de taxonomie, des exclusions, des changements de prompt, des corrections de données ou la configuration du produit — et si ces améliorations survivent au-delà de la session d’un seul analyste.
Définir une condition de réussite liée à la décision
N’exigez pas que chaque libellé de thème corresponde mot pour mot. Exigez que l’approche préserve le sens pertinent pour la décision.
Par exemple, « fissures du couvercle pendant l’expédition » et « dommages au couvercle liés à l’emballage » peuvent être des variantes acceptables si elles renvoient toutes deux aux mêmes preuves et au même responsable. « Mauvaise qualité » n’est pas un substitut acceptable lorsqu’elle fusionne des dommages au couvercle, une panne de batterie et des plaintes de taille en une seule catégorie vague.
Un finaliste réussit lorsqu’il peut :
- Reproduire les principaux thèmes pertinents pour la décision
- Expliquer les différences importantes par rapport à l’ensemble de référence
- Préserver les preuves sources et les dénominateurs
- Produire un ordre de priorité stable sur des exécutions répétées
- Transformer le résultat en livrable requis sans travail de reconstruction caché
Ce benchmark n’élimine pas la nécessité d’un pilote en production. Il rend le pilote plus diagnostique. Vous entamez la preuve de 14 jours en sachant quels cas limites, contrôles et lacunes probantes требуют attention.
Alternative 1 : lecture manuelle des avis et tableurs
L’analyse manuelle n’est pas obsolète. C’est souvent le meilleur point de départ lorsque la décision est ciblée et que l’ensemble d’avis est gérable.
Quand cela fonctionne
- Vous évaluez un petit nombre de produits
- Vous devez apprendre le vocabulaire de la catégorie avant d’automatiser
- La décision est à forts enjeux et nécessite une lecture attentive
- Vous souhaitez créer une première taxonomie
- L’analyse est ponctuelle plutôt que récurrente
Quand cela échoue
- Le codage change au fur et à mesure que l’analyste apprend
- Les thèmes en double et les libellés incohérents s’accumulent
- La traçabilité des avis devient fastidieuse
- La comparaison de périodes ou de concurrents nécessite un nettoyage répété
- Le classeur devient difficile à réutiliser pour d’autres équipes
Une configuration manuelle pratique utilise une ligne par avis, des champs source immuables, des champs codés par l’analyste séparés, et un codebook qui définit chaque thème. Conservez les citations clients séparées des résumés.
Alternative 2 : un assistant IA à usage général
Un assistant IA général peut classer, résumer et explorer rapidement le texte des avis que vous lui fournissez. C’est une alternative utile lorsque votre équipe contrôle déjà l’ensemble de données et accepte de prendre en charge la méthode.
Quand cela fonctionne
- Vous avez besoin d’une taxonomie rapide en première intention
- L’analyse est exploratoire
- Un humain examinera les preuves
- Vous pouvez gérer le découpage en lots, les prompts et les sorties
- Vous n’avez pas besoin d’un système de surveillance permanent
Quand cela échoue
- Les limites d’entrée peuvent fragmenter l’analyse
- Le modèle peut fusionner des mécanismes distincts en grands thèmes
- Les résultats peuvent changer selon les prompts ou les versions du modèle
- Les citations vers les lignes sources nécessitent une mise en œuvre délibérée
- La collecte des données et l’accès à la plateforme restent des problèmes distincts
Utilisez des champs de sortie structurés tels que theme, mechanism, sentiment, evidence_id, product, date et confidence. Ensuite, auditez un échantillon de classifications avant d’utiliser les résultats pour une décision produit ou marketing.
Alternative 3 : les analyses d’avis natives d’Amazon
Le Customer Review Insights d’Amazon se trouve dans Product Opportunity Explorer, dans Seller Central. Amazon indique qu’il regroupe les thèmes positifs et négatifs courants, affiche des extraits, indique comment les thèmes affectent les notes étoilées et présente les tendances des thèmes.
Quand cela fonctionne
- La question porte sur des produits ou des niches Amazon
- Votre équipe travaille déjà dans Seller Central
- Les vues natives des thèmes et des tendances répondent à la décision
- Vous souhaitez un faible surcoût de configuration
À vérifier pour l’adéquation
- Éligibilité et disponibilité sur la marketplace
- Couverture exacte des produits et des niches
- Besoins en export et en intégration
- Profondeur historique
- Besoins en taxonomie personnalisée
- Besoins en retours cross-canal ou non-Amazon
Les outils natifs constituent une base solide. Comparez les alternatives payantes à la réponse native que vous pouvez déjà obtenir, et non à une feuille de calcul vide.
Alternative 4 : une suite Amazon seller large
Les suites seller combinent plusieurs tâches telles que la recherche produit, l'analyse de mots-clés, les workflows de fiche produit, la publicité et les opérations. L'analyse des avis peut n'être qu'une fonctionnalité parmi d'autres.
La nuance d'août 2026 est que certaines fonctionnalités d'avis des suites seller se positionnent désormais autour des données officielles de feedback client d'Amazon, plutôt qu'autour du seul texte des avis exportés. Cela peut constituer un avantage significatif pour les équipes qui veulent un signal proche de Seller Central sans construire un workflow API. Cela signifie aussi que vous devez vérifier si la fonctionnalité est principalement une vue des sujets natifs, un workflow d'analyse du texte des avis, ou un système plus profond d'aide à la décision fondé sur des preuves.
Quand cela fonctionne
- Les mêmes utilisateurs ont besoin de plusieurs workflows seller
- La consolidation des outils réduit les frictions opérationnelles
- L'analyse des avis soutient le travail plutôt que de le définir
- Une suite cohérente a plus de valeur qu'une profondeur maximale dans un seul module
- La couverture des sujets native à Amazon suffit pour la question et la suite possède déjà le workflow environnant
Points à vérifier pour l'adéquation
- Si la fonctionnalité utilise des données de sujets natives à Amazon, des exports de texte d'avis, une analyse propriétaire ou un mélange des deux
- L'étendue exacte d'ASIN, de marketplace, de langue et d'éligibilité
- La comparaison entre concurrents et multi-ASIN
- Les exports d'avis
- La personnalisation des thèmes
- La traçabilité des preuves
- Le suivi et les alertes
- Si la fonctionnalité nécessaire est incluse dans le plan pertinent
Ne comparez pas les prix des suites uniquement à partir de la fonctionnalité d'avis. Comparez l'ensemble des tâches que votre équipe utilisera réellement.
Alternative 5 : une plateforme spécialisée d'analyse d'avis
Une plateforme spécialisée a du sens lorsque le langage client est un intrant opérationnel récurrent plutôt qu'une tâche de recherche occasionnelle.
Quand cela fonctionne
- Plusieurs équipes utilisent les preuves issues des avis
- Vous comparez de façon répétée des produits, des concurrents ou des catégories
- La cohérence des thèmes compte dans le temps
- Le libellé exact des clients influence les fiches produit et les décisions produit
- Le suivi et les rapports réutilisables font partie du workflow
Le VOC Analysis de VOC AI est un exemple de cette approche. Il est conçu pour regrouper les retours par point de douleur, attente et mention de fonctionnalité ; relier les plaintes récurrentes aux décisions produit et de fiche produit ; et utiliser l'intelligence des avis dans des tableaux de bord, des workflows d'agents et un accès API.
La question d'achat n'est pas de savoir si un spécialiste peut créer plus de graphiques. Il s'agit de savoir s'il réduit le travail répété entre l'avis source, la conclusion étayée, le responsable et la prochaine action.
Alternative 6 : un pipeline API personnalisé
Un pipeline personnalisé est l'alternative offrant le plus de contrôle et la plus facile à sous-estimer.
Quand cela fonctionne
- L’intelligence des avis doit être intégrée dans un produit interne
- Vous avez besoin d’une taxonomie propriétaire ou d’un modèle de notation
- Les grands ensembles de produits nécessitent un traitement planifié
- Les résultats doivent être reliés aux données de ventes, de retours, d’assistance ou de qualité
- Des responsables de l’ingénierie et de la gouvernance des données sont disponibles
Ce que vous gérez
- Accès aux données conforme à la loi
- Schémas et résolution d’identité
- Déduplication et gestion des langues
- Sélection et évaluation des modèles
- Versioning des thèmes
- Stockage des preuves
- Autorisations et conservation
- Surveillance et maintenance
La comparaison entre développement interne et achat doit inclure l’assurance qualité continue et la responsabilité, et pas seulement le premier prototype.
Outils d’analyse des avis Amazon nommés et alternatives
Les catégories ci-dessus sont plus utiles qu’une liste générique des « meilleurs outils », car plusieurs produits qui apparaissent ensemble dans les résultats de recherche répondent à des besoins différents. Néanmoins, les acheteurs ont besoin de noms pour établir une liste restreinte pratique.
Utilisez la carte suivante comme point de départ, et non comme classement final. L’accès au produit, la couverture des places de marché, les exportations et le packaging peuvent changer. Vérifiez le flux de travail actuel auprès du fournisseur et testez chaque finaliste sur le même ensemble d’ASIN.
| Option | Operating model | Best starting use case | What to verify before shortlisting |
|---|---|---|---|
| Amazon Customer Review Insights | Analyse native Amazon au sein de Product Opportunity Explorer | Établir une base de référence native pour les sujets, extraits, effets sur les notes et tendances | Admissibilité du compte, couverture des marketplaces et des niches, options d’export, profondeur historique et savoir si la taxonomie native répond à votre décision |
| Amazon Customer Feedback API | Entrée API Amazon pour un workflow gouverné | Intégrer des sujets de feedback client éligibles dans des रिपोर्टings internes ou des applications | Endpoints et portée des données disponibles, comportement d’actualisation hebdomadaire, limites de langue et de marketplace, autorisation, règles de conservation, responsabilité d’ingénierie, stockage des preuves en aval et maintenance continue |
| Helium 10 Review Insights | Fonctionnalité de suite vendeur utilisant les données de l’API Amazon Customer Feedback | Combiner les sujets de feedback Amazon avec d’autres recherches vendeur et workflows de fiches produits | Quels plans et marketplaces incluent le workflow nécessaire, si les données de sujets API suffisent à votre décision, la profondeur d’export, les contrôles de comparaison personnalisés et si les thèmes restent liés aux preuves sources |
| SellerSprite Review Analysis | Suite de recherche Amazon avec workflows d’analyse des avis | Recherche concurrentielle et analyse des avis produits au sein d’une stack de recherche vendeur | Couverture des ASIN et des marketplaces, contrôles de comparaison, filtres de date, exports, comportement de taxonomie et adéquation du résultat avec le processus de recherche existant de l’équipe |
| ReviewMeta | Filtrage de l’authenticité des avis | Vérifier si un corpus d’avis peut contenir des schémas suspects avant une interprétation plus poussée | Si le résultat traite du contrôle d’authenticité plutôt que de l’analyse des thèmes produit, la méthodologie utilisée et la manière dont la vue ajustée influencera la décision |
| Assistant IA à usage général | Couche d’analyse flexible sur un jeu de données que vous contrôlez déjà | Rédiger une taxonomie, extraire des preuves ou tester rapidement une question ciblée | Accès légal aux données, limites d’entrée, reproductibilité, versioning des prompts et du modèle, citations au niveau de l’avis et procédures d’audit humaines |
| VOC AI Voice of Customer Analysis | Plateforme spécialisée d’intelligence sur les avis et les feedbacks | Analyse récurrente sur plusieurs produits, concurrents, équipes ou canaux de feedback | Couverture des sources, traçabilité des preuves, contrôles de taxonomie, monitoring, collaboration, exports, adéquation API et transfert exact de la détection à la décision |
Ce tableau n’est délibérément pas un classement de un à sept. Les informations natives d’Amazon peuvent être la meilleure réponse à une question étroite de Seller Central. ReviewMeta peut être utile comme vérification d’authenticité, mais ne remplace pas l’analyse des thèmes. Une suite pour vendeurs peut l’emporter lorsque la consolidation est importante. Un spécialiste ou un workflow API devient plus pertinent lorsque les mêmes éléments probants doivent alimenter régulièrement des décisions produit, marketing, recherche et opérations.
L’ajustement important pour 2026 consiste à éviter de compter deux fois le même signal natif. Si un module de suite vendeur et un workflow API direct s’appuient tous deux sur l’API Customer Feedback d’Amazon, comparez-les sur le workflow, les exports, les contrôles et la responsabilité opérationnelle — et non sur l’hypothèse qu’ils révèlent deux ensembles de données sous-jacents totalement différents.
Pour une décision de renouvellement ou de remplacement, ajoutez une colonne supplémentaire à votre copie interne de ce tableau : que retirerait cette option ? Si la réponse est « rien », vous ajoutez peut-être une autre surface d’analyse des avis au lieu de remplacer un travail existant. Une nouvelle alternative d’analyse des avis Amazon devrait supprimer l’assemblage manuel des preuves, les taxonomies incohérentes, les rapports basés sur des captures d’écran, le nettoyage lent des exports ou un tableau de bord que personne n’utilise pour prendre une décision.
Comparer des outils nommés à l’aide d’un même jeu de test
Créez un jeu de test avant d’ouvrir les démonstrations des éditeurs :
- Un ASIN focal : le produit pour lequel une vraie décision est en attente.
- Deux ASINs de comparaison : un concurrent proche et une alternative sensiblement différente.
- Une fenêtre fixe : par exemple, les 90 ou 180 jours les plus récents, plus une vue de référence sur l’ensemble de la période.
- Cinq avis connus : des exemples que votre équipe a déjà codés, y compris des commentaires ambigus ou à sentiment mixte.
- Un livrable requis : une note de synthèse produit, une note sur les problèmes produit, un rapport sur les risques de lancement ou une comparaison concurrentielle.
- Une règle de preuve : chaque affirmation importante doit renvoyer au texte exact de l’avis et conserver l’ASIN, la date, la note et le contexte de la place de marché.
Puis demandez à chaque finaliste de répondre aux mêmes questions :
- Qu’est-ce qui a changé récemment plutôt que d’apparaître simplement souvent sur l’ensemble de la période ?
- Quels mécanismes de plainte distinguent l’ASIN focal des deux alternatives ?
- Quelle conclusion devient plus faible lorsque les avis en double, vagues ou suspects sont retirés ?
- Quels avis sources soutiennent les trois principaux constats ?
- Quel livrable de décision peut être exporté et remis à un responsable ?
Cela transforme une comparaison de fonctionnalités en une comparaison de workflows contrôlée.
Choisissez une alternative selon la contrainte
Si votre liste restreinte est encore trop large, commencez par la contrainte la plus difficile à modifier.
| Contrainte stricte | Option par défaut à tester en premier | Pourquoi |
|---|---|---|
| Pas de budget et une seule décision ciblée | Codage manuel ou feuille de calcul contrôlée assistée par IA | Réduit le workflow tout en conservant un accès direct aux preuves |
| Seller Central est au cœur du travail | Insights natifs d’Amazon | Permet de vérifier si la vue propre à la plateforme répond déjà à la question avec une configuration minimale |
| L’équipe veut une seule suite pour vendeurs | Suite vendeur large | Consolide plusieurs workflows lorsque l’analytics des avis n’est qu’une partie du travail ; vérifiez si sa couche avis repose nativement sur des API ou sur une analyse plus approfondie des preuves |
| Les preuves issues des avis sont utilisées chaque semaine par plusieurs équipes | Plateforme spécialisée d’analytics des avis | Privilégie la répétabilité, une taxonomie partagée, la traçabilité, la surveillance et des résultats réutilisables |
| L’intelligence des avis doit vivre dans un produit interne | Customer Feedback API ou autre pipeline API gouverné | Offre un contrôle sur les schémas, les intégrations, les autorisations et la logique décisionnelle propriétaire |
| La confiance dans le corpus d’avis est la préoccupation immédiate | Outil de détection de l’authenticité avant l’analyse des thèmes | Sépare la question « Pouvons-nous faire confiance à ce corpus ? » de « Que vivent les clients ? » |
| L’équipe doit combiner les avis avec le support, les retours, les enquêtes ou les commentaires sociaux | Plateforme Voice of Customer multicanale ou pipeline piloté par le data warehouse | Évite que la décision soit limitée à une seule source de feedback auto-sélectionnée |
Le choix par défaut n’est qu’un premier test. Une contrainte stricte réduit le champ ; la preuve sur le même ASIN détermine le gagnant.
Réduire le marché à trois à cinq finalistes
Une comparaison devient moins utile lorsque chaque produit possible reste dans le tableur. L’objectif du premier tri n’est pas de choisir un gagnant. Il s’agit d’écarter les approches qui ne peuvent pas prendre en charge la décision requise.
Dans une short-list d’Amazon review analytics : comparaison et alternatives, l’ensemble le plus solide mélange généralement plusieurs modèles opérationnels plutôt que de rassembler plusieurs outils qui résolvent la même tâche.
Commencez avec six filtres non négociables :
- Couverture : l’approche peut analyser les ASIN, marketplaces, langues, plages de dates et variantes requis.
- Preuves : les thèmes importants peuvent être rattachés au texte exact des avis.
- Comparaison : les produits peuvent être comparés avec la même fenêtre temporelle, le même dénominateur et la même taxonomie.
- Workflow : la sortie peut parvenir au responsable qui doit agir dessus.
- Gouvernance : l’accès aux données, la conservation, les autorisations et la gestion des avis correspondent à votre politique.
- Adéquation opérationnelle : votre équipe peut exécuter, auditer et maintenir le workflow après le pilote.
Éliminez toute option qui échoue sur un véritable critère non négociable. Ne laissez pas une démonstration solide, un prix d’entrée bas ou une longue liste de fonctionnalités compenser une exigence manquante.
Votre short-list doit normalement contenir différents modèles opérationnels, et non cinq fournisseurs presque identiques. Un ensemble utile de trois à cinq finalistes pourrait inclure :
- Des insights d’avis natifs d’Amazon comme référence de base
- Une suite vendeur large si la consolidation est importante
- Une ou deux plateformes spécialisées d’analyse des avis
- Un flux de travail IA général si l’équipe maîtrise déjà l’ensemble de données
- Une voie API personnalisée si l’analyse doit être intégrée
Inclure une référence de base évite qu’un produit payant ne l’emporte simplement parce qu’il est plus abouti que de ne rien faire. Inclure aussi une alternative crédible de construction ou manuelle révèle également quelle partie du flux de travail payant crée la valeur.
Utilisez un tableau de bord pondéré pour l’analyse des avis Amazon
Une pondération égale masque la décision. Une équipe de mise en ligne, une équipe qualité, un groupe de recherche et une équipe de plateforme de données ne devraient pas obtenir le même score.
Pour l’approvisionnement en analyse comparative et alternatives des avis Amazon, définissez les pondérations avant les démonstrations afin que l’interface la plus soignée ne réécrive pas les exigences.
Utilisez une notation de 0 à 5 pour chaque critère :
- 0 : absent ou inutilisable
- 1 : possible uniquement par un important travail manuel
- 2 : partiellement pris en charge avec des lacunes importantes
- 3 : suffisant pour le pilote
- 4 : solide et reproductible
- 5 : éprouvé dans le flux de travail exact
Appliquez ensuite des pondérations totalisant 100 %. Le score pondéré est :
Score pondéré = somme de (notation du critère / 5 × pondération du critère)
Voici un modèle de départ pratique pour un flux de travail ecommerce récurrent :
| Critère | Pondération | Ce qu’exige une note de 5 |
|---|---|---|
| Couverture des avis et des places de marché | 15 % | Les produits requis, variantes, langues, dates et ensembles de comparaison sont disponibles et documentés |
| Qualité des thèmes et contrôle de la taxonomie | 15 % | Les thèmes sont cohérents, modifiables ou compréhensibles, assez stables pour être comparés, et testés sur votre vocabulaire |
| Preuves textuelles et auditabilité | 15 % | Les utilisateurs peuvent examiner le texte des avis à l’appui et contradictoire sans reconstruire l’analyse |
| Logique de comparaison et de tendance | 10 % | Les produits et les périodes utilisent des dénominateurs, des fenêtres et des libellés cohérents |
| Résultats du flux de travail | 10 % | Les résultats deviennent des synthèses, rapports, alertes, tickets ou dossiers de preuves avec très peu de reformatage |
| Contrôlabilité de la démonstration | 5 % | L’équipe peut imposer la même tâche, le même ensemble d’ASIN, les mêmes filtres, le même résultat et les mêmes règles de preuve pendant l’évaluation |
| Reproductibilité et collaboration | 10 % | Un autre utilisateur qualifié peut relancer le flux de travail et reproduire l’artefact de décision |
| Intégration et exportation | 10 % | Les exportations nécessaires, l’accès API et les connexions système sont disponibles au niveau de plan et à l’échelle requis |
| Gouvernance et sécurité | 5 % | Les exigences d’accès, de conservation, d’autorisations, de traitement et de suppression sont documentées et acceptables |
| Coût total d’exploitation | 5 % | Les coûts d’abonnement, d’utilisation, de main-d’œuvre, d’assurance qualité, de mise en œuvre et de maintenance sont visibles |
Ne considérez pas le score total comme une décision d’achat automatique. Définissez des seuils minimaux pour les critères critiques. Par exemple, un produit qui obtient 88 au total mais seulement 1 en traçabilité des preuves ne devrait pas remporter une décision produit sensible aux preuves.
Modifier les pondérations selon la mission
Ajustez la grille d’évaluation avant de voir les résultats des fournisseurs.
- Optimisation des fiches produit : augmentez les preuves textuelles exactes, la couverture linguistique et les sorties de workflow.
- Suivi de la qualité : augmentez les tendances dans le temps, les filtres de variantes, les alertes et l’auditabilité.
- Étude de la concurrence : augmentez la comparaison multi-ASIN, la clarté de la couverture et la cohérence de la taxonomie.
- Stratégie produit : augmentez la qualité des thèmes, la collaboration et les liens vers des preuves client adjacentes.
- Analytique intégrée : augmentez l’accès à l’API, la fiabilité, la sécurité, l’observabilité et la responsabilité de maintenance.
Établir d’abord les pondérations réduit le risque que la démonstration la plus impressionnante détermine a posteriori les exigences.
Utilisez un script de démonstration contrôlé pour les finalistes
La plupart des démonstrations d’analytics des avis Amazon sont conçues pour montrer le meilleur parcours du produit. C’est normal, mais cela peut donner l’impression que les alternatives sont plus différentes ou plus complètes qu’elles ne le sont réellement. Un script de démonstration contrôlé oblige chaque finaliste à effectuer le même travail avec les mêmes contraintes.
Utilisez ce script après les premiers filtres de présélection et avant la preuve sur 14 jours. Le but n’est pas de finaliser l’achat en une seule réunion. Il s’agit de vérifier si chaque finaliste peut fonctionner dans votre standard de preuves sans traitement particulier.
| Bloc de démonstration | Ce qu’il faut demander au finaliste de faire | Ce qu’il faut consigner |
|---|---|---|
| Confirmation du corpus | Afficher les ASIN analysés, la place de marché, la période de dates, le nombre d’avis, les filtres et les exclusions | Si le dénominateur est visible et si l’équipe peut reproduire le même corpus ultérieurement |
| Extraction des thèmes | Identifier les principaux mécanismes de plainte et les principaux différenciateurs positifs | Si les libellés sont suffisamment précis pour être transmis aux responsables produit, fiche produit, support ou qualité |
| Analyse approfondie des preuves | Ouvrir les avis sources derrière trois affirmations importantes et un contre-exemple | Si le texte exact de l’avis, la note, la date, l’ASIN, la place de marché et le contexte restent associés |
| Vue des changements récents | Comparer une période récente à une période de référence | Si les évolutions de tendance utilisent des fenêtres et des dénominateurs cohérents |
| Comparaison concurrentielle | Comparer l’ASIN cible à deux alternatives en utilisant la même taxonomie | Si le workflow normalise le volume d’avis et les différences de produit |
| Gestion de l’ambiguïté | Classer cinq avis mixtes ou ambigus issus de l’ensemble de référence | Si l’incertitude reste visible ou est transformée en libellés excessivement confiants |
| Transfert de la sortie | Exporter ou générer l’élément requis : synthèse, tableau, alerte, ticket, tableau de bord ou réponse API | Si le résultat est exploitable en dehors de l’interface de démonstration |
| Administration et gouvernance | Afficher les rôles, les paramètres de conservation, les contrôles d’export, l’historique d’audit et la documentation API ou d’intégration | Si le workflow peut passer la revue de sécurité et être pris en charge opérationnellement |
Remettez le script au fournisseur ou à l’équipe de développement interne avant la démonstration. Un finaliste ne doit pas être pénalisé pour avoir besoin d’un temps de configuration raisonnable, mais il doit l’être s’il ne peut pas afficher le corpus, les preuves, le dénominateur, la sortie ou les contrôles requis par la décision.
Créer un dossier d’acceptation par finaliste
Ne laissez pas l’évaluation sous forme de notes dans un tableur d’achat. Créez un petit dossier d’acceptation pour chaque finaliste :
| Élément du dossier | Contenu requis |
|---|---|
| Manifeste d’entrée | ASIN, place de marché, date d’extraction, période de dates, filtres, nombre d’avis, exclusions et méthode d’accès aux données |
| Livrable de sortie | Le livrable exact que l’entreprise utiliserait, et non un simple résumé de démonstration sous forme de capture d’écran |
| Annexe de preuves | Avis sources derrière les principales affirmations, contre-exemples et au moins cinq cas limites audités |
| Grille d’évaluation | Notes pondérées, résultats des seuils minimaux et raisons des notes faibles |
| Journal des désaccords | Différences matérielles par rapport à l’ensemble de référence codé par des humains et impact sur la recommandation |
| Estimation opérationnelle | Temps de configuration, temps analyste, temps QA, travail d’ingénierie, cadence récurrente et maintenance attendue |
| Note de risque | Lacunes de couverture, préoccupations de gouvernance, limites d’export, risques de dépendance et hypothèses nécessitant confirmation |
Ce dossier est également utile lorsque l’acheteur ne choisit pas un fournisseur. Si les alternatives sont une analyse manuelle, un workflow d’IA généraliste, une plateforme spécialisée et un pipeline API sur mesure, le dossier permet de garder la comparaison honnête. Chaque option doit produire les mêmes éléments de preuve décisionnels.
Signaux d’alerte pendant la démo
Surveillez les modes de défaillance suivants :
- La démo ne peut pas montrer quelles avis ont été inclus.
- Les graphiques importants ne peuvent pas être reliés à des preuves au niveau des avis.
- Le système regroupe des mécanismes distincts sous des libellés vagues tels que « problème de qualité ».
- Les comparaisons avec les concurrents utilisent des fenêtres différentes ou des filtres cachés.
- Le résultat ne fonctionne que comme capture d’écran ou diapositive modifiée manuellement.
- L’export supprime les identifiants des preuves, les définitions de taxonomie, les fenêtres de dates ou les commentaires.
- Les avis ambigus sont forcés à entrer dans des affirmations assurées sans champ de confiance.
- Le fournisseur promet qu’une API ou un export peut prendre en charge le workflow, mais ne peut pas montrer les champs, les limites ou le schéma.
- Une correction humaine améliore la démo, mais ne peut pas être enregistrée, versionnée ou reproduite.
- Les contrôles de gouvernance sont évoqués verbalement mais ne sont pas montrés dans le produit ni dans la documentation.
Ce ne sont pas des critères d’exclusion automatiques pour chaque équipe. Un projet ponctuel d’analyste peut tolérer davantage de reconstruction manuelle qu’un workflow opérationnel hebdomadaire. Mais les signaux d’alerte doivent être pris en compte dans le coût de la main-d’œuvre, l’assurance qualité, la migration et le risque.
Transformer la démo en décision go, go sous conditions ou no-go
Terminez chaque évaluation de finaliste avec l’un des trois statuts suivants :
| Statut | À utiliser lorsque | Action suivante |
|---|---|---|
| Go pour la preuve | Le finaliste passe les contrôles non négociables de couverture, de preuves, de workflow et de gouvernance | Incluez-le dans la preuve de 14 jours avec le même ensemble d’ASIN et l’artefact requis |
| Go sous conditions | Le finaliste est prometteur mais présente un écart spécifique qui peut être testé rapidement | Lancez un suivi ciblé, tel qu’un contrôle d’export, une revue du schéma API ou un test de contrôle de taxonomie |
| No-go | Le finaliste ne peut pas préserver les preuves ou produire le résultat de workflow requis | Retirez-le de la liste restreinte, même si l’interface ou le prix paraît attractif |
Le statut doit citer des preuves observées. « L’équipe a aimé » n’est pas une décision. « No-go parce que les trois principaux thèmes n’ont pas pu être reliés aux avis sources ni exportés avec des fenêtres de dates » en est une.
Ajouter un test d’acceptation du workflow en conditions réelles
Une démo contrôlée prouve qu’un finaliste peut fonctionner sous observation. Un test d’acceptation du workflow en conditions réelles prouve que l’équipe peut utiliser le résultat après la fin de l’appel.
Exécutez ce test avec chaque finaliste avant la validation des achats :
| Test d’acceptation | Condition de réussite | Pourquoi c’est important |
|---|---|---|
| Transmission au propriétaire | Un propriétaire non analyste peut lire l’artefact et identifier la prochaine action recommandée, les points à revoir et les questions ouvertes | Le résultat subsiste en dehors de la session de l’analyste ou du fournisseur |
| Vérification des preuves | Une partie prenante peut cliquer sur les preuves sous-jacentes à trois affirmations principales et à un contre-exemple, ou les ouvrir | L’équipe peut défendre le résultat lors de la planification ou de l’examen qualité |
| Contrôle de relance | Un second utilisateur peut relancer le même flux de travail et reproduire la réponse pertinente pour la décision, ou expliquer les changements contrôlés | Le flux de travail ne dépend pas d’un seul opérateur expert |
| Reconstruction de l’export | Le fichier exporté ou la réponse de l’API contient suffisamment d’ID, d’étiquettes, de fenêtres et de champs de preuve pour reconstruire le constat | L’équipe peut auditer, migrer ou associer les résultats à un autre système |
| Simulation d’échec | L’équipe sait ce qui se passe lorsqu’un produit a peu d’avis, une langue mixte, une ambiguïté de variantes ou des schémas suspects | Les cas limites restent visibles au lieu de se transformer en résumés trop confiants |
C’est la ligne pratique entre une démonstration utile et un processus opérationnel exploitable. Pour l’analyse des avis Amazon, un outil qui échoue au test d’acceptation devrait rester dans un rôle exploratoire, même s’il propose des graphiques attrayants.
Comparez le coût total d’exploitation, pas le prix de l’abonnement
Les alternatives d’analyse des avis Amazon déplacent le travail entre les logiciels, les analystes, les opérateurs et les ingénieurs. Une comparaison équitable les inclut tous.
Le modèle de coût le plus utile pour Amazon review analytics: comparison and alternatives mesure les décisions finalisées, pas seulement les sièges, les crédits ou le volume d’avis.
Estimez le coût annuel d’exploitation avec ces catégories :
| Catégorie de coût | Inclure |
|---|---|
| Plateforme | Abonnement, sièges, usage, limites de données, modules complémentaires et niveau de forfait requis |
| Mise en œuvre | Configuration, conception de la taxonomie, imports historiques, intégrations, formation et documentation |
| Travail d’analyse | Collecte, nettoyage, prompting, codage, revue, vérification des preuves et production de rapports |
| Assurance qualité | Audits par échantillonnage, revue des désaccords, vérifications des faux positifs, maintenance de la taxonomie et tests d’acceptation |
| Ingénierie | Travail sur l’API, pipelines de données, orchestration, stockage, surveillance, réponse aux incidents et mises à niveau |
| Gouvernance | Revue de sécurité, administration des accès, conservation, suppression, revue juridique et gestion des fournisseurs |
| Coût du changement | Refonte du flux de travail, migration, adoption par les parties prenantes et fonctionnement en parallèle pendant le déploiement |
Pour chaque finaliste, calculez :
Coût annuel d’exploitation = plateforme + amortissement de la mise en œuvre + main-d’œuvre + assurance qualité + ingénierie + gouvernance + coût du changement
Puis divisez par les artefacts de décision finalisés, et non par le nombre d’avis traités :
Coût par décision finalisée = coût annuel d’exploitation / artefacts de décision acceptés
Un outil de synthèse à faible coût peut devenir coûteux si les analystes reconstruisent sans cesse les preuves, réconcilient les taxonomies et reformattent les résultats. Une plateforme plus onéreuse peut néanmoins constituer le modèle d’exploitation le moins cher si elle élimine le travail récurrent. L’inverse est également vrai : une plateforme spécialisée est inutile lorsque l’équipe n’a besoin que de deux analyses ciblées par an.
Utilisez le calculateur de ROI de l’extraction d’avis produits lorsque vous devez modéliser plus en détail la charge de travail, le délai de rentabilité et les bénéfices pondérés par la confiance.
Testez la capacité de sortie avant de vous engager
La plupart des comparaisons d’analytics des avis Amazon se concentrent sur la manière d’intégrer les données dans un outil. Une décision de production doit aussi tester la manière dont les preuves en ressortent.
Ce n’est pas seulement une question d’achat. Votre flux de travail peut changer parce qu’une équipe se réorganise, qu’une place de marché ou une intégration évolue, qu’un fournisseur modifie son produit, qu’une norme de données interne mûrit, ou qu’un meilleur modèle d’exploitation devient disponible. Si les preuves, la taxonomie et l’historique des décisions ne peuvent pas vous accompagner, le vainqueur apparent peut créer plus tard un deuxième projet de mise en œuvre.
Ajoutez un score de capacité de sortie à la comparaison avant la décision de contrat ou de déploiement. Attribuez à chaque ligne une note de 0 à 2 :
- 0 : indisponible ou visible uniquement dans l’interface
- 1 : partiellement disponible, aplati, ou dépendant d’un travail manuel
- 2 : exportable dans un format documenté et réutilisable
| Test de capacité de sortie | Ce qu’un résultat réutilisable doit préserver | Pourquoi c’est important |
|---|---|---|
| Preuves sources | Texte de l’avis ou référence source approuvée, ID de preuve stable, ASIN, note, date, marketplace, variation et tout autre contexte disponible | Permet de conserver l’auditabilité des thèmes après changement d’interface |
| Analyse codée | Affectation au thème, mécanisme, sentiment, confiance, version de l’analyste ou du modèle, et exceptions | Évite qu’une migration ne se réduise à nouveau à du texte brut |
| Taxonomie | Noms des thèmes, définitions, hiérarchie, alias, exclusions et historique des versions | Préserve le sens des courbes de tendance et des comparaisons |
| Métriques dérivées | Numérateurs, dénominateurs, filtres, fenêtres de dates, ensemble de comparaison et notes de calcul | Rend les tableaux de bord reproductibles plutôt que décoratifs |
| Enregistrements du flux de travail | Responsables, statuts, commentaires, décisions, artefacts liés et dates de revue | Conserve le lien entre l’insight, l’action et la responsabilité |
| Configuration de diffusion | Requêtes enregistrées, règles d’alerte, planifications, webhooks, mappages d’API et destinations | Révèle le travail opérationnel nécessaire pour reconstruire le flux de travail |
| Enregistrements de gouvernance | Rôles, autorisations, historique d’audit, règles de conservation et état de suppression, lorsque disponibles | Prend en charge l’examen de sécurité et la passation contrôlée |
| Documentation | Définitions des champs, format d’export, version de l’API ou du schéma, limites et omissions connues | Permet à une autre équipe d’interpréter le package sans dépendre de connaissances informelles |
Ne récompensez pas un export massif simplement parce qu’il contient de nombreuses colonnes. Le test consiste à savoir si un autre analyste peut reproduire un artefact de décision accepté à partir du package exporté sans rouvrir l’outil d’origine.
Exécutez un exercice d’export de 60 minutes
Utilisez le même ASIN principal et la même question de décision que pour la preuve sur 14 jours.
- Demandez l’export standard. Ne demandez pas une mission de services sur mesure ni un extrait d’ingénierie ponctuel. Testez ce qu’un simple titulaire de compte peut récupérer.
- Retracez cinq conclusions importantes. Pour chaque thème, localisez les preuves d’avis à l’appui, le contexte produit, la fenêtre de dates, la définition taxonomique et la base de calcul.
- Reconstituez un livrable en dehors de l’outil. Recréez un tableau de priorisation des plaintes, un brief sur la langue des listings, un tableau des écarts concurrentiels ou un transfert de suivi à partir des fichiers exportés.
- Consignez ce qui disparaît. Notez les liens de preuve manquants, le texte d’avis tronqué, les filtres perdus, les hiérarchies aplaties, les scores non documentés, les commentaires inaccessibles et la logique d’alerte qui doit être reconstruite manuellement.
- Estimez le temps de reconstruction. Ajoutez les heures nécessaires pour nettoyer, mapper, valider, documenter et restaurer le flux de travail. Inscrivez cette estimation dans la ligne de coût de changement du modèle de coût opérationnel.
Un finaliste réussit l’exercice d’export lorsque l’équipe peut expliquer l’ensemble de données, reproduire l’artefact choisi et identifier chaque limitation importante. Un CSV brut sans définitions ne suffit pas. Une capture d’écran ne suffit pas. Une promesse selon laquelle « l’API peut probablement le faire » ne suffit pas tant que les champs et les limites n’ont pas été démontrés.
Pour les options pilotées par API, examinez le schéma maintenu plutôt que de vous fier à une description commerciale. Amazon publie les modèles de son Selling Partner API, y compris le modèle Customer Feedback API. Une API spécialisée doit offrir la même clarté pour les champs source, les champs analysés, les versions, l’authentification, les quotas, les erreurs et le comportement de suppression pertinents pour votre flux de travail.
Utilisez un plan de migration sur 30 jours pour les deux dernières options
La meilleure comparaison n’attend pas une résiliation future pour découvrir s’il est possible de changer. Menez une répétition de migration bornée entre les deux derniers modèles opérationnels.
Jours 1 à 5 : inventorier le flux de travail actuel
- Listez chaque entrée, vue enregistrée, taxonomie, rapport récurrent, alerte, intégration, propriétaire et artefact de décision en aval.
- Marquez les enregistrements qui doivent être conservés pour l’audit, la continuité des tendances ou l’usage opérationnel.
- Gelez un jeu de comparaison et une fenêtre de dates afin que les deux systèmes soient évalués sur les mêmes preuves.
- Définissez le déclencheur de retour arrière avant toute mise en production.
Jours 6 à 10 : exporter et mapper
- Exportez les preuves sources, l’analyse codée, la taxonomie, les métriques dérivées et les enregistrements de flux de travail.
- Mettez en correspondance les champs source avec le schéma cible et étiquetez les champs sans équivalent.
- Séparez la véritable perte de données des différences de présentation.
- Documentez les transformations afin que le résultat migré puisse être rejoué.
Jours 11 à 20 : exécuter en parallèle une décision récurrente
- Faites fonctionner l’ancienne et la nouvelle approche sur la même nouvelle fenêtre d’avis.
- Comparez la couverture, les affectations de thèmes, la récupération des preuves, les dénominateurs, la direction des tendances et les recommandations finales.
- Enquêtez sur les désaccords plutôt que de les lisser par une moyenne.
- Suivez le temps des analystes, le temps d’assurance qualité, le travail d’ingénierie et les transferts de responsabilité dans les deux flux de travail.
Jours 21 à 25 : appliquer les critères d’acceptation
Nécessite une validation sur :
- Traçabilité des preuves pour les constats les plus prioritaires
- Mappage de la taxonomie et discontinuités connues
- Métriques reproductibles et fenêtres de dates
- Exports, intégrations, autorisations et alertes requis
- Responsables nommés pour les exceptions et les tâches échouées
- Un plan d’archivage et de conservation documenté
Jours 26-30 : basculer ou arrêter
Ne basculez que si la cible prend en charge le véritable flux de décision et si le package de migration est compréhensible en dehors de l’équipe de mise en œuvre. Conservez l’ancien système en lecture seule pendant la période de conservation convenue lorsque cela est autorisé et utile. Arrêtez ou revenez en arrière si les preuves prioritaires manquent, si la continuité des tendances ne peut pas être expliquée, si les résultats requis échouent ou si la charge opérationnelle dépasse le modèle approuvé.
Cette répétition fait passer le risque de migration d’une question d’achat vague à un travail observé. Elle met aussi en évidence une alternative utile : si aucun des deux finalistes ne peut préserver les preuves et les enregistrements de flux de travail dont vous avez besoin, une couche de données gouvernée plus petite peut être plus précieuse qu’un tableau de bord supplémentaire.
Un arbre de décision simple
Utilisez cette séquence pour réduire les alternatives.
Étape 1 : s’agit-il d’une décision unique et limitée ?
Si oui, commencez par une analyse manuelle ou par un assistant IA généraliste. N’achetez pas un système d’exploitation pour une question ponctuelle.
Étape 2 : la vue native d’Amazon peut-elle y répondre ?
Si la décision est spécifique à Amazon et que Customer Review Insights fournit suffisamment de contexte produit, niche, sujet, extrait et tendance, utilisez d’abord le flux de travail natif.
Étape 3 : avez-vous besoin du reste d’une suite vendeur ?
Si les outils de mots-clés, de fiche produit, de recherche produit, de publicité et d’exploitation sont également prioritaires, comparez les suites larges sur l’ensemble des tâches combinées.
Étape 4 : l’intelligence des avis est-elle récurrente et transversale ?
Si le produit, le marketing, le support, la recherche ou la direction ont besoin à répétition des mêmes preuves, évaluez une plateforme spécialisée.
Étape 5 : les informations doivent-elles alimenter des systèmes propriétaires ?
Si oui, comparez l’accès API spécialisé avec un pipeline personnalisé. N’optez pour un développement sur mesure que lorsque le niveau de contrôle requis justifie la charge d’ingénierie et de gouvernance.
Exécutez une preuve de 14 jours avant de vous engager
Testez les finalistes sur la même décision et le même ensemble de produits.
Jours 1-2 : définir le test
- Choisissez une décision
- Sélectionnez votre ASIN et deux à cinq concurrents pertinents
- Verrouillez la fenêtre temporelle
- Définissez cinq à dix thèmes attendus
- Décidez quelles preuves doivent être conservées
- Nommez le flux de travail actuel que le finaliste doit surpasser, y compris les étapes manuelles et le temps des responsables
Jours 3-7 : exécuter chaque approche
Suivez :
- Temps de configuration
- Avis ou produits couverts
- Précision des thèmes
- Temps nécessaire pour récupérer les preuves
- Capacité à trouver des contre-exemples
- Utilité des comparaisons et des tendances
- Effort d’export ou de transmission
- Quelles étapes actuelles seraient abandonnées, réduites ou conservées
Jours 8-10 : auditer la sortie
Examinez manuellement un échantillon d’avis sources. Recherchez les thèmes manqués, les étiquettes incorrectes, les résumés trop généraux, les catégories en double et les conclusions fondées sur des preuves insuffisantes.
Jours 11-14 : produire un livrable réel
Créez l’artefact dont l’entreprise a besoin : un résumé de changement produit, un brief sur le langage de la fiche produit, un tableau des écarts concurrentiels, une enquête qualité ou un rapport de surveillance.
La meilleure approche est celle qui produit un artefact de décision fiable avec le moins de travail répété et le chemin de remplacement le plus clair, et non la démonstration la plus impressionnante.
Définissez l’acceptation en production avant la fin du pilote
Un bon pilote peut néanmoins échouer en production si l’équipe ne définit jamais la responsabilité et les niveaux de service. Avant la sélection, rédigez une fiche d’acceptation pour le flux de travail en production.
Incluez :
- Responsable : qui exécute l’analyse et qui approuve l’artefact de décision
- Cadence : unique, hebdomadaire, mensuelle, déclenchée par un lancement ou déclenchée par un incident
- Entrées : produits, concurrents, places de marché, langues, fenêtres de dates et jeux de données connectés
- Norme de preuve : nombre d’exemples sources, de contre-exemples et de vérifications manuelles requis
- Sortie : le briefing, tableau de bord, alerte, ticket ou réponse API exacts que reçoivent les utilisateurs en aval
- Seuil de qualité : précision acceptable des thèmes, taux de thèmes manqués, taux d’affirmations non étayées et processus de désaccord des analystes
- Chemin d’échec : ce qui se passe lorsque les données sont incomplètes, que la taxonomie change ou que la sortie du modèle n’est pas fiable
- Contrôle des changements : qui peut modifier les invites, étiquettes, règles, modèles ou intégrations
- Surveillance : quels signaux de couverture, latence, erreur, dérive et adoption sont examinés
- Plan de sortie : comment les données, taxonomies, preuves et flux de travail peuvent être exportés ou migrés
Traitez la documentation du fournisseur, les réponses de sécurité et les résultats du pilote comme des preuves pour cette fiche. Une promesse verbale faite pendant une démo n’est pas un contrôle de production.
Définissez des seuils minimaux avant d’examiner le score final
Les tableaux de bord pondérés sont utiles, mais ils peuvent lisser des faiblesses éliminatoires. Définissez des seuils minimaux qui ne peuvent pas être compensés par des points forts sans rapport.
Pour un flux de travail récurrent d’analyse des avis Amazon, commencez avec ces seuils :
| Seuil | Preuve minimale acceptable |
|---|---|
| Clarté du corpus | Les produits analysés, la place de marché, les dates, le nombre d’avis, les filtres et les exclusions sont visibles ou exportables |
| Traçabilité au niveau des avis | Les thèmes importants renvoient au langage client d’origine, et pas seulement à des résumés générés |
| Comparaison cohérente | Les produits de référence et concurrents utilisent la même fenêtre, le même dénominateur et la même taxonomie, sauf si des exceptions sont divulguées |
| Analyse des changements récents | Le flux de travail peut distinguer le volume cumulé d’un changement récent |
| Sortie de décision | Le résultat peut devenir un artefact de décision sans assemblage manuel de captures d’écran |
| Conformité à la gouvernance | L’accès, la conservation, les exportations, l’utilisation de l’API et la gestion des avis sont conformes aux règles de la plateforme et à la politique interne |
| Capacité de sortie | Les preuves, la taxonomie et les résultats peuvent être exportés avec une structure suffisante pour migrer ou auditer |
Un finaliste qui échoue à l’un de ces seuils peut encore être envisagé pour un projet ponctuel. Il ne devrait pas gagner un flux de travail récurrent et transversal à plusieurs équipes, sauf si l’équipe accepte explicitement le travail manuel et le risque.
Formulez la recommandation finale sous forme de mémo décisionnel
Le document de sélection doit être suffisamment court pour être relu et suffisamment précis pour être audité. Utilisez cette structure :
Pour les décisions d’analyse des avis Amazon : comparaison et alternatives, la note doit expliquer pourquoi le modèle opérationnel sélectionné a été retenu face au point de référence natif et à la meilleure alternative crédible.
- Décision : l’approche d’analyse des avis Amazon retenue.
- Périmètre : produits, places de marché, équipes, décisions et intégrations inclus.
- Alternatives envisagées : les trois à cinq finalistes et pourquoi chacun a été conservé.
- Preuves : scores pondérés, résultats des contrôles, échantillons d’audit et l’artefact réel produit pendant la preuve.
- Coût : coût opérationnel de la première année et coût récurrent, avec la main-d’œuvre et l’assurance qualité visibles.
- Risques : lacunes de couverture, dépendances du flux de travail, préoccupations de gouvernance et hypothèses qui doivent encore être validées.
- Déploiement : responsable, premier cas d’usage, seuils d’acceptation, date de revue et conditions d’extension.
- Critères de sortie : les conditions qui déclencheraient un retour arrière, un remplacement ou une décision de développement.
Cela transforme « nous avons aimé l’outil » en une décision qu’une autre partie prenante peut contester, approuver et réexaminer.
Traitez les avis comme des signaux, pas comme une enquête représentative
Les avis Amazon sont des commentaires clients auto-sélectionnés. Ils sont précieux car ils contiennent des expériences spécifiques, des modes de défaillance, des attentes et du langage. Ils ne doivent pas être automatiquement considérés comme une estimation représentative de l’opinion de chaque acheteur.
Les recommandations méthodologiques en matière d’enquêtes distinguent les échantillons probabilistes des échantillons non probabilistes ou de type opt-in, car la probabilité de sélection n’est pas connue dans ces derniers. La même prudence est utile ici : la fréquence des avis peut prioriser l’investigation, mais elle ne prouve pas à elle seule la prévalence dans la population ni l’impact commercial.
Renforcez les résultats des avis avec d’autres preuves lorsque c’est possible :
- Motifs de retour
- Contacts avec le support
- Réclamations au titre de la garantie
- Analyses produit
- Données de ventes et de conversion
- Enregistrements de contrôle qualité
- Études clients structurées
Utilisez l’analyse des avis pour trouver et expliquer des signaux. Utilisez des données opérationnelles appariées ou des tests contrôlés pour valider l’impact.
Questions fréquemment posées
Qu’est-ce que l’analyse des avis Amazon ?
L’analyse des avis Amazon consiste à organiser le texte des avis, les notes, les dates, les produits, les variantes et le langage client en éléments de preuve qui soutiennent une décision. Une analyse utile va au-delà des totaux de sentiment. Elle identifie les thèmes et les mécanismes, conserve les liens vers les avis स्रोत, compare les produits selon des règles cohérentes et distingue les volumes récurrents des changements récents.
Quelle est la meilleure alternative à l’analyse manuelle des avis Amazon ?
La meilleure alternative dépend de la tâche récurrente. Utilisez les informations natives d’Amazon pour une question étroite dans Seller Central, une suite vendeur lorsque l’analyse des avis s’inscrit dans un flux de travail vendeur plus large, une plateforme spécialisée pour une veille sur les avis reproductible à l’échelle des équipes, et un pipeline API lorsque le résultat doit être intégré dans des systèmes propriétaires. Un assistant IA généraliste ne peut accélérer l’analyse qu’après la mise en place d’un jeu de données licite et contrôlé ainsi que d’un processus d’audit des preuves.
Les synthétiseurs d’avis Amazon sont-ils la même chose que les outils d’analyse des avis ?
Non. Un outil de synthèse compresse le texte des avis. Un workflow d’analytics doit aussi définir le corpus, conserver les preuves au niveau des avis, permettre une comparaison cohérente, gérer les dates et les segments, produire des livrables réutilisables et permettre à un autre analyste de relancer ou de contester le résultat. Les synthèses peuvent faire partie du workflow, mais elles n’en constituent pas l’ensemble.
Dois-je choisir les outils natifs d’Amazon ou un logiciel tiers ?
Commencez par la base native lorsqu’elle couvre les produits, la place de marché, la période et la décision qui vous importent. Testez un logiciel tiers lorsque vous avez besoin d’une comparaison plus large, de taxonomies personnalisées, de rapports récurrents, de collaboration, de preuves cross-canal, d’exports, de surveillance ou d’une intégration dans un autre système. Une alternative payante doit l’emporter parce qu’elle complète mieux le workflow de décision, et non parce que son tableau de bord paraît plus soigné.
Helium 10 Review Insights est-il une alternative d’analytics d’avis Amazon ?
Oui, mais évaluez-le comme un workflow d’avis au sein d’une suite pour vendeurs, et non comme une plateforme autonome de renseignement sur les avis. Sa documentation actuelle indique que Review Insights est alimenté par l’API Customer Feedback d’Amazon, ce qui peut être utile lorsque les sujets de feedback natifs d’Amazon sont la bonne entrée. La vraie question de comparaison est de savoir si ce workflow vendeur alimenté par API vous apporte suffisamment de traçabilité des preuves, de contrôle de la comparaison, d’exports et de transmission de décision pour le travail dont vous avez besoin.
Comment comparer équitablement des outils d’analytics d’avis Amazon ?
Donnez à chaque finaliste les mêmes ASIN, la même fenêtre de dates, les mêmes cas limites connus, la même question de décision et le même livrable requis. Créez un petit ensemble de référence codé par des humains, répétez le test sans modifier l’entrée et consignez les divergences matérielles. Définissez les pondérations avant les démonstrations. Évaluez la couverture, l’accord sur les thèmes, la stabilité d’une exécution à l’autre, la traçabilité des preuves, la logique de comparaison, la prise en compte des tendances, les livrables, la gouvernance, l’intégration, le coût d’exploitation et le risque de migration. Rejetez toute option qui échoue sur un critère non négociable, même si son score fonctionnel total est élevé.
Que devrait contenir un dossier d’achat pour l’analytics des avis Amazon ?
Un dossier d’achat pour l’analytics des avis Amazon devrait inclure la question de décision, les ASINs focal et de comparaison, la place de marché, la fenêtre de dates, l’objectif de volume d’avis, les règles de preuve, la base native, la justification de la shortlist, les artefacts de démonstration, les objections des parties prenantes, les résultats des étapes de validation, l’estimation du coût d’exploitation et des notes sur la réversibilité. Le dossier doit permettre à un relecteur d’inspecter les preuves sources, de comprendre le dénominateur, de contester la comparaison et de décider si le finaliste doit entrer dans une preuve de 14 jours.
Quand dois-je remplacer mon workflow actuel d’analytics des avis Amazon ?
Remplacez le workflow actuel lorsqu’il perd de façon répétée les preuves sources, masque les règles du dénominateur, ne peut pas comparer les produits de manière cohérente, exige une reconstruction manuelle pour chaque décision, échoue à l’examen de gouvernance ou ne peut pas exporter la taxonomie et l’historique des preuves avant le renouvellement. Réduisez sa portée ou corrigez-le plutôt lorsque le workflow prend encore en charge une tâche précise mais qu’on lui demande d’en faire plus que ce pour quoi il a été conçu.
Combien devrait coûter un logiciel d’analytics des avis Amazon ?
Le prix de l’abonnement à lui seul n’est pas un critère de comparaison fiable. Calculez le coût total d’exploitation : coût de la licence ou de l’API, temps des analystes, préparation des données, contrôle qualité, ingénierie, gouvernance, formation, maintenance et coût du changement. Divisez ce total par une unité utile, comme le nombre de cycles de décision achevés, d’ASIN surveillés ou de livrables approuvés. Utilisez une preuve de 14 jours pour vérifier si le flux de travail réduit réellement les tâches répétitives.
Les avis Amazon peuvent-ils prouver à quel point un problème client est courant ?
Pas à eux seuls. Les avis sont un retour d’information auto-sélectionné, donc la fréquence est un signal d’investigation plutôt qu’une estimation automatique de la prévalence sur l’ensemble des acheteurs. Conservez le dénominateur et la fenêtre temporelle, puis validez les résultats importants à l’aide des retours, des contacts avec le support, des réclamations de garantie, des analyses produit, des tests contrôlés ou d’une recherche structurée lorsque c’est possible.
Liste de contrôle finale pour comparer les alternatives d’analyse des avis Amazon
Avant de choisir, vérifiez que vous pouvez répondre à ces questions :
- Quel ensemble exact d’avis est analysé ?
- Le finaliste utilise-t-il des données de sujets natives d’Amazon, le texte brut des avis, une analyse propriétaire, ou un mélange ?
- Chaque finaliste a-t-il produit le même dossier de preuves minimal viable ?
- Chaque finaliste a-t-il produit le même dossier d’achat avant la réunion de présélection ?
- Puis-je examiner les avis derrière chaque thème important ?
- Puis-je comparer les produits à l’aide de dénominateurs et de fenêtres temporelles cohérents ?
- Puis-je distinguer le volume cumulé de l’évolution récente ?
- Puis-je personnaliser ou au moins comprendre la taxonomie ?
- Le résultat peut-il s’intégrer dans le flux de travail où les décisions sont prises ?
- Un autre analyste peut-il relancer le travail ?
- Une exécution répétée préserve-t-elle la décision ou explique-t-elle pourquoi elle a changé ?
- Avons-nous comparé le résultat à un ensemble de référence codé par des humains ?
- Pouvons-nous diagnostiquer les désaccords matériels sans reconstruire l’analyse manuellement ?
- Chaque finaliste a-t-il suivi le même script de démonstration avec les mêmes ASIN, fenêtres de dates, règles de preuve et résultat requis ?
- Chaque finaliste a-t-il prouvé quelles étapes actuelles du flux de travail il supprimerait, réduirait ou laisserait inchangées ?
- Les parties prenantes produit, e-commerce, qualité, recherche, ingénierie, sécurité et finance ont-elles examiné les preuves pertinentes pour leur risque ?
- Le finaliste choisi a-t-il passé un test de transfert en flux de travail réel avec un responsable non analyste ?
- Le processus est-il conforme aux règles de la plateforme et à la gouvernance interne ?
- L’outil remplace-t-il un travail répétitif ou ajoute-t-il simplement un tableau de bord supplémentaire ?
- Puis-je prouver la valeur avec un seul artefact de décision réel ?
- Ai-je comparé trois à cinq finalistes en utilisant des pondérations définies avant les démonstrations ?
- Ai-je inclus le coût de la main-d’œuvre, du contrôle qualité, de l’ingénierie, de la gouvernance et du changement ?
- Existe-t-il un responsable nommé et une fiche d’acceptation de production ?
- Avons-nous défini des seuils minimaux avant d’examiner le score pondéré ?
- Pouvons-nous exporter les preuves et la taxonomie si le flux de travail change ?
Si une intelligence récurrente des avis Amazon est la couche manquante dans votre flux de travail, utilisez ce guide de comparaison et d’alternatives pour l’analyse des avis Amazon comme référence de décision, puis découvrez l’analyse de la voix du client de VOC AI, comparez les signaux d’avis dans un flux de travail de recherche produit, ou évaluez l’API Review Analysis pour une approche intégrée.