A análise de avaliações da Amazon deve fazer mais do que resumir um monte de comentários. Para equipes que procuram por análise de avaliações da Amazon: comparação e alternativas, a verdadeira pergunta é qual abordagem pode ajudar você a decidir o que mudar, o que investigar e com o que não reagir de forma exagerada.
Por isso, a melhor alternativa nem sempre é o produto com a lista de recursos mais longa. Uma planilha pode ser suficiente para uma decisão de lançamento. As ferramentas nativas da Amazon podem cobrir uma questão de categoria. Uma plataforma especializada de análise de avaliações pode fazer mais sentido quando várias equipes precisam de evidências repetíveis. Um pipeline de API pode ser justificado quando a inteligência de avaliações precisa fluir para seus próprios sistemas.
Atualizado em 11 de agosto de 2026, este guia compara seis abordagens para a análise de avaliações da Amazon com base no trabalho que elas podem apoiar de forma confiável:
- Leitura manual e planilhas
- Assistentes de IA de uso geral
- Insights de avaliações nativos da Amazon
- Suítes amplas para vendedores da Amazon
- Plataformas especializadas de análise de avaliações
- Pipelines personalizados de API
O objetivo não é coroar um vencedor universal. É ajudar você a escolher a abordagem mais simples que possa responder à sua pergunta de decisão sem ocultar as evidências. Você também terá um método para reduzir uma longa lista a três a cinco finalistas, pontuando-os com pesos específicos da decisão, avaliando a reprodutibilidade, estimando o custo operacional, testando opções nativas/potencializadas por API, testando a capacidade de exportação, executando um roteiro de demonstração com o fornecedor e levando o vencedor para produção sem lock-in evitável.
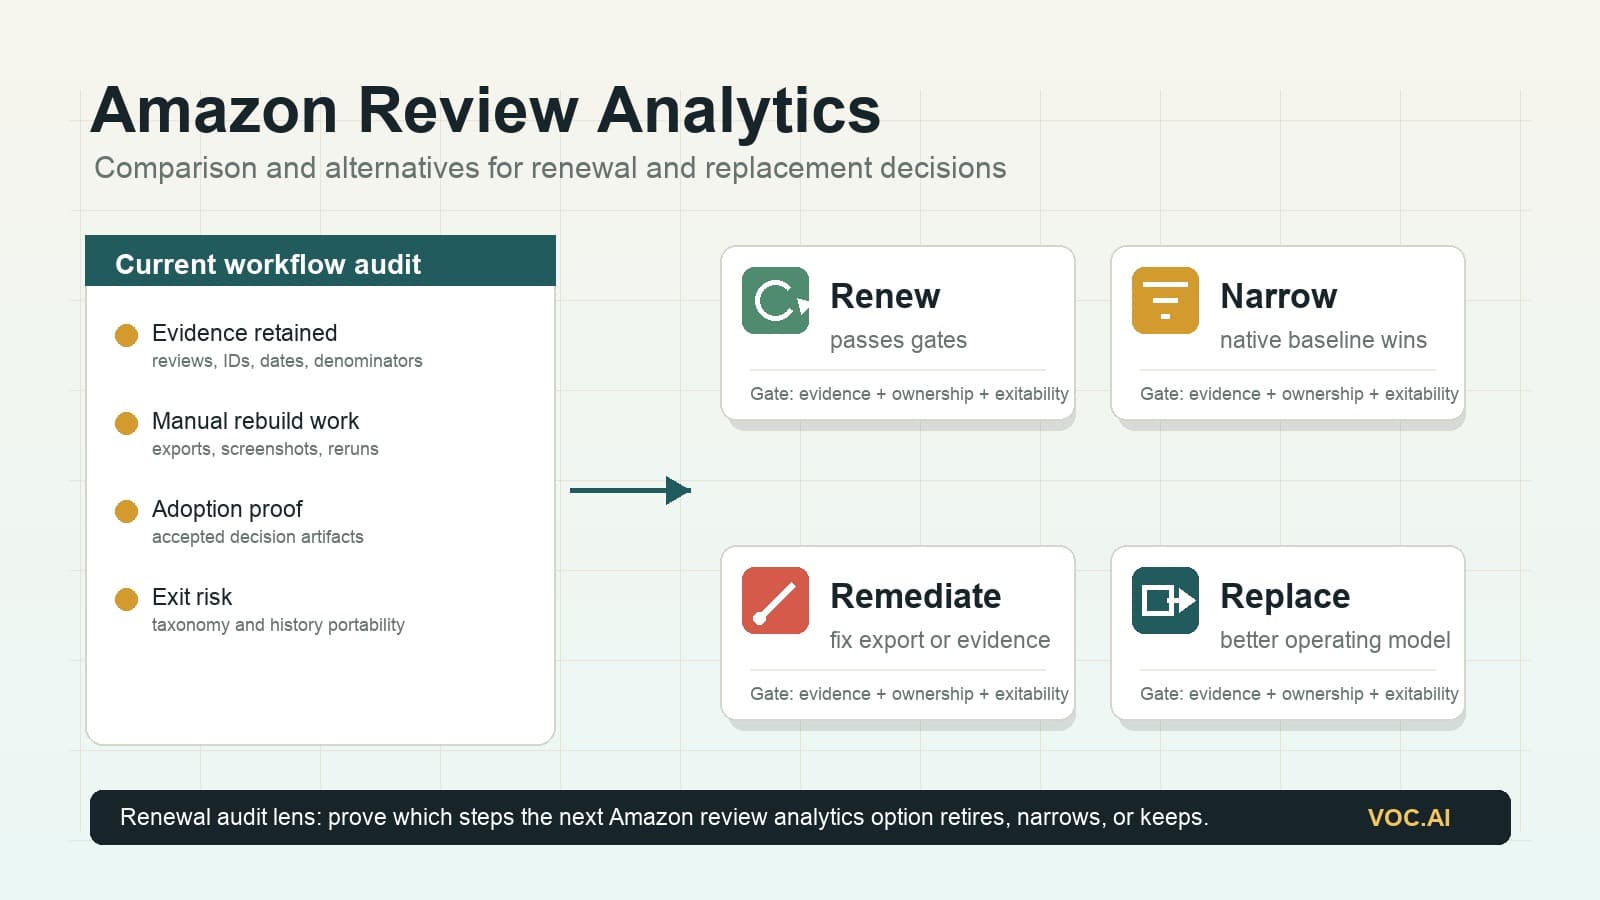
A atualização de 11 de agosto acrescenta uma camada de renovação e substituição: uma forma prática de decidir se deve manter o fluxo de trabalho atual, reduzi-lo à cobertura nativa da Amazon, adicionar uma camada especializada ou substituí-lo por um processo orientado por API. A análise de avaliações nativa da Amazon e das suítes de vendedores está cada vez mais conectada às próprias superfícies de feedback do cliente e aos contratos de API da Amazon, então a primeira pergunta não é tanto se uma ferramenta consegue mostrar tópicos, mas se ela consegue preservar o corpus, as evidências, o denominador, a lógica de comparação, a transferência e o trilho de migração que sua equipe precisa depois que o resumo nativo aparece.
O que comparar primeiro: interface, evidências ou modelo operacional?
A maioria dos compradores começa com capturas de tela da interface porque capturas de tela são fáceis de comparar. Essa é a camada inicial errada para a análise de avaliações da Amazon. Uma interface polida ainda pode ocultar o conjunto de avaliações, mesclar reclamações distintas ou fazer comparações com concorrentes usando janelas inconsistentes.
Use esta ordem em vez disso.
| Camada de compra | O que ela responde | O que inspecionar | Modo de falha se ignorada |
|---|---|---|---|
| Modelo operacional | Quem é responsável pelo acesso aos dados, taxonomia, QA e trabalho recorrente? | Ferramenta nativa, suíte, plataforma especializada, fluxo de trabalho assistido por IA ou pipeline de API | A equipe compra uma ferramenta que não se encaixa no ritmo ou no responsável |
| Camada de evidências | Cada descoberta importante pode ser rastreada até as avaliações de origem e às regras do denominador? | Manifesto do corpus, trechos de avaliações, notas de confiança, contraexemplos, janelas de datas e filtros | As partes interessadas questionam as conclusões e os analistas refazem o trabalho manualmente |
| Camada de decisão | A saída pode se tornar um artefato de ação real? | Brief de produto, brief de listagem, relatório de qualidade, tabela de lacunas da concorrência, alerta, ticket ou resposta de API | O painel é interessante, mas não muda o que a equipe faz |
| Camada de saída | A equipe pode sair sem perder taxonomia, evidências ou histórico? | Exportações, esquema, IDs, histórico de versões e simulação de migração | O fluxo de trabalho escolhido se torna caro de alterar, mesmo que a qualidade caia |
Essa ordem muda a forma como você compara as alternativas. Planilhas manuais podem superar uma ferramenta quando a decisão é restrita e o analista precisa ler todas as avaliações. Uma suíte ampla para vendedores pode superar uma especializada quando fluxos de trabalho de palavras-chave e listagens importam mais do que evidências profundas de feedback. Uma especializada pode superar ambas quando a inteligência de avaliações é uma entrada semanal para várias áreas. Um pipeline de API pode superar a categoria de interface quando o destino é um sistema interno.
Atualização do mercado de agosto de 2026: compare tópicos nativos separadamente da evidência de decisão
As comparações de análise de avaliações da Amazon costumavam separar claramente “ferramentas nativas” de “ferramentas de terceiros para vendedores”. Essa linha agora é menos clara. A API oficial Customer Feedback da Amazon expõe tópicos agregados de feedback de clientes para fluxos de trabalho ASIN elegíveis, e a documentação atual do Review Insights da Helium 10 diz que o recurso é alimentado pela Customer Feedback API da Amazon. Em outras palavras, um módulo de avaliações de uma suíte para vendedores pode agora estar mais próximo de uma camada de tópicos nativa da Amazon do que de um fluxo de trabalho totalmente independente de mineração de avaliações.
Isso é útil, mas altera a avaliação. Resumos de tópicos com tecnologia de API podem reduzir a fricção de configuração e melhorar a legitimidade da plataforma. Eles não respondem automaticamente se sua equipe consegue auditar cada afirmação, comparar concorrentes com o mesmo denominador, exportar as evidências ou conectar os achados das avaliações a uma decisão de produto, listagem, qualidade ou monitoramento.
Use essa separação antes de selecionar ferramentas.
| Camada | O que ela comprova | O que ela não comprova |
|---|---|---|
| Camada de tópicos nativa | A Amazon reconheceu tópicos positivos ou negativos, trechos de avaliações, impacto na classificação, tendências ou dados de tópicos retornados pela API para o contexto do ASIN elegível | Que o fluxo de trabalho oferece suporte à sua taxonomia personalizada, denominador concorrente multi-ASIN, evidências multicanal ou requisitos de exportação/auditoria |
| Fluxo de trabalho da suite de seller | A visualização de avaliações fica ao lado das ferramentas de keyword, listing, pesquisa de produto ou operações que sua equipe já pode usar | Que a análise de avaliações seja suficientemente profunda para ser um sistema recorrente de insights, e não apenas um módulo de apoio |
| Camada de análise especializada | O sistema é կառուցado em torno de síntese recorrente de evidências, rastreabilidade, comparação e transferência | Que ele substitua todas as funções da suite de seller, ou que deva vencer quando uma visualização nativa já responde a uma pergunta específica |
| Camada de API ou data warehouse | A organização pode incorporar tópicos de avaliações ou campos analisados em seus próprios sistemas | Que a responsabilidade de engenharia, QA, armazenamento de evidências e manutenção seja mais barata do que comprar um fluxo de trabalho mantido |
Para o trabalho de Amazon review analytics: comparison and alternatives, esta é a implicação prática: não trate “alimentado por dados da Amazon” como um fator eliminatório nem como uma resposta completa. Trate isso como uma camada de origem. O vencedor ainda precisa passar pelo pacote de evidências, teste de aceitação, modelo de custo e exercício de capacidade de saída abaixo.
Pacote mínimo viável de evidências
Antes de fazer demos, defina o pacote de evidências que toda alternativa deve produzir. Esse pacote deve ser pequeno o suficiente para ser criado em uma única sessão de trabalho e completo o bastante para que um responsável de produto, marketing, qualidade ou operações possa contestá-lo.
| Campo do pacote | Padrão exigido |
|---|---|
| Manifesto do corpus | ASINs, marketplace, data de extração, contagem de avaliações, janela de datas, filtros de estrelas, filtros de idioma, tratamento de variações e exclusões |
| Tabela de temas | Temas classificados com rótulos em linguagem simples, mecanismo, sentimento, produto ou concorrente afetado, e contagem ou participação com denominador |
| Apêndice de evidências | Trechos exatos de avaliações para as principais alegações, pelo menos um contraexemplo por tema principal, classificação, data, ASIN, marketplace e ID da fonte quando disponível |
| Visualização de mudança recente | Um período recente comparado com um período de base usando a mesma taxonomia e um denominador visível |
| Artefato de decisão | Uma saída concreta: briefing de copy do listing, memorando de problema do produto, tabela de lacunas do concorrente, investigação de qualidade, alerta de monitoramento ou resposta de API |
| Registro de incerteza | Avaliações ambíguas, evidências fracas, padrões suspeitos, discordâncias de taxonomia e alegações que precisam de validação com suporte, devoluções ou dados de vendas |
| Nota de reprodução | As configurações, prompt, visualização salva, solicitação ou versão do fluxo de trabalho que outro analista precisa para repetir a mesma análise |
Se uma alternativa não conseguir produzir esse pacote, ela ainda pode ser útil para exploração, mas não deve ser tratada como um sistema de análise de avaliações pronto para produção.
Pacote de aquisição de agosto de 2026: o que coletar antes da reunião de shortlist
A maioria das comparações de analytics de avaliações da Amazon termina com uma tabela de recursos. Isso não é suficiente para uma investigação comercial. Um comprador precisa de um pacote que permita que stakeholders de produto, ecommerce, pesquisa, operações, engenharia e segurança inspecionem as mesmas evidências antes que um finalista avance.
Monte o pacote antes da reunião de shortlist, não depois que o procurement já escolheu emocionalmente um vencedor.
| Seção do pacote | O que incluir | Por que isso muda a comparação |
|---|---|---|
| Pergunta de decisão | Uma decisão que o fluxo de trabalho deve apoiar, como um memorando de problema de produto, um resumo de linguagem do listing, um relatório de lacuna de concorrentes ou um alerta de monitoramento | Impede que os fornecedores otimizem a demonstração em torno de dashboards genéricos |
| Escopo do produto | ASINs focais, ASINs de concorrentes, marketplace, idioma, janela de datas, tratamento de variações filhas e meta de contagem de avaliações | Torna as lacunas de cobertura visíveis antes do início da prova |
| Regra de evidência | Texto exato da avaliação, ID da origem quando disponível, ASIN, classificação, data, marketplace, filtro, denominador e expectativas de contraexemplos | Separa analytics de resumos sem rastreabilidade |
| Baseline nativo | O que os insights nativos de avaliações da Amazon ou os dados de tópico da Customer Feedback API já fornecem para o mesmo escopo de produto | Impede a equipe de pagar por um fluxo de trabalho que apenas reempacota uma baseline já disponível |
| Justificativa da shortlist | Por que cada finalista permanece na comparação: nativo, suíte do vendedor, plataforma especializada, fluxo de trabalho assistido por IA ou pipeline de API | Mantém a shortlist equilibrada entre modelos operacionais, em vez de cinco dashboards parecidos |
| Artefatos da demonstração | Capturas de tela são permitidas, mas cada finalista também deve fornecer um export, resumo, tabela, alerta, ticket ou amostra de API que possa ser revisada fora da chamada | Testa se o fluxo de trabalho sobrevive fora da interface |
| Anotações dos stakeholders | Objeções de produto, listing, qualidade, suporte, pesquisa, engenharia e segurança, com responsável e status de follow-up | Torna o processo de compra multifuncional sem transformá-lo em um consenso vago |
| Resultado da etapa de aprovação | Aprovado, aprovado com ressalvas ou reprovado para cobertura, rastreabilidade, lógica de comparação, lógica de tendência, saída do fluxo de trabalho, governança, custo e capacidade de saída | Impede que uma pontuação total alta esconda uma fraqueza desqualificante |
O pacote deve ser curto o suficiente para ser revisado em uma única reunião. Se levar um dia para explicar, a comparação ainda está abstrata demais.
Use uma pauta de revisão com stakeholders
Conduza a reunião da shortlist com uma pauta fixa:
- Confirme a questão de decisão. Se as partes interessadas discordarem sobre a decisão, pause a comparação de ferramentas.
- Inspecione a linha de base nativa. Identifique quais perguntas os tópicos nativos da Amazon, trechos, tendências ou dados de tópicos retornados pela API já respondem.
- Revise o pacote de evidências. Abra pelo menos três avaliações de origem por trás das principais alegações e um contraexemplo.
- Questione a comparação. Pergunte se os produtos focal e concorrentes usam o mesmo denominador, janela e taxonomia.
- Revise o artefato de saída. Decida se um responsável que não seja analista poderia agir com base nele sem refazer o trabalho.
- Verifique a propriedade operacional. Nomeie quem mantém a taxonomia, QA, exportações, alertas, integrações, permissões e reexecuções.
- Defina os gates de prova. Decida qual falha removeria o finalista durante a prova de 14 dias.
Esta agenda é deliberadamente prática. Ela move a conversa de "qual ferramenta é melhor?" para "qual modelo operacional pode produzir um artefato de decisão defensável para o nosso conjunto de produtos?"
Adicione perguntas específicas para as partes interessadas
Diferentes partes interessadas devem questionar diferentes partes do fluxo de trabalho de analytics de avaliações da Amazon.
| Parte interessada | Pergunta a fazer | Evidência que deve satisfazê-la |
|---|---|---|
| Gerente de produto | Qual tema altera o roadmap, e quais avaliações comprovam o mecanismo? | Tabela de temas com evidências exatas das avaliações, contraexemplos, confiança e recomendação pronta para o responsável |
| Responsável de ecommerce ou de listagem | Quais frases dos compradores devem afetar título, bullets, imagens ou conteúdo A+? | Clusters de frases literais com avaliação, data, ASIN, marketplace e notas de decisão |
| Responsável de qualidade ou operações | O problema está ligado ao design do produto, embalagem, fulfillment, expectativas ou uso? | Mecanismos de reclamação segmentados, visão de mudanças recentes, contexto de variante e perguntas abertas de validação |
| Líder de pesquisa ou insights | A taxonomia preserva o significado entre produtos e ao longo do tempo? | Codebook, amostra de referência codificada por humanos, registro de divergências e resultado de repetibilidade |
| Responsável de engenharia ou dados | Os dados podem ser movidos para sistemas internos sem perder evidências? | Esquema de exportação, amostra de API, IDs, timestamps, versionamento, limites e comportamento de erro |
| Revisor de segurança ou conformidade | O acesso, retenção, permissões, histórico de auditoria e práticas de tratamento de avaliações são aceitáveis? | Documentação do fornecedor, controles de função, comportamento de exclusão, notas de fluxo de dados e exceções de política |
| Comprador de finanças ou operações | O fluxo de trabalho reduz trabalho repetido o suficiente para justificar o custo? | Modelo de custo operacional anual, estimativa de configuração, estimativa de QA e custo por artefato de decisão aceito |
Se um finalista não conseguir satisfazer a pergunta de uma parte interessada, rotule a lacuna com precisão. Um campo de API ausente, escopo de marketplace pouco claro ou apêndice de evidências não exportável é mais fácil de resolver do que uma preocupação vaga de que a ferramenta parece incompleta.
Auditoria de renovação de agosto de 2026: decida se deve manter, restringir, adicionar ou substituir
Muitas equipes não chegam à análise de avaliações da Amazon: comparação e alternativas com uma folha em branco. Elas já têm uma planilha, um módulo da suíte do vendedor, um fluxo de trabalho nativo da Amazon, um resumidor de avaliações ou um pipeline interno pela metade. A questão mais difícil não é "Qual ferramenta devemos comprar?" É "Temos evidências suficientes para renovar o fluxo de trabalho atual, ou devemos substituir parte dele?"
Realize uma auditoria de renovação 30 a 45 dias antes da renovação do contrato, do planejamento anual ou de uma grande revisão de linha de produtos. A auditoria deve usar o mesmo padrão de evidência de uma nova compra, mas também deve inspecionar a continuidade histórica: quais taxonomias, links entre avaliações de origem, exportações, painéis, alertas e decisões sobreviveriam se o fluxo de trabalho mudasse.
| Achado da renovação | Decisão para a qual ele aponta | O que inspecionar antes de agir |
|---|---|---|
| Os tópicos nativos da Amazon respondem à principal questão do produto e as partes interessadas raramente usam resultados mais profundos | Reduza o fluxo de trabalho em torno de insights de avaliações nativos da Amazon ou tópicos com suporte de API | Elegibilidade, cobertura do marketplace, atualidade dos tópicos, necessidades de exportação e se a visualização nativa ainda preserva evidências de decisão suficientes |
| A análise de avaliações da suíte do vendedor é útil apenas quando combinada com fluxos de trabalho de palavra-chave, listagem ou pesquisa de produtos | Mantenha-a como um módulo de apoio, não como o sistema de registro | Se as evidências de avaliação ainda podem ser exportadas, citadas e comparadas fora da suíte |
| Os analistas recriam manualmente apêndices de evidências após cada revisão do painel | Adicione uma camada especializada de inteligência de avaliações ou redesenhe o fluxo de trabalho de evidências | Rastreabilidade de temas, IDs no nível da avaliação, esquema de exportação, visualizações salvas e tempo de transição para o responsável |
| As equipes de produto, qualidade e listagem usam taxonomias diferentes para as mesmas avaliações | Consolide a taxonomia e a QA antes de expandir as ferramentas | Propriedade do codebook, registros de divergências, versionamento de rótulos e mapeamento de rótulos antigos para novos rótulos |
| As equipes internas precisam de dados de avaliações dentro de BI, tickets, alertas ou modelos proprietários | Compare o acesso à API de uma solução especializada com um pipeline personalizado | Campos da API, limites de taxa, histórico de solicitações, armazenamento de evidências, versionamento de esquema e responsabilidade de engenharia |
| O custo está aumentando, mas os artefatos de decisão aceitos estão estáveis | Renegocie, reduza o escopo ou substitua | Custo de licença/API, horas de analista, tempo de QA, tempo de engenharia, ASINs monitorados e entregáveis aceitos por mês |
A auditoria de renovação evita uma falha comum: renovar uma ferramenta porque ela ainda produz painéis atraentes enquanto o fluxo de decisão real mudou para outro lugar. Se a evidência não é mais usada, o fluxo de trabalho não está apenas com baixa adoção. Ele já não é mais o modelo operacional correto.
Use um livro-razão de evidências do estado atual
Antes de comparar opções de substituição, inventarie o que o fluxo de trabalho atual já faz. Use uma linha por decisão recorrente, não uma linha por recurso.
| Campo do registro | O que registrar |
|---|---|
| Decisão | Revisão do produto, reescrita do listing, lacuna em relação ao concorrente, investigação de qualidade, alerta de monitoramento ou resumo executivo |
| Entrada atual | Visualização nativa de tópicos, exportação de avaliações, suíte do seller, painel especializado, resposta de API, planilha ou análise assistida por IA |
| Evidência retida | Trechos de avaliações, IDs de origem, datas, ASINs, marketplace, denominador, contraexemplos e filtros salvos |
| Saída retida | Resumo, CSV, ticket, painel, alerta, payload de API, codebook ou apresentação |
| Trabalho de reconstrução | Limpeza manual, montagem de capturas de tela, novas execuções de prompt, reconciliação de planilhas, explicação para stakeholders ou correção de engenharia |
| Prova de adoção | Quem usou a saída, qual decisão mudou e se o artefato de decisão foi aceito sem retrabalho |
| Risco de substituição | Dados que não podem ser exportados, histórico de taxonomia que pode ser perdido, integrações que exigem retrabalho ou revisão jurídica/de segurança necessária |
Este registro oferece aos revisores de renovação uma base de comparação melhor do que o custo do contrato sozinho. Um fluxo de trabalho barato que exige dois dias de reconstrução manual para cada grande decisão pode custar mais do que um sistema de preço mais alto que preserva evidências, propriedade e repetibilidade.
Avalie o fluxo de trabalho atual pelos mesmos critérios dos novos finalistas
Não dê um passe livre ao sistema atual. Avalie-o pelos mesmos critérios mínimos que você aplicaria a uma nova alternativa de analytics de avaliações da Amazon:
- A equipe consegue ver exatamente quais avaliações, ASINs, marketplaces, datas, filtros e variantes foram analisados?
- Cada tema importante pode ser rastreado até a linguagem original do cliente e pelo menos um contraexemplo?
- A mesma taxonomia consegue comparar um produto focal, um concorrente e um período recente sem mudanças ocultas no denominador?
- Um responsável que não seja analista consegue usar a saída sem reconstruir o trabalho?
- A evidência, a taxonomia e o histórico de decisões podem ser exportados antes da renovação?
- Uma execução repetida consegue explicar mudanças causadas por novas avaliações, edições de configuração ou mudanças de modelo?
- O fluxo de trabalho consegue comprovar valor por meio de artefatos de produto, listing, qualidade ou monitoramento aceitos?
Se o sistema atual falhar em um critério inegociável, a decisão de renovação deve se tornar uma substituição controlada ou um plano de correção. Se ele passar nos critérios, mas trouxer módulos extras não utilizados, a melhor medida pode ser reduzir o escopo em vez de trocar de fornecedor.
Defina antecipadamente os gatilhos de substituição
A substituição não deve depender de quem estiver mais frustrado na reunião de renovação. Defina os gatilhos antes da auditoria:
| Gatilho | Por que isso importa | Exemplo de limite |
|---|---|---|
| Perda de evidências | As partes interessadas não conseguem confiar na descoberta nem revisá-la | Mais de 10% das reivindicações de alta prioridade carecem de evidência da revisão da fonte ou de contexto do denominador |
| Reconstrução do fluxo de trabalho | A ferramenta produz resultados que exigem reconstrução manual repetida | Mais de um dia útil por mês gasto na montagem de apêndices de evidências a partir de capturas de tela, exportações ou novas execuções |
| Descompasso de cobertura | O fluxo de trabalho atual já não corresponde ao local onde o negócio compete | Marketplaces, concorrentes, idiomas, variantes ou linhas de produtos necessários estão ausentes da análise recorrente |
| Falha de adoção | A ferramenta é observada, mas não é usada para decisões | Menos de dois artefatos de decisão aceitos por trimestre para um fluxo de trabalho de revisão recorrente |
| Lacuna de governança | O acesso, a retenção, as exportações, o tratamento via API ou o histórico de auditoria não atendem à política | Os responsáveis por segurança, jurídico ou dados não conseguem aprovar o fluxo de trabalho em produção sem exceções |
| Risco de saída | Mudar faria perder a taxonomia, as evidências ou a continuidade histórica | Não há exportação utilizável de evidências, codebook, histórico de decisões ou mapeamentos de integração antes da renovação |
Esses limites são exemplos, não padrões universais. O ponto é mover a conversa de renovação da preferência para o trabalho observado.
Decida entre quatro resultados de renovação
No final da auditoria, escolha um de quatro resultados:
- Renovar como está. Use isso apenas quando o fluxo de trabalho passar pelas barreiras de evidência, resultado, adoção, governança, custo e capacidade de saída.
- Renovar com escopo mais restrito. Mantenha a ferramenta para os trabalhos que ela realmente oferece suporte e remova expectativas infladas do modelo operacional.
- Renovar com correções. Mantenha o fluxo de trabalho somente se lacunas específicas forem corrigidas até uma data definida, como esquema de exportação, apêndice de evidências, controles de taxonomia ou transferência para stakeholders.
- Substituir ou reconstruir. Inicie uma prova de substituição quando o sistema atual não puder dar suporte ao fluxo de trabalho de decisão atual, não puder exportar a trilha de evidências ou custar mais do que seus artefatos de decisão aceitos justificam.
É aqui que as comparações de Amazon review analytics se tornam mais honestas. Uma ferramenta nativa pode ser a resposta certa depois de um piloto especializado. Um conjunto de ferramentas para sellers pode permanecer na pilha como um módulo de suporte. Uma plataforma especializada pode se tornar o sistema de registro. Um pipeline de API pode vencer quando as evidências precisam fluir para sistemas proprietários. A auditoria de renovação força a escolha a seguir o trabalho.
Amazon review analytics: comparação e alternativas por modelo operacional
Para o trabalho de Amazon review analytics: comparação e alternativas, o modelo operacional importa porque cada opção transfere a responsabilidade para uma equipe diferente.
| Abordagem | Ideal para | Principal ponto forte | Principal limitação | Escolha quando |
|---|---|---|---|---|
| Leitura manual e planilhas | Análise pontual de um pequeno conjunto de avaliações | Máximo controle sobre o que é codificado | Lento, difícil de repetir, fácil de haver divergências entre analistas | Você tem uma pergunta estreita e pode inspecionar as avaliações de origem por conta própria |
| Assistente de IA de uso geral | Exploração rápida e criação inicial de taxonomia | Prompting flexível e síntese rápida | Coleta de dados, rastreabilidade e repetibilidade dependem do seu processo | Você já tem um conjunto de avaliações obtido legalmente e precisa de uma análise inicial |
| Insights de avaliações nativos da Amazon | Perguntas sobre produto ou nicho dentro do Seller Central | Contexto nativo e pouca fricção de configuração | Acesso, escopo, exportações e flexibilidade do fluxo de trabalho podem não atender a todas as equipes | Sua decisão vive principalmente dentro da Amazon e a cobertura nativa é suficiente |
| Suíte ampla para vendedores da Amazon | Equipes que também precisam de ferramentas de palavras-chave, listagens, publicidade ou pesquisa de produtos | Múltiplos fluxos de trabalho de vendedor em uma única assinatura | A análise de avaliações pode ser apenas um módulo, em vez de o centro do sistema | A consolidação importa mais do que o design profundo do fluxo de trabalho de análise de avaliações |
| Plataforma especializada | Inteligência de avaliações repetível entre produtos e concorrentes | Análise de temas mais profunda, recuperação de evidências, comparação e monitoramento | Adiciona um sistema dedicado à pilha | A linguagem das avaliações orienta decisões recorrentes de produto, listagem, suporte ou pesquisa |
| Pipeline de API personalizado | Fluxos de trabalho de alto volume ou incorporados | Controle sobre modelos de dados, automação e integrações internas | Esforço de engenharia, governança, QA e manutenção | A inteligência de avaliações precisa alimentar painéis proprietários, modelos ou processos operacionais |
Uma plataforma especializada e um pipeline de API personalizado costumam ser avaliados juntos, mas resolvem problemas diferentes de propriedade. Um compra um fluxo de trabalho mantido; o outro constrói um.
Comece pela decisão, não pelo dashboard
Antes de comparar ferramentas, escreva uma frase que defina a decisão.
Por exemplo:
- Quais reclamações recorrentes devem alterar nossa próxima revisão do produto?
- Quais frases dos compradores devem influenciar o texto da nossa listagem?
- Uma queda súbita na avaliação está ligada à embalagem, qualidade, expectativas ou fulfillment?
- Qual fraqueza do concorrente aparece com frequência suficiente para ser investigada?
- Quais temas de avaliação estão crescendo após uma mudança de fornecedor ou embalagem?
Isso importa porque “analisar avaliações” não é um requisito utilizável. Decisões diferentes precisam de coberturas diferentes, janelas de tempo diferentes, conjuntos de comparação diferentes e padrões de evidência diferentes.
Um projeto de copy de listagem pode precisar de frases exatas e cenários de uso. Uma investigação de qualidade precisa de datas, variantes, lotes e mudanças de tendência. Um projeto de sourcing precisa de cobertura de concorrentes e da categoria. Um fluxo de monitoramento semanal precisa de alertas, responsáveis e datas de rechecagem.
Se a ferramenta não consegue preservar o vínculo entre um tema e as avaliações por trás dele, a saída é uma sugestão — não uma evidência.
Os 10 critérios que separam análises úteis de resumos polidos
Use estes critérios para comparar alternativas de análise de avaliações da Amazon.
1. Cobertura das avaliações
Pergunte o que a análise realmente inclui:
- Um ASIN ou um portfólio?
- Seus produtos, concorrentes ou conjuntos no nível de categoria?
- Quais marketplaces e idiomas?
- Qual intervalo de datas?
- Anúncios pai, variantes filhas ou ambos?
- Todas as avaliações disponíveis ou uma seleção limitada?
A cobertura muda a conclusão. Um feed nativo ou alimentado por API de tópicos pode ser uma base sólida quando corresponde ao seu ASIN, marketplace, idioma e restrições de elegibilidade. Ainda assim, é uma base de evidências diferente de uma análise personalizada de corpus completo ou de múltiplos ASINs, se o fluxo de trabalho não puder mostrar o mesmo denominador, filtros, janela de datas e exclusões que sua decisão exige.
A pergunta certa não é “Ele analisa avaliações?” É “Quais avaliações determinam a პასუხa?”
2. Qualidade dos temas
O sentimento básico divide o feedback em positivo, neutro e negativo. Uma análise útil também deve identificar sobre o que é o sentimento.
Procure temas como:
- Durabilidade
- Ajuste ou tamanho
- Fricção na configuração
- Danos na embalagem
- Acessórios ausentes
- Duração da bateria
- Toque do material
- Descompasso de expectativa
- Caso de uso ou tipo de comprador
Os rótulos dos temas devem ser específicos o suficiente para encaminhamento. “Feedback negativo do produto” não tem dono. “A tampa racha após ciclos repetidos na lava-louças” pode ir para as equipes de produto e qualidade.
3. Evidência literal
Um sistema forte permite ir de um gráfico aos trechos relevantes da avaliação. Isso ajuda as equipes a:
- Verificar se o rótulo corresponde à linguagem
- Observar o contexto que um resumo removeu
- Identificar as frases que os clientes usam naturalmente
- Encontrar exceções e contraexemplos
- Evitar apresentar texto gerado como citação de cliente
A recuperação de evidências é uma das diferenças mais claras entre análise de avaliações e sumarização genérica de texto.
4. Lógica de comparação
A análise de avaliações de concorrentes deve comparar coisas equivalentes. Verifique se você consegue controlar:
- Conjunto de produtos
- Janela de tempo
- Faixa de estrelas
- Variação ou modelo
- Marketplace
- Definição do tema
- Diferenças no volume de avaliações
Um concorrente pode ter mais reclamações simplesmente porque tem mais avaliações. Um produto mais novo pode parecer melhor porque menos problemas de durabilidade de longo prazo tiveram tempo de aparecer. Contagens sem denominadores podem induzir ao erro.
5. Tendências ao longo do tempo
Uma contagem de temas de todo o período pode esconder o evento que você precisa ver. Procure a capacidade de comparar períodos e detectar mudanças após:
- Uma mudança de fornecedor
- Uma revisão da embalagem
- Uma reescrita do anúncio
- Uma mudança de preço
- Um pico sazonal de demanda
- Uma atualização do produto
A Amazon descreve o Customer Review Insights como algo que mostra tópicos positivos e negativos, o impacto dos tópicos nas classificações por estrelas, trechos de avaliações e tendências de tópicos de seis meses dentro do Product Opportunity Explorer. Essa visualização nativa pode ser suficiente para algumas questões de produto e de nicho.
6. Filtros e segmentação
Filtros úteis dependem da decisão, mas os comuns incluem classificação, data, produto, concorrente, variação, marketplace, idioma e tema.
Não trate um painel rico em filtros como automaticamente rigoroso. Os filtros só são úteis se a cobertura subjacente estiver clara e se as evidências resultantes puderem ser inspecionadas.
7. Saídas do fluxo de trabalho
A saída deve se adequar à próxima ação. Exemplos incluem:
- Uma entrada para requisitos de produto
- Um briefing de linguagem de listagem
- Um relatório de problema de embalagem
- Uma atualização de FAQ de suporte
- Uma tabela de lacunas de concorrentes
- Um alerta de monitoramento
- Um memorando semanal de decisão
Se o fluxo de trabalho termina com “painel interessante”, a equipe ainda precisa reconstruir a análise antes de agir.
8. Repetibilidade
Outra pessoa consegue executar novamente a mesma análise na próxima semana e entender o que mudou?
A repetibilidade exige mais do que prompts salvos. Pode incluir uma taxonomia estável, conjunto de produtos nomeado, janela de datas, filtros, versão da análise, links de evidência e resultados exportáveis.
É aqui que a análise manual e os assistentes gerais de IA frequentemente precisam de um desenho de processo adicional. Eles podem ser poderosos, mas a equipe é responsável pelo método.
9. Integração e exportação
Considere para onde as descobertas precisam ir:
- CSV ou planilha
- Sistema de gestão de produto
- Painel de business intelligence
- Data warehouse
- Plataforma de suporte
- Repositório interno de pesquisa
- Fluxo de trabalho automatizado de alertas
A Customer Feedback API da Amazon pode retornar tópicos de avaliações positivas e negativas para um ASIN para aplicações autorizadas. A VOC AI também descreve uma Review Analysis API para campos originais de avaliações e dados de conclusão analisados por IA. Uma API se torna relevante quando o destino importa tanto quanto a interface de análise.
10. Governança e conformidade
A análise de avaliações deve ajudá-lo a aprender com o feedback do cliente, não a manipulá-lo.
A FTC Consumer Reviews and Testimonials Rule aborda práticas como avaliações falsas, incentivos condicionados ao sentimento, avaliações internas não divulgadas e supressão de avaliações. A regra entrou em vigor em 21 de outubro de 2024.
Sua avaliação deve cobrir acesso aos dados, retenção, permissões de usuário, exportações, auditabilidade e como os resumos gerados são separados da linguagem original do cliente. Também deve confirmar que a coleta de avaliações e o uso posterior seguem os termos aplicáveis da plataforma e a política interna.
Execute um benchmark de reprodutibilidade antes de comparar listas de recursos
As listas de recursos dizem o que um produto afirma fazer. Um benchmark de reprodutibilidade testa se a abordagem pode produzir uma resposta estável e auditável quando a entrada, a pergunta e as regras permanecem as mesmas.
Isso importa porque a análise de avaliações da Amazon frequentemente combina várias etapas variáveis: seleção do corpus, deduplicação, tratamento de idioma, atribuição de temas, classificação de sentimento, escolha do denominador, lógica de comparação e explicação gerada. Dois painéis atraentes podem chegar a conclusões diferentes a partir das mesmas avaliações. A pergunta útil não é se eles discordam. É se você consegue localizar e explicar a discordância.
Monte um pacote de benchmark único antes de demonstrações ou testes de fornecedores. Use o mesmo pacote para análise manual, ferramentas nativas, suítes de seller, plataformas especializadas e fluxos de trabalho orientados por API.
Monte um pacote de teste fixo
Escolha um conjunto de produtos focal que inclua avaliações comuns e casos difíceis:
- Um ASIN focal com histórico de avaliações suficiente para mostrar temas recorrentes
- Um concorrente próximo com um caso de uso semelhante
- Um produto com variantes, kits ou diferenças significativas de configuração
- Um marketplace e uma janela de datas fixos
- Avaliações com sentimento misto, sarcasmo, elogios condicionais e múltiplos problemas
- Avaliações que mencionem embalagem, fulfillment, expectativas e desempenho do produto no mesmo texto
- Pelo menos cinco avaliações que um analista humano considere ambíguas
Registre os ASINs, o marketplace, a data de extração, a contagem de avaliações, a janela de datas, os filtros e quaisquer exclusões. Se um fluxo de trabalho não puder revelar o corpus analisado ou seu denominador, marque isso como uma limitação de medição antes de revisar sua saída.
Para opções orientadas por API, preserve o esquema da solicitação e da resposta junto com o resultado. A Amazon mantém um modelo público da Customer Feedback API, que fornece um exemplo útil dos contratos versionados que compradores técnicos devem esperar inspecionar.
Faça as mesmas cinco perguntas a todas as opções
Não deixe que cada demonstração escolha a pergunta que faz sua interface parecer mais forte. Exija que todas as finalistas respondam ao mesmo conjunto:
- Quais são os três mecanismos recorrentes de reclamação mais importantes para o ASIN focal?
- Qual reclamação mudou mais no período recente em comparação com o período de base?
- Qual tema separa o ASIN focal do concorrente com mais clareza?
- Qual descoberta é mais incerta e que evidência reduziria essa incerteza?
- Qual única ação de produto, listagem ou monitoramento o proprietário deve tomar em seguida?
As perguntas testam deliberadamente diferentes capacidades. A primeira testa cobertura e taxonomia. A segunda testa denominadores e janelas de tempo. A terceira testa a lógica de comparação. A quarta testa confiança e contraevidências. A quinta testa se a saída pode cruzar a fronteira da análise para um fluxo de trabalho de decisão.
Crie um conjunto de referência codificado por humanos
Selecione de 30 a 50 avaliações do pacote de teste e peça que duas pessoas as codifiquem independentemente. Use um esquema compacto:
| Campo | Regra de exemplo |
|---|---|
| Tema principal | O principal resultado para o cliente ou mecanismo do problema |
| Tema secundário | Um problema adicional distinto, não um sinônimo do tema principal |
| Sentimento | Positivo, negativo, misto ou अस्प? ... |
| Mecanismo | O que causou o resultado elogiado ou criticado |
| Trecho de evidência | As palavras exatas que sustentam o código |
| Confiança | Alta, média ou baixa com uma breve razão |
| Contexto | Variante, cenário de uso, embalagem, fulfillment ou expectativa, quando disponível |
Resolva os desacordos e mantenha tanto os códigos originais quanto o resultado adjudicado. Isto não é uma verdade fundamental perfeita. É uma referência transparente que expõe como cada abordagem lida com casos extremos conhecidos.
Se a sua equipe precisar de um framework de aquisição mais amplo, use este benchmark com um scorecard de ferramenta de análise de avaliações de clientes em vez de substituir o julgamento por um único número de precisão.
Pontue concordância, estabilidade e rastreabilidade separadamente
Uma única pontuação de “precisão” esconde modos de falha importantes. Pontue pelo menos estas quatro dimensões de 0 a 2:
| Dimensão do benchmark | 0 | 1 | 2 |
|---|---|---|---|
| Concordância temática | Temas importantes codificados por humanos são perdidos ou distorcidos de forma material | Os principais temas aparecem, mas os limites ou mecanismos são inconsistentes | Os principais temas e mecanismos se alinham bem o suficiente para apoiar a decisão |
| Estabilidade entre execuções | Repetir o mesmo teste produz prioridades materialmente diferentes sem explicação | As prioridades são semelhantes, mas rótulos, contagens ou evidências de suporte mudam | Execuções repetidas preservam a conclusão ou explicam claramente a mudança impulsionada pela versão |
| Rastreabilidade da evidência | As descobertas não podem ser rastreadas até avaliações individuais ou referências de fonte aprovadas | Alguns exemplos ficam visíveis, mas o denominador ou o conjunto completo de evidências não está claro | Cada descoberta importante tem evidência recuperável, contexto do corpus e base de cálculo |
| Diagnóstico de divergências | A equipe não consegue localizar por que o resultado difere da referência | As diferenças podem ser encontradas com reconstrução manual | O fluxo de trabalho expõe filtros, taxonomia, confiança, exceções e evidências afetadas |
Execute o mesmo benchmark duas vezes sem alterar o corpus ou as instruções. Se a saída mudar, pergunte se a diferença veio de uma versão do modelo, mudança de taxonomia, atualização do corpus, geração aleatória, filtro oculto ou regra de cálculo. Uma resposta errada estável não é boa, mas uma resposta instável que não pode ser explicada é difícil de governar.
Mantenha um registro de divergências
Para cada incompatibilidade material, registre:
- A afirmação ou tema ranqueado que mudou
- As avaliações ou registros afetados
- Se a diferença é um problema de cobertura, codificação, sentimento, denominador, recência ou explicação
- Se um revisor humano consegue corrigi-la
- Se a correção persiste na próxima execução
- Se a incompatibilidade altera a ação recomendada
Esse registro é mais útil do que coletar capturas de tela isoladas. Ele mostra se o fluxo de trabalho melhora por meio de edições de taxonomia, exclusões, alterações de prompt, correções de dados ou configuração do produto — e se essas melhorias sobrevivem além da sessão de um analista.
Defina uma condição de aprovação vinculada à decisão
Não exija que cada rótulo de tema corresponda palavra por palavra. Exija que a abordagem preserve o significado relevante para a decisão.
Por exemplo, “tampa racha durante o transporte” e “dano na tampa relacionado à embalagem” podem ser variantes aceitáveis se ambos apontarem para a mesma evidência e responsável. “Baixa qualidade” não é um substituto aceitável quando agrupa dano na tampa, falha da bateria e reclamações de tamanho em uma única categoria vaga.
Um finalista é aprovado quando consegue:
- Reproduzir os principais temas relevantes para a decisão
- Explicar as diferenças importantes em relação ao conjunto de referência
- Preservar as evidências de origem e os denominadores
- Produzir uma ordem de prioridade estável em execuções repetidas
- Transformar o resultado no entregável exigido sem trabalho oculto de reconstrução
Este benchmark não elimina a necessidade de um piloto em produção. Ele torna o piloto mais diagnóstico. Você entra no proof de 14 dias sabendo quais casos extremos, controles e lacunas de evidência exigem atenção.
Alternativa 1: leitura manual de avaliações e planilhas
A análise manual não está obsoleta. Muitas vezes, é o melhor ponto de partida quando a decisão é restrita e o conjunto de avaliações é administrável.
Quando funciona
- Você está avaliando um pequeno número de produtos
- Você precisa aprender o vocabulário da categoria antes de automatizar
- A decisão tem alto impacto e exige leitura atenta
- Você quer criar uma primeira taxonomia
- A análise é ocasional, e não recorrente
Onde falha
- A codificação muda conforme o analista aprende
- Tópicos duplicados e rótulos inconsistentes se acumulam
- A rastreabilidade das avaliações se torna tediosa
- Comparar períodos ou concorrentes exige limpeza repetida
- O workbook se torna difícil de reutilizar por outras equipes
Uma configuração manual prática usa uma linha por avaliação, campos de origem imutáveis, campos codificados pelo analista separados e um codebook que define cada tema. Mantenha as citações dos clientes separadas dos resumos.
Alternativa 2: um assistente de IA de uso geral
Um assistente de IA geral pode classificar, resumir e explorar rapidamente o texto das avaliações que você fornecer. É uma alternativa útil quando sua equipe já controla o conjunto de dados e está disposta a assumir o método.
Quando funciona
- Você precisa de uma taxonomia inicial rápida
- A análise é exploratória
- Um humano irá inspecionar as evidências
- Você consegue gerenciar fragmentação, prompts e saídas
- Você não precisa de um sistema de monitoramento sempre ativo
Onde falha
- Os limites de entrada podem fragmentar a análise
- O modelo pode agrupar mecanismos distintos em temas amplos
- Os resultados podem mudar com prompts ou versões do modelo
- Citações para linhas de origem exigem implementação deliberada
- A coleta de dados e o acesso à plataforma continuam sendo problemas separados
Use campos de saída estruturados como theme, mechanism, sentiment, evidence_id, product, date e confidence. Em seguida, audite uma amostra das classificações antes de usar os resultados para uma decisão de produto ou marketing.
Alternativa 3: insights de avaliações nativos da Amazon
O Customer Review Insights da Amazon fica dentro do Product Opportunity Explorer no Seller Central. A Amazon diz que ele agrupa temas positivos e negativos comuns, mostra trechos, indica como os temas afetam as avaliações por estrelas e exibe tendências de tópicos.
Quando funciona
- A pergunta está centrada em produtos ou nichos da Amazon
- Sua equipe já trabalha no Seller Central
- As visualizações nativas de tópicos e tendências respondem à decisão
- Você quer baixa sobrecarga de configuração
Onde verificar o ajuste
- Elegibilidade e disponibilidade no marketplace
- Cobertura exata de produto e nicho
- Necessidades de exportação e integração
- Profundidade histórica
- Requisitos de taxonomia personalizada
- Necessidades de feedback multicanal ou fora da Amazon
As ferramentas nativas são uma base sólida. Compare alternativas pagas com a resposta nativa que você já pode obter, e não com uma planilha em branco.
Alternativa 4: um conjunto abrangente de ferramentas para vendedores da Amazon
Conjuntos de ferramentas para vendedores combinam várias tarefas, como pesquisa de produtos, análise de palavras-chave, fluxos de trabalho de listagem, publicidade e operações. A análise de avaliações pode estar incluída como um recurso.
A nuance de agosto de 2026 é que alguns recursos de análise de avaliações de suites de vendedor agora se posicionam em torno dos dados oficiais de feedback do cliente da Amazon, e não apenas em torno do texto exportado das avaliações. Isso pode ser uma vantagem significativa para equipes que querem um sinal adjacente ao Seller Central sem criar um fluxo de trabalho via API. Também significa que você deve verificar se o recurso é principalmente uma visão de tópicos nativos, um fluxo de trabalho de análise de texto de avaliações ou um sistema mais profundo de evidências para decisão.
Quando funciona
- Os mesmos usuários precisam de vários fluxos de trabalho de vendedor
- A consolidação da ferramenta reduz o atrito operacional
- A análise de avaliações dá suporte, em vez de definir, o trabalho
- Um conjunto consistente é mais valioso do que a profundidade máxima em um único módulo
- A cobertura de tópicos nativos da Amazon é suficiente para a questão e a suite já controla o fluxo de trabalho ao redor
Onde verificar a adequação
- Se o recurso usa dados de tópicos nativos da Amazon, exportações de texto de avaliações, análise proprietária ou uma mistura
- O escopo exato de ASIN, marketplace, idioma e elegibilidade
- Comparação entre concorrentes e múltiplos ASINs
- Exportações de avaliações
- Personalização de temas
- Rastreabilidade das evidências
- Monitoramento e alertas
- Se o recurso necessário está incluído no plano relevante
Não compare os preços da suite usando apenas o recurso de avaliações. Compare o conjunto total de tarefas que sua equipe realmente usará.
Alternativa 5: uma plataforma especializada de análise de avaliações
Uma plataforma especializada faz sentido quando a linguagem do cliente é uma entrada operacional recorrente, e não uma tarefa ocasional de pesquisa.
Quando funciona
- Várias equipes usam evidências de avaliações
- Você compara produtos, concorrentes ou categorias repetidamente
- A consistência dos temas importa ao longo do tempo
- As palavras exatas do cliente informam listagens e decisões de produto
- Monitoramento e relatórios reutilizáveis fazem parte do fluxo de trabalho
A Análise de VOC da VOC AI é um exemplo dessa abordagem. Ela foi projetada para agrupar feedback por ponto de dor, expectativa e menção de recurso; conectar reclamações recorrentes a decisões de produto e listagem; e usar inteligência de avaliações em dashboards, fluxos de trabalho de agentes e acesso via API.
A pergunta de compra não é se um especialista consegue criar mais gráficos. É se ele reduz o trabalho repetido entre a avaliação da fonte, a conclusão suportada, o responsável e a próxima ação.
Alternativa 6: um pipeline de API personalizado
Um pipeline personalizado é a alternativa com maior controle e a mais fácil de subestimar.
Quando funciona
- A inteligência de reviews deve estar incorporada em um produto interno
- Você precisa de uma taxonomia proprietária ou de um modelo de pontuação
- Grandes conjuntos de produtos exigem processamento agendado
- Os resultados devem ser integrados com dados de vendas, devoluções, suporte ou qualidade
- Há responsáveis de engenharia e governança de dados disponíveis
O que você controla
- Acesso legal aos dados
- Esquemas e resolução de identidade
- Deduplicação e tratamento de idiomas
- Seleção e avaliação de modelos
- Versionamento de temas
- Armazenamento de evidências
- Permissões e retenção
- Monitoramento e manutenção
A comparação entre desenvolver e comprar deve incluir QA contínuo e responsabilidade, não apenas o primeiro protótipo.
Ferramentas nomeadas de analytics de reviews da Amazon e alternativas
As categorias acima são mais úteis do que uma lista genérica de “principais ferramentas”, porque vários produtos que aparecem juntos nos resultados de busca resolvem trabalhos diferentes. Ainda assim, os compradores precisam de nomes para uma lista prática de seleção.
Use o mapa a seguir como ponto de partida, não como uma classificação final. O acesso ao produto, a cobertura de marketplace, as exportações e a embalagem podem mudar. Verifique o fluxo de trabalho atual com o fornecedor e teste cada finalista no mesmo conjunto de ASINs.
| Opção | Modelo operacional | Melhor caso de uso inicial | O que verificar antes de fazer a shortlist |
|---|---|---|---|
| Amazon Customer Review Insights | Análise nativa da Amazon dentro do Product Opportunity Explorer | Estabelecer uma linha de base nativa para tópicos, trechos, efeitos nas avaliações e tendências | Elegibilidade da conta, cobertura de marketplace e nicho, opções de exportação, profundidade histórica e se a taxonomia nativa responde à sua decisão |
| Amazon Customer Feedback API | Entrada da API da Amazon para um fluxo de trabalho governado | Levar tópicos elegíveis de feedback do cliente para relatórios internos ou aplicativos | Endpoints e escopo de dados disponíveis, comportamento de atualização semanal, limites de idioma e marketplace, autorização, regras de retenção, responsabilidade de engenharia, armazenamento de evidências a jusante e manutenção contínua |
| Helium 10 Review Insights | Recurso da suíte de vendedor que usa dados da Amazon Customer Feedback API | Combinar tópicos de feedback da Amazon com outras pesquisas de vendedor e fluxos de trabalho de listagem | Quais planos e marketplaces incluem o fluxo de trabalho necessário, se os dados de tópicos da API são suficientes para sua decisão, profundidade de exportação, controles de comparação personalizados e se os temas permanecem vinculados às evidências de origem |
| SellerSprite Review Analysis | Suíte de pesquisa da Amazon com fluxos de trabalho de análise de avaliações | Pesquisa de concorrentes e produtos dentro de uma stack de pesquisa para vendedores | Cobertura de ASIN e marketplace, controles de comparação, filtros de data, exports, comportamento da taxonomia e como a saída se encaixa no processo de pesquisa existente da equipe |
| ReviewMeta | Triagem de autenticidade de avaliações | Verificar se um conjunto de avaliações pode conter padrões suspeitos antes de uma interpretação mais profunda | Se a saída aborda triagem de autenticidade em vez de análise de temas do produto, a metodologia usada e como a visão ajustada influenciará a decisão |
| Assistente de IA de uso geral | Camada flexível de análise sobre um conjunto de dados que você já controla | Elaborar uma taxonomia, extrair evidências ou testar rapidamente uma pergunta específica | Acesso legal aos dados, limites de entrada, repetibilidade, versionamento de prompts e modelos, citações em nível de avaliação e procedimentos de auditoria humana |
| VOC AI Voice of Customer Analysis | Plataforma especializada de inteligência de avaliações e feedback | Análise recorrente entre produtos, concorrentes, equipes ou canais de feedback | Cobertura de fontes, rastreabilidade das evidências, controles de taxonomia, monitoramento, colaboração, exports, adequação à API e a transferência exata da descoberta para a decisão |
Esta tabela é deliberadamente não um ranking de um a sete. Os insights nativos da Amazon podem ser a melhor resposta para uma questão estreita do Seller Central. O ReviewMeta pode ser útil como verificação de autenticidade, mas não substitui a análise de temas. Um pacote de ferramentas para vendedores pode vencer quando a consolidação é importante. Um especialista ou um fluxo de trabalho via API torna-se mais relevante quando as mesmas evidências precisam embasar decisões recorrentes de produto, marketing, pesquisa e operações.
O ajuste importante para 2026 é evitar contar duas vezes o mesmo sinal nativo. Se um módulo de um pacote de ferramentas para vendedores e um fluxo de trabalho direto via API estiverem ambos extraindo dados da Customer Feedback API da Amazon, compare-os pelo fluxo de trabalho, exportações, controles e responsabilidade operacional — e não pela suposição de que revelam dois conjuntos de dados subjacentes completamente diferentes.
Para uma decisão de renovação ou substituição, adicione mais uma coluna à sua cópia interna desta tabela: o que esta opção aposentaria? Se a resposta for "nada", você talvez esteja adicionando outra superfície de análise de avaliações em vez de substituir trabalho. Uma nova alternativa de análise de avaliações da Amazon deve aposentar a montagem manual de evidências, taxonomias inconsistentes, relatórios baseados em capturas de tela, limpeza lenta de exportações ou um painel que ninguém usa para tomar decisões.
Compare ferramentas nomeadas usando um único pacote de teste compartilhado
Crie um pacote de teste antes de abrir demonstrações de fornecedores:
- Um ASIN focal: o produto com uma decisão real pendente.
- Dois ASINs de comparação: um concorrente próximo e uma alternativa significativamente diferente.
- Uma janela fixa: por exemplo, os 90 ou 180 dias mais recentes, além de uma visualização de referência de todo o período.
- Cinco avaliações conhecidas: exemplos que sua equipe já codificou, incluindo comentários ambíguos ou com sentimento misto.
- Um entregável obrigatório: um briefing de listagem, um memorando de problemas do produto, um relatório de risco de lançamento ou uma comparação com concorrentes.
- Uma regra de evidência: toda afirmação importante deve apontar para o texto exato da avaliação e preservar ASIN, data, classificação e contexto do marketplace.
Depois, peça a cada finalista que responda às mesmas perguntas:
- O que mudou recentemente em vez de apenas aparecer com frequência ao longo de todo o período?
- Quais mecanismos de reclamação separam o ASIN focal das duas alternativas?
- Qual conclusão fica mais fraca quando avaliações duplicadas, vagas ou suspeitas são removidas?
- Quais avaliações-fonte sustentam as três principais descobertas?
- Que artefato de decisão pode ser exportado e entregue a um responsável?
Isso transforma uma comparação de recursos em uma comparação controlada de fluxo de trabalho.
Escolha uma alternativa pelo constrangimento
Se sua lista reduzida ainda estiver muito ampla, comece pela restrição mais difícil de mudar.
| Restrição rígida | Opção padrão para testar primeiro | Por quê |
|---|---|---|
| Sem orçamento e uma decisão estreita | Codificação manual ou uma planilha controlada com auxílio de IA | Mantém o fluxo de trabalho pequeno enquanto preserva acesso direto às evidências |
| Seller Central é o centro do trabalho | Insights nativos da Amazon | Testa se a própria visão da plataforma já responde à pergunta com configuração mínima |
| A equipe quer um único conjunto de operações para sellers | Suite ampla para sellers | Consolida vários fluxos de trabalho quando a análise de avaliações é apenas uma parte do trabalho; verifique se sua camada de avaliações é nativa/baseada em API ou uma análise de evidências mais profunda |
| A evidência das avaliações é usada semanalmente por várias equipes | Plataforma especializada de análise de avaliações | Prioriza repetibilidade, taxonomia compartilhada, rastreabilidade, monitoramento e resultados reutilizáveis |
| A inteligência de avaliações precisa viver dentro de um produto interno | Customer Feedback API ou outro pipeline de API governado | Oferece controle sobre esquemas, integrações, permissões e lógica de decisão proprietária |
| A confiança no corpus de avaliações é a preocupação imediata | Ferramenta de verificação de autenticidade antes da análise de temas | Separa a questão “Podemos confiar neste corpus?” de “O que os clientes estão vivenciando?” |
| A equipe precisa combinar avaliações com suporte, devoluções, pesquisas ou feedback social | Plataforma cross-channel de Voz do Cliente ou pipeline liderado por data warehouse | Evita que a decisão fique limitada a uma única fonte de feedback autoselecionada |
O padrão é apenas um primeiro teste. Uma restrição rígida reduz o campo; a prova no mesmo ASIN determina o vencedor.
Reduza o mercado a três a cinco finalistas
Uma comparação se torna menos útil quando todos os produtos possíveis permanecem na planilha. O objetivo da primeira passada não é selecionar um vencedor. É eliminar abordagens que não conseguem sustentar a decisão exigida.
Em uma lista curta de comparação e alternativas para Amazon review analytics, o conjunto mais forte normalmente mistura modelos operacionais em vez de reunir várias ferramentas que resolvem o mesmo trabalho.
Comece com seis filtros inegociáveis:
- Cobertura: a abordagem consegue analisar os ASINs, marketplaces, idiomas, intervalo de datas e variações necessários.
- Evidência: temas importantes podem ser rastreados até o texto exato da avaliação.
- Comparação: os produtos podem ser comparados com a mesma janela de tempo, denominador e taxonomia.
- Fluxo de trabalho: a saída pode chegar ao responsável que precisa agir com base nela.
- Governança: acesso aos dados, retenção, permissões e tratamento das avaliações estão alinhados à sua política.
- Adequação operacional: sua equipe consegue executar, auditar e manter o fluxo de trabalho após o piloto.
Elimine qualquer opção que falhe em um verdadeiro requisito inegociável. Não deixe uma demo forte, um preço inicial baixo ou uma longa lista de recursos compensarem uma exigência ausente.
Sua lista curta normalmente deve conter diferentes modelos operacionais, e não cinco fornecedores quase idênticos. Um conjunto útil de três a cinco finalistas pode incluir:
- Insights de avaliações nativas da Amazon como linha de base
- Um conjunto amplo de ferramentas para vendedores se a consolidação for importante
- Uma ou duas plataformas especializadas de análise de avaliações
- Um fluxo de trabalho de IA geral, se a equipe já controla o conjunto de dados
- Um caminho de API personalizada se a análise precisar ser incorporada
Incluir uma linha de base impede que um produto pago vença apenas por ser mais refinado do que não fazer nada. Incluir também uma alternativa de construção ou manual credível expõe qual parte do fluxo de trabalho pago cria valor.
Use um scorecard ponderado de análise de avaliações da Amazon
A ponderação igual oculta a decisão. Uma equipe de listagem, uma equipe de qualidade, um grupo de pesquisa e uma equipe de plataforma de dados não devem obter a mesma pontuação.
Para a aquisição de Amazon review analytics: comparação e alternativas, defina os pesos antes das demonstrações para que a interface mais polida não reescreva os requisitos.
Use uma classificação de 0 a 5 para cada critério:
- 0: ausente ou inutilizável
- 1: possível apenas por meio de trabalho manual intenso
- 2: parcialmente suportado com lacunas importantes
- 3: suficiente para o piloto
- 4: forte e repetível
- 5: comprovado no fluxo de trabalho exato
Em seguida, aplique pesos que totalizem 100%. A pontuação ponderada é:
Pontuação ponderada = soma de (classificação do critério / 5 × peso do critério)
Aqui está um modelo inicial prático para um fluxo de trabalho recorrente de ecommerce:
| Critério | Peso | O que uma pontuação de 5 exige |
|---|---|---|
| Cobertura de avaliações e marketplace | 15% | Os produtos necessários, variantes, idiomas, datas e conjuntos de comparação estão disponíveis e documentados |
| Qualidade dos temas e controle da taxonomia | 15% | Os temas são coerentes, editáveis ou compreensíveis, estáveis o suficiente para comparação e testados com o seu vocabulário |
| Evidência textual e auditabilidade | 15% | Os usuários podem inspecionar texto de avaliações favorável e divergente sem reconstruir a análise |
| Lógica de comparação e tendência | 10% | Produtos e períodos usam denominadores, janelas e rótulos consistentes |
| Resultados do fluxo de trabalho | 10% | Os resultados se tornam briefings, relatórios, alertas, tickets ou pacotes de evidência com pouca readequação de formato |
| Controlabilidade da demonstração | 5% | A equipe pode forçar a mesma tarefa, conjunto de ASINs, filtros, saída e regras de evidência durante a avaliação |
| Repetibilidade e colaboração | 10% | Outro usuário qualificado pode executar novamente o fluxo de trabalho e reproduzir o artefato de decisão |
| Integração e exportação | 10% | As exportações necessárias, o acesso à API e as conexões de sistema estão disponíveis no plano e na escala exigidos |
| Governança e segurança | 5% | Os requisitos de acesso, retenção, permissões, processamento e exclusão estão documentados e são aceitáveis |
| Custo operacional total | 5% | Os custos de assinatura, uso, mão de obra, QA, implementação e manutenção estão visíveis |
Não trate a pontuação total como uma decisão de compra automática. Defina limites mínimos para critérios críticos. Por exemplo, um produto que pontua 88 no geral, mas apenas 1 em rastreabilidade das evidências, não deve vencer uma decisão de produto sensível a evidências.
Altere os pesos para a tarefa
Ajuste a ficha de avaliação antes de ver os resultados do fornecedor.
- Otimização do listing: aumente evidências textuais, cobertura de idiomas e resultados de fluxo de trabalho.
- Monitoramento de qualidade: aumente tendências ao longo do tempo, filtros de variantes, alertas e auditabilidade.
- Pesquisa de concorrentes: aumente a comparação entre múltiplos ASINs, a clareza da cobertura e a consistência da taxonomia.
- Estratégia de produto: aumente a qualidade dos temas, a colaboração e os links para evidências adjacentes do cliente.
- Análises incorporadas: aumente o acesso à API, a confiabilidade, a segurança, a observabilidade e a responsabilidade pela manutenção.
Escrever os pesos primeiro reduz a chance de que a demonstração mais impressionante determine os requisitos depois do fato.
Use um roteiro controlado de demonstração para os finalistas
A maioria das demonstrações de analytics de avaliações da Amazon é projetada para mostrar o caminho mais forte do produto. Isso é normal, mas pode fazer as alternativas parecerem mais diferentes ou mais completas do que realmente são. Um roteiro controlado de demonstração obriga cada finalista a realizar o mesmo trabalho com as mesmas restrições.
Use este roteiro após os filtros iniciais de triagem e antes da prova de 14 dias. O objetivo não é concluir a aquisição em uma única reunião. É revelar se cada finalista consegue მუშაობar dentro do seu padrão de evidência sem tratamento especial.
| Bloco de demo | O que pedir ao finalista para fazer | O que registrar |
|---|---|---|
| Confirmação do corpus | Mostrar os ASINs analisados, marketplace, janela de datas, contagem de avaliações, filtros e exclusões | Se o denominador está visível e se a equipe consegue reproduzir o mesmo corpus depois |
| Extração de temas | Identificar os principais mecanismos de reclamação e os principais diferenciais positivos | Se os rótulos são específicos o suficiente para encaminhar para os responsáveis por produto, listagem, suporte ou qualidade |
| Detalhamento das evidências | Abrir as avaliações de origem por trás de três alegações importantes e um contraexemplo | Se o texto exato da avaliação, a classificação, a data, o ASIN, o marketplace e o contexto permanecem anexados |
| Visão de mudanças recentes | Comparar um período recente com um período de base | Se as mudanças de tendência usam janelas e denominadores consistentes |
| Comparação com concorrentes | Comparar o ASIN foco com duas alternativas usando a mesma taxonomia | Se o fluxo de trabalho normaliza o volume de avaliações e as diferenças de produto |
| Tratamento de ambiguidade | Classificar cinco avaliações mistas ou ambíguas do conjunto de referência | Se a incerteza continua visível ou é convertida em rótulos excessivamente confiantes |
| Entrega da saída | Exportar ou gerar o artefato necessário: resumo, tabela, alerta, ticket, painel ou resposta de API | Se o resultado é utilizável fora da interface da demo |
| Administração e governança | Mostrar funções, configurações de retenção, controles de exportação, histórico de auditoria e documentação de API ou integração | Se o fluxo de trabalho pode sobreviver à revisão de segurança e à responsabilidade operacional |
Entregue o roteiro ao fornecedor ou à equipe de desenvolvimento interna antes da demo. Um finalista não deve ser penalizado por precisar de um tempo razoável de configuração, mas deve ser penalizado se não conseguir mostrar o corpus, as evidências, o denominador, a saída ou os controles que a decisão exige.
Crie um pacote de aceitação para cada finalista
Não deixe a avaliação como anotações em uma planilha de compras. Crie um pequeno pacote de aceitação para cada finalista:
| Item do pacote | Conteúdo obrigatório |
|---|---|
| Manifesto de entrada | ASINs, marketplace, data de extração, janela de datas, filtros, contagem de avaliações, exclusões e método de acesso aos dados |
| Artefato de saída | O entregável exato que a empresa usaria, e não um resumo de demo apenas com captura de tela |
| Apêndice de evidências | Avaliações de origem por trás das principais alegações, contraexemplos e pelo menos cinco casos-limite auditados |
| Cartão de pontuação | Avaliações ponderadas, resultados dos critérios mínimos e motivos para pontuações baixas |
| Registro de divergências | Diferenças materiais em relação ao conjunto de referência codificado por humanos e se elas alteraram a recomendação |
| Estimativa operacional | Tempo de configuração, tempo do analista, tempo de QA, trabalho de engenharia, cadência recorrente e manutenção esperada |
| Nota de risco | Lacunas de cobertura, preocupações de governança, limites de exportação, riscos de dependência e premissas que exigem confirmação |
Este pacote também é útil quando o comprador não está escolhendo um fornecedor. Se as alternativas forem análise manual, um fluxo de trabalho genérico de IA, uma plataforma especializada e um pipeline de API personalizado, o pacote mantém a comparação honesta. Cada opção deve produzir a mesma evidência de decisão.
Sinais de alerta durante a demonstração
Fique atento a estes padrões de falha:
- A demonstração não consegue mostrar quais avaliações foram incluídas.
- Gráficos importantes não podem ser rastreados até evidências no nível da avaliação.
- O sistema mescla mecanismos distintos em rótulos vagos, como “problema de qualidade”.
- As comparações com concorrentes usam janelas diferentes ou filtros ocultos.
- A saída funciona apenas como captura de tela ou slide editado manualmente.
- A exportação elimina IDs de evidência, definições de taxonomia, janelas de datas ou comentários.
- Avaliações ambíguas são forçadas a afirmações confiantes sem um campo de confiança.
- O fornecedor promete que uma API ou exportação pode dar suporte ao fluxo de trabalho, mas não consegue mostrar os campos, limites ou o esquema.
- Uma correção humana melhora a demonstração, mas não pode ser salva, versionada ou reproduzida.
- Os controles de governança são discutidos verbalmente, mas não são mostrados no produto ou na documentação.
Estes não são desqualificadores automáticos para todas as equipes. Um projeto pontual de analista pode tolerar mais reconstrução manual do que um fluxo operacional semanal. Mas os sinais de alerta devem ser considerados no custo de mão de obra, QA, migração e risco.
Transforme a demonstração em uma decisão de ir, ir condicionalmente ou não ir
Encerre cada avaliação finalista com um destes três status:
| Status | Usar quando | Próxima ação |
|---|---|---|
| Ir para prova | O finalista atende aos critérios inegociáveis de cobertura, evidência, fluxo de trabalho e governança | Inclua-o na prova de 14 dias com o mesmo conjunto de ASINs e o artefato exigido |
| Ir condicionalmente | O finalista é promissor, mas tem uma lacuna específica que pode ser testada rapidamente | Faça um follow-up direcionado, como uma verificação de exportação, revisão do esquema da API ou teste de controle de taxonomia |
| Não ir | O finalista não consegue preservar a evidência ou produzir a saída de fluxo de trabalho exigida | Remova-o da lista curta mesmo que a interface ou o preço pareça atraente |
O status deve citar evidências observadas. “A equipe gostou” não é uma decisão. “Não ir porque os três principais temas não puderam ser rastreados até as avaliações de origem ou exportados com janelas de datas” é.
Adicione um teste de aceitação do fluxo de trabalho ao vivo
Uma demonstração controlada prova que um finalista pode executar sob observação. Um teste de aceitação do fluxo de trabalho ao vivo prova que a equipe pode usar o resultado depois que a chamada termina.
Execute este teste com cada finalista antes da aprovação da compra:
| Teste de aceitação | Condição de aprovação | Por que isso importa |
|---|---|---|
| Transferência para o responsável | Um responsável não analista consegue ler o artefato e identificar a próxima ação recomendada, os suportes e as questões em aberto | O resultado sobrevive fora da sessão do analista ou do fornecedor |
| Desafio às evidências | Uma parte interessada pode clicar ou abrir as evidências por trás de três afirmações principais e um contraexemplo | A equipe pode defender o resultado no planejamento ou na revisão de qualidade |
| Verificação de повторição | Um segundo usuário pode executar novamente o mesmo fluxo de trabalho e reproduzir a პასუხa relevante para a decisão ou explicar mudanças controladas | O fluxo de trabalho não depende de um único operador especialista |
| Reconstrução da exportação | O arquivo exportado ou a resposta da API contém IDs, rótulos, janelas e campos de evidência suficientes para reconstruir a conclusão | A equipe pode auditar, migrar ou associar os resultados a outro sistema |
| Simulação de falha | A equipe sabe o que acontece quando um produto tem poucas avaliações, idioma misto, ambiguidade de variantes ou padrões suspeitos | Os casos extremos permanecem visíveis em vez de se tornarem resumos confiantes |
Esta é a linha prática entre uma demonstração útil e um processo operacional utilizável. Para a análise de avaliações da Amazon, uma ferramenta que falhe no teste de aceitação deve permanecer em um papel exploratório, mesmo que tenha gráficos atraentes.
Compare o custo operacional total, não o preço da assinatura
As alternativas de análise de avaliações da Amazon deslocam o trabalho entre software, analistas, operadores e engenheiros. Uma comparação justa inclui todos eles.
O modelo de custo mais útil de análise de avaliações da Amazon: comparação e alternativas mede decisões concluídas, não apenas assentos, créditos ou volume de avaliações.
Estime o custo operacional anual com estas categorias:
| Categoria de custo | Incluir |
|---|---|
| Plataforma | Assinatura, assentos, uso, limites de dados, complementos e nível de plano exigido |
| Implementação | Configuração, design de taxonomia, importações históricas, integrações, treinamento e documentação |
| Mão de obra de análise | Coleta, limpeza, elaboração de prompts, codificação, revisão, verificação de evidências e produção de relatórios |
| Garantia de qualidade | Auditorias por amostragem, revisão de divergências, verificações de falsos positivos, manutenção da taxonomia e testes de aceitação |
| Engenharia | Trabalho com API, pipelines de dados, orquestração, armazenamento, monitoramento, resposta a incidentes e atualizações |
| Governança | Revisão de segurança, administração de acesso, retenção, exclusão, revisão jurídica e gestão de fornecedores |
| Custo de mudança | Redesenho do fluxo de trabalho, migração, adoção pelas partes interessadas e operação paralela durante o lançamento |
Para cada finalista, calcule:
Custo operacional anual = plataforma + amortização da implementação + mão de obra + QA + engenharia + governança + custo de mudança
Depois, divida pelos artefatos de decisão concluídos, não pelo número de avaliações processadas:
Custo por decisão concluída = custo operacional anual / artefatos de decisão aceitos
Um sumarizador de baixo custo pode se tornar caro se os analistas reconstruírem evidências repetidamente, reconciliarem taxonomias e reformatarem saídas. Uma plataforma de custo mais alto ainda pode ser o modelo operacional mais barato se eliminar trabalho recorrente. O inverso também é verdadeiro: uma plataforma especializada é desperdício quando a equipe só precisa de duas análises pontuais por ano.
Use a calculadora de ROI de mineração de avaliações de produtos quando precisar modelar mão de obra, payback e benefícios ponderados por confiança com mais detalhes.
Teste a capacidade de saída antes de se comprometer
A maioria das comparações de analytics de avaliações da Amazon foca em colocar dados em uma ferramenta. Uma decisão de produção também precisa testar como as evidências saem de volta.
Isso não é apenas uma preocupação de compras. Seu fluxo de trabalho pode mudar porque uma equipe foi reorganizada, um marketplace ou integração mudou, um fornecedor alterou seu produto, um padrão interno de dados amadureceu ou um modelo operacional melhor se tornou disponível. Se a evidência, a taxonomia e o histórico de decisões não puderem acompanhá-lo, o aparente vencedor pode criar um segundo projeto de implementação mais tarde.
Adicione uma pontuação de capacidade de saída à comparação antes da decisão de contrato ou de implantação. Pontue cada linha de 0 a 2:
- 0: indisponível ou visível apenas dentro da interface
- 1: parcialmente disponível, achatado ou dependente de trabalho manual
- 2: exportável em um formato documentado e reutilizável
| Teste de capacidade de saída | O que um resultado reutilizável deve preservar | Por que isso importa |
|---|---|---|
| Evidência de origem | Texto da avaliação ou referência aprovada à fonte, ID estável da evidência, ASIN, classificação, data, marketplace, variação e outros contextos disponíveis | Mantém os temas auditáveis após a mudança da interface |
| Análise codificada | Atribuição de tema, mecanismo, sentimento, confiança, versão do analista ou do modelo e exceções | Impede que uma migração volte a se reduzir a texto bruto |
| Taxonomia | Nomes de temas, definições, hierarquia, aliases, exclusões e histórico de versões | Preserva o significado de linhas de tendência e comparações |
| Métricas derivadas | Numeradores, denominadores, filtros, janelas de datas, conjunto de comparação e notas de cálculo | Torna os dashboards reproduzíveis em vez de decorativos |
| Registros do fluxo de trabalho | Responsáveis, status, comentários, decisões, artefatos vinculados e datas de revisão | Mantém o insight conectado à ação e à responsabilização |
| Configuração de entrega | Consultas salvas, regras de alerta, agendas, webhooks, mapeamentos de API e destinos | Revela o trabalho operacional necessário para reconstruir o fluxo de trabalho |
| Registros de governança | Papéis, permissões, histórico de auditoria, regras de retenção e estado de exclusão quando disponível | Oferece suporte à revisão de segurança e à transferência controlada |
| Documentação | Definições de campos, formato de exportação, versão da API ou do schema, limites e omissões conhecidas | Permite que outra equipe interprete o pacote sem depender de conhecimento tribal |
Não recompense uma exportação gigantesca apenas porque ela contém muitas colunas. O teste é se outro analista consegue reproduzir um artefato de decisão aceito a partir do pacote exportado sem reabrir a ferramenta original.
Execute um teste de exportação de 60 minutos
Use o mesmo ASIN focal e a mesma pergunta de decisão do teste de 14 dias.
- Solicite a exportação padrão. Não peça um contrato de serviços personalizado nem um extrato de engenharia pontual. Teste o que um proprietário de conta comum consegue recuperar.
- Rastreie cinco descobertas importantes. Para cada tema, localize as evidências de reviews de apoio, o contexto do produto, a janela de datas, a definição da taxonomia e a base de cálculo.
- Reconstrua um deliverable fora da ferramenta. Recrie uma tabela de prioridade de reclamações, um resumo em linguagem de listagem, uma tabela de lacunas de concorrentes ou um handoff de monitoramento a partir dos arquivos exportados.
- Registre o que desaparece. Observe links de evidência ausentes, texto de reviews truncado, filtros perdidos, hierarquias achatadas, pontuações não documentadas, comentários inacessíveis e lógica de alertas que precisa ser refeita manualmente.
- Estime o tempo de reconstrução. Some as horas necessárias para limpar, mapear, validar, documentar e restaurar o fluxo de trabalho. Coloque essa estimativa na linha de custo de mudança do modelo de custo operacional.
Um finalista passa no teste de exportação quando a equipe consegue explicar o conjunto de dados, reproduzir o artefato escolhido e identificar toda limitação importante. Um CSV bruto sem definições não passa. Uma captura de tela não passa. Uma promessa de que “a API provavelmente consegue fazer isso” não passa até que os campos e limites tenham sido demonstrados.
Para opções baseadas em API, inspecione o schema mantido em vez de confiar em uma descrição comercial. A Amazon publica seus modelos da Selling Partner API, incluindo o modelo da Customer Feedback API. Uma API especializada deve fornecer a mesma clareza para os campos de origem, campos analisados, versões, autenticação, cotas, erros e comportamento de exclusão relevantes para seu fluxo de trabalho.
Use um plano de migração de 30 dias para as duas opções finais
A melhor comparação não espera por um cancelamento futuro para descobrir se a troca é possível. Execute um ensaio de migração delimitado entre os dois modelos operacionais finais.
Dias 1-5: inventarie o fluxo de trabalho atual
- Liste cada entrada, visualização salva, taxonomia, relatório recorrente, alerta, integração, responsável e artefato de decisão downstream.
- Marque os registros que precisam ser retidos para auditoria, continuidade de tendência ou uso operacional.
- Congele um conjunto de comparação e uma janela de datas para que ambos os sistemas sejam avaliados com as mesmas evidências.
- Defina o gatilho de rollback antes de qualquer corte para produção.
Dias 6-10: exporte e mapeie
- Exporte evidências de origem, análise codificada, taxonomia, métricas derivadas e registros do fluxo de trabalho.
- Mapeie os campos de origem para o schema de destino e rotule os campos sem equivalente.
- Separe a perda real de dados das diferenças de apresentação.
- Documente as transformações para que o resultado migrado possa ser executado novamente.
Dias 11-20: execute em paralelo uma decisão recorrente
- Execute as abordagens antiga e nova na mesma janela de reviews recente.
- Compare cobertura, atribuições de temas, recuperação de evidências, denominadores, direção da tendência e recomendações finais.
- Investigue divergências em vez de fazer uma média entre elas.
- Acompanhe o tempo do analista, o tempo de QA, o trabalho de engenharia e as transferências de responsabilidade em ambos os fluxos de trabalho.
Dias 21-25: aplique os critérios de aceitação
Exigir aprovação em:
- Rastreabilidade das evidências para as conclusões de maior prioridade
- Mapeamento da taxonomia e descontinuidades conhecidas
- Métricas reproduzíveis e janelas de datas
- Exportações, integrações, permissões e alertas exigidos
- Responsáveis nomeados por exceções e trabalhos com falha
- Um plano documentado de arquivamento e retenção
Dias 26-30: faça a transição ou pare
Faça a transição apenas se a solução candidata concluir o fluxo de decisão real e se o pacote de migração for compreensível fora da equipe de implementação. Mantenha o sistema anterior em modo somente leitura durante o período de retenção acordado quando isso for permitido e útil. Pare ou reverta se faltar evidência de alta prioridade, a continuidade das tendências não puder ser explicada, os resultados exigidos falharem ou o ônus operacional exceder o modelo aprovado.
Esse ensaio transforma o risco de migração de uma questão vaga de compras em trabalho observado. Ele também revela uma alternativa útil: se nenhum dos finalistas conseguir preservar as evidências e os registros de fluxo de trabalho de que você precisa, uma camada de dados governada menor pode ser mais valiosa do que outro painel.
Uma árvore de decisão simples
Use esta sequência para reduzir as alternativas.
Etapa 1: trata-se de uma decisão única e restrita?
Se sim, comece com análise manual ou com um assistente geral de IA. Não compre um sistema operacional para uma pergunta pontual.
Etapa 2: a visão nativa da Amazon consegue responder?
Se a decisão for específica da Amazon e o Customer Review Insights fornecer contexto suficiente de produto, nicho, tópico, trecho e tendência, use primeiro o fluxo de trabalho nativo.
Etapa 3: você precisa do restante de uma suíte de seller?
Se palavras-chave, listagens, pesquisa de produtos, publicidade e ferramentas operacionais também forem prioridades, compare suítes amplas no conjunto de trabalhos combinado.
Etapa 4: a inteligência de reviews é recorrente e multifuncional?
Se produto, marketing, suporte, pesquisa ou liderança precisarem repetidamente das mesmas evidências, avalie uma plataforma especializada.
Etapa 5: os insights precisam fluir para sistemas proprietários?
Se sim, compare o acesso especializado à API com um pipeline personalizado. Escolha o desenvolvimento sob medida apenas quando o controle exigido valer o ônus de engenharia e governança.
Faça uma prova de 14 dias antes de se comprometer
Teste os finalistas na mesma decisão e no mesmo conjunto de produtos.
Dias 1-2: defina o teste
- Escolha uma decisão
- Selecione seu ASIN e dois a cinco concorrentes relevantes
- Fixe a janela de tempo
- Defina cinco a dez temas esperados
- Decida quais evidências devem ser retidas
- Nomeie o fluxo de trabalho atual que o finalista deve superar, incluindo etapas manuais e tempo do responsável
Dias 3-7: execute cada abordagem
Acompanhe:
- Tempo de configuração
- Avaliações ou produtos cobertos
- Precisão dos temas
- Tempo para recuperar evidências
- Capacidade de encontrar contraexemplos
- Utilidade para comparação e tendência
- Esforço de exportação ou transferência
- Quais etapas atuais seriam eliminadas, reduzidas ou mantidas
Dias 8-10: audite a saída
Inspecione manualmente uma amostra das avaliações de origem. Procure temas perdidos, rótulos incorretos, resumos excessivamente generalizados, categorias duplicadas e conclusões baseadas em evidências frágeis.
Dias 11-14: produza uma entrega real
Crie o artefato de que o negócio precisa: um resumo de mudança de produto, um briefing de linguagem da listagem, uma tabela de lacunas competitivas, uma investigação de qualidade ou um relatório de monitoramento.
A abordagem vencedora é aquela que produz um artefato de decisão confiável com o mínimo de trabalho repetido e o caminho de substituição mais claro, não a demo mais impressionante.
Defina a aceitação de produção antes de o piloto terminar
Um bom piloto ainda pode falhar em produção se a equipe nunca definir a responsabilidade e os padrões de serviço. Antes da seleção, escreva uma folha de aceitação para o fluxo de trabalho em produção.
Inclua:
- Responsável: quem executa a análise e quem aprova o artefato de decisão
- Cadência: pontual, semanal, mensal, acionado por lançamento ou acionado por incidente
- Entradas: produtos, concorrentes, marketplaces, idiomas, janelas de datas e conjuntos de dados conectados
- Padrão de evidência: quantos exemplos de origem, contraexemplos e verificações manuais são necessários
- Saída: o briefing, dashboard, alerta, ticket ou resposta de API exato que os usuários a jusante recebem
- Limiar de qualidade: precisão aceitável do tema, taxa de temas perdidos, taxa de alegações sem suporte e processo de divergência entre analistas
- Caminho de falha: o que acontece quando os dados estão incompletos, a taxonomia muda ou a saída do modelo não é confiável
- Controle de mudanças: quem pode alterar prompts, rótulos, regras, modelos ou integrações
- Monitoramento: quais sinais de cobertura, latência, erro, desvio e adoção são revisados
- Plano de saída: como dados, taxonomias, evidências e fluxos de trabalho podem ser exportados ou migrados
Trate a documentação do fornecedor, as respostas de segurança e os resultados do piloto como evidência para esta folha. Uma promessa verbal feita durante uma demo não é um controle de produção.
Defina gates mínimos antes de olhar para a pontuação final
Scorecards ponderados são úteis, mas podem diluir fraquezas que desqualificariam a solução. Defina gates mínimos que não possam ser compensados por pontos fortes não relacionados.
Para um fluxo de trabalho recorrente de análise de avaliações da Amazon, comece com estes gates:
| Gate | Evidência mínima aceitável |
|---|---|
| Clareza do corpus | Os produtos analisados, o marketplace, as datas, a contagem de avaliações, os filtros e as exclusões ficam visíveis ou exportáveis |
| Rastreabilidade no nível da avaliação | Temas importantes retornam à linguagem original do cliente, e não apenas a resumos gerados |
| Comparação consistente | Os produtos focal e concorrentes usam a mesma janela, denominador e taxonomia, a menos que exceções sejam divulgadas |
| Análise de mudanças recentes | O fluxo de trabalho consegue separar o volume de todo o período de uma mudança recente |
| Saída de decisão | O resultado pode se tornar um artefato de decisão sem montagem manual de capturas de tela |
| Adequação à governança | Acesso, retenção, exportações, uso de API e tratamento de avaliações se encaixam nas regras da plataforma e na política interna |
| Capacidade de saída | Evidências, taxonomia e saídas podem ser exportadas com estrutura suficiente para migração ou auditoria |
Um finalista que falhe em um desses gates ainda pode ser considerado para um projeto pontual. Ele não deve vencer um fluxo de trabalho recorrente entre equipes, a menos que a equipe aceite explicitamente o trabalho manual e o risco.
Faça a recomendação final como um memorando de decisão
O documento de seleção deve ser curto o suficiente para revisão e específico o suficiente para auditoria. Use esta estrutura:
Para decisões de comparação e alternativas em analytics de avaliações da Amazon, o memorando deve explicar por que o modelo operacional selecionado venceu a linha de base nativa e a melhor alternativa credível.
- Decisão: a abordagem de analytics de avaliações da Amazon que está sendo selecionada.
- Escopo: produtos, marketplaces, equipes, decisões e integrações incluídos.
- Alternativas consideradas: os três a cinco finalistas e por que cada um foi mantido.
- Evidências: pontuações ponderadas, resultados de gates, amostras de auditoria e o artefato real produzido durante a prova.
- Custo: custo operacional do primeiro ano e recorrente, com mão de obra e QA visíveis.
- Riscos: lacunas de cobertura, dependências de fluxo de trabalho, preocupações de governança e premissas que ainda precisam de validação.
- Lançamento: responsável, primeiro caso de uso, limites de aceitação, data de revisão e condições de expansão.
- Critérios de saída: as condições que acionariam uma reversão, substituição ou decisão de build.
Isso transforma “gostamos da ferramenta” em uma decisão que outra parte interessada pode questionar, aprovar e revisar novamente.
Trate as avaliações como sinais, não como uma pesquisa representativa
As avaliações da Amazon são feedback de clientes autoselecionados. Elas são valiosas porque contêm experiências específicas, modos de falha, expectativas e linguagem. Elas não devem ser tratadas automaticamente como uma estimativa representativa da opinião de todos os compradores.
As orientações de metodologia de pesquisa distinguem amostras probabilísticas de amostras não probabilísticas ou opt-in porque a chance de seleção não é conhecida neste último caso. A mesma cautela é útil aqui: a frequência das avaliações pode priorizar a investigação, mas por si só não prova a prevalência na população nem o impacto nos negócios.
Fortaleça as descobertas das avaliações com outras evidências quando possível:
- Motivos de devolução
- Contatos de suporte
- Reivindicações de garantia
- Analytics de produto
- Dados de vendas e conversão
- Registros de controle de qualidade
- Pesquisa estruturada com clientes
Use analytics de avaliações para encontrar e explicar sinais. Use dados operacionais correspondentes ou testes controlados para validar o impacto.
Perguntas frequentes
O que é analytics de avaliações da Amazon?
Analytics de avaliações da Amazon é o processo de organizar texto de avaliações, classificações, datas, produtos, variantes e linguagem do cliente em evidências que sustentam uma decisão. Uma análise útil vai além dos totais de sentimento. Ela identifica temas e mecanismos, preserva links para as avaliações de origem, compara produtos com regras consistentes e separa o volume recorrente da mudança recente.
Qual é a melhor alternativa à análise manual de avaliações da Amazon?
A melhor alternativa depende da tarefa recorrente. Use insights nativos da Amazon para uma questão específica do Seller Central, uma suíte de seller quando a análise de avaliações fizer parte de um fluxo de trabalho mais amplo do seller, uma plataforma especializada para inteligência repetível de avaliações entre equipes e um pipeline de API quando a saída precisar ser incorporada a sistemas proprietários. Um assistente de IA geral pode acelerar a análise apenas depois que você tiver um conjunto de dados legal e controlado e um processo de auditoria de evidências.
Os resumidores de avaliações da Amazon são o mesmo que ferramentas de analytics de avaliações?
Não. Um resumidor comprime o texto das avaliações. Um fluxo de trabalho de analytics também deve definir o corpus, preservar evidências no nível da avaliação, suportar comparação consistente, lidar com datas e segmentos, produzir outputs reutilizáveis e permitir que outro analista reproduza ou conteste o resultado. Resumos podem fazer parte do fluxo de trabalho, mas não são o fluxo de trabalho inteiro.
Devo escolher ferramentas nativas da Amazon ou software de terceiros?
Comece com a base nativa quando ela cobrir os produtos, marketplace, janela de tempo e decisão de que você precisa. Teste software de terceiros quando precisar de comparação mais ampla, taxonomias personalizadas, relatórios recorrentes, colaboração, evidências multicanal, exportações, monitoramento ou integração em outro sistema. Uma alternativa paga deve vencer porque completa melhor o fluxo de trabalho de decisão, e não porque o dashboard parece mais refinado.
O Helium 10 Review Insights é uma alternativa de analytics de avaliações da Amazon?
Sim, mas avalie-o como um fluxo de trabalho de avaliações de uma seller-suite, não como uma plataforma independente de inteligência de avaliações. A documentação atual diz que o Review Insights é alimentado pela Customer Feedback API da Amazon, o que pode ser útil quando os tópicos nativos de feedback da Amazon são a entrada certa. A questão da comparação é se esse fluxo de trabalho para sellers, baseado em API, oferece à sua equipe rastreabilidade de evidências, controle de comparação, exportações e transferência de decisão suficientes para o trabalho de que você precisa.
Como devo comparar ferramentas de analytics de avaliações da Amazon de forma justa?
Dê a cada finalista os mesmos ASINs, janela de datas, casos extremos conhecidos, pergunta de decisão e entregável exigido. Crie um pequeno conjunto de referência codificado por humanos, repita o teste sem alterar a entrada e registre divergências materiais. Defina os pesos antes das demos. Avalie cobertura, concordância temática, estabilidade entre execuções, rastreabilidade de evidências, lógica de comparação, tratamento de tendências, outputs, governança, integração, custo operacional e risco de migração. Rejeite qualquer opção que falhe em um critério inegociável, mesmo que sua pontuação total de recursos seja alta.
O que um pacote de aquisição de analytics de avaliações da Amazon deve incluir?
Um pacote de aquisição de analytics de avaliações da Amazon deve incluir a pergunta de decisão, ASINs foco e de comparação, marketplace, janela de datas, meta de contagem de avaliações, regras de evidência, base nativa, justificativa da shortlist, materiais da demo, objeções das partes interessadas, resultados das etapas de aprovação, estimativa de custo operacional e notas sobre capacidade de saída. O pacote deve permitir que um revisor inspecione a evidência de origem, entenda o denominador, conteste a comparação e decida se o finalista deve entrar em uma prova de 14 dias.
Quando devo substituir meu fluxo de trabalho atual de analytics de avaliações da Amazon?
Substitua o fluxo de trabalho atual quando ele perder repetidamente a evidência de origem, ocultar regras de denominador, não conseguir comparar produtos de forma consistente, exigir reconstrução manual para cada decisão, falhar na revisão de governança ou não conseguir exportar a taxonomia e o histórico de evidências antes da renovação. Em vez disso, reduza o escopo ou remedeie-o quando o fluxo de trabalho ainda suportar um trabalho específico, mas estiver sendo solicitado a fazer mais do que foi projetado para fazer.
Quanto deve custar o software de analytics de avaliações da Amazon?
O preço da assinatura, por si só, não é uma comparação confiável. Calcule o custo operacional total: custo de licença ou API, tempo do analista, preparação de dados, QA, engenharia, governança, treinamento, manutenção e custo de mudança. Divida esse total por uma unidade útil, como ciclos de decisão concluídos, ASINs monitorados ou entregáveis aprovados. Use uma prova de 14 dias para testar se o fluxo de trabalho realmente reduz o trabalho repetido.
As avaliações da Amazon podem provar quão comum é um problema do cliente?
Não por si só. As avaliações são feedback autoselecionado, então a frequência é um sinal para investigação, e não uma estimativa automática de prevalência entre todos os compradores. Preserve o denominador e a janela de tempo e, quando possível, valide os achados importantes com devoluções, contatos de suporte, reclamações de garantia, analytics do produto, testes नियंत्रados ou pesquisa estruturada.
Lista de verificação final para comparar alternativas de analytics de avaliações da Amazon
Antes de escolher, confirme que você consegue responder a estas perguntas:
- Qual conjunto exato de avaliações está sendo analisado?
- O finalista está usando dados de tópicos nativos da Amazon, texto bruto das avaliações, análise proprietária ou uma mistura?
- Todos os finalistas produziram o mesmo pacote mínimo viável de evidências?
- Todos os finalistas produziram o mesmo pacote de aquisição antes da reunião da shortlist?
- Posso inspecionar as avaliações por trás de cada tema importante?
- Posso comparar produtos usando denominadores e janelas de tempo consistentes?
- Posso separar volume histórico de mudanças recentes?
- Posso personalizar ou pelo menos entender a taxonomia?
- O resultado pode entrar no fluxo de trabalho onde as decisões acontecem?
- Outro analista pode executar o trabalho novamente?
- Uma execução repetida preserva a decisão ou explica por que ela mudou?
- Comparamos o resultado com um conjunto de referência codificado por humanos?
- Conseguimos diagnosticar divergências materiais sem reconstruir a análise manualmente?
- Todos os finalistas seguiram o mesmo roteiro de demonstração com os mesmos ASINs, janelas de data, regras de evidência e saída exigida?
- Todos os finalistas provaram quais etapas do fluxo de trabalho atual eles eliminariam, reduziriam ou deixariam intocadas?
- As partes interessadas de produto, ecommerce, qualidade, pesquisa, engenharia, segurança e finanças revisaram as evidências relevantes para seus riscos?
- O finalista escolhido passou em um teste de transferência para o fluxo de trabalho ao vivo com um responsável não analista?
- O processo está em conformidade com as regras da plataforma e com a governança interna?
- A ferramenta está substituindo trabalho repetido ou apenas adicionando mais um dashboard?
- Posso provar valor com um artefato real de decisão?
- Comparei três a cinco finalistas usando pesos definidos antes das demos?
- Incluí custo de mão de obra, QA, engenharia, governança e mudança?
- Há um responsável nomeado e uma folha de aceitação de produção?
- Definimos critérios mínimos antes de olhar a pontuação ponderada?
- Podemos exportar a evidência e a taxonomia se o fluxo de trabalho mudar?
Se a inteligência repetível de avaliações da Amazon for a camada que falta no seu fluxo de trabalho, use este guia de análise de avaliações da Amazon: comparação e alternativas como padrão de decisão e, em seguida, explore a análise de voz do cliente da VOC AI, compare sinais de avaliações em um fluxo de trabalho de pesquisa de produtos ou avalie a Review Analysis API para uma abordagem integrada.