Aktualisiert am 9. September 2026.
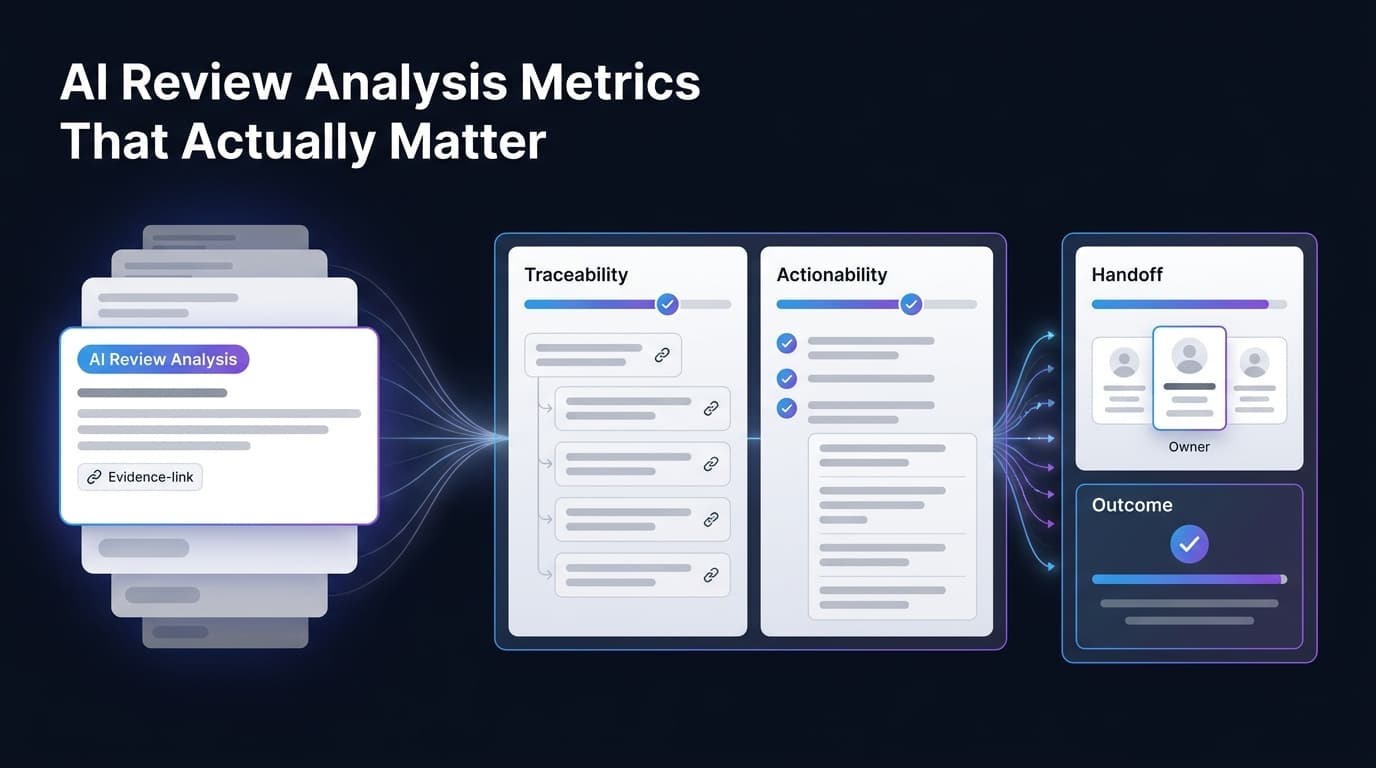
KI-Review-Analyse-Metriken sollten Ihnen zeigen, ob die Review-Analyse einem Team geholfen hat, eine bessere Entscheidung zu treffen. Sie sollten nicht bei Modellgenauigkeit, Sentiment-Charts oder der Anzahl verarbeiteter Reviews stehen bleiben.
Dieser Unterschied ist wichtig, weil KI-Review-Analyse meist für eine operative Aufgabe gekauft wird: zu entscheiden, was behoben, was entwickelt, was in einem Listing umgeschrieben, was überwacht oder welche Belege an eine verantwortliche Person aus Produkt, Support, E-Commerce oder Research gesendet werden sollen. Ein Dashboard kann vollständig aussehen und diese Aufgabe dennoch verfehlen.
Dieser Leitfaden bietet Ihnen einen praktischen Metrik-Stack für die KI-Review-Analyse: Evidenzabdeckung, Nachvollziehbarkeit, Themenqualität, Umgang mit Widersprüchen, Schweregrad, Übergabe an die Entscheidung, Zeitersparnis, Wiederverwendung und nachgelagerte Maßnahmen. Verwenden Sie ihn, wenn Sie KI-Review-Analyse-Tools bewerten, einen Pilotversuch überprüfen oder einen internen Review-Analyse-Workflow bereinigen.
Wenn Sie noch Tool-Kategorien vergleichen, beginnen Sie mit dem KI-Review-Analyse-Vergleich. Wenn Sie den operativen Workflow benötigen, verwenden Sie den praktischen Leitfaden zur KI-Review-Analyse. Diese Seite konzentriert sich auf die Messung: Wie Sie erkennen, ob der Workflow tatsächlich funktioniert.
Beginnen Sie mit der Entscheidungsmetrik
Bevor Sie irgendein Ergebnis der KI-Review-Analyse messen, formulieren Sie die Entscheidung, die sie unterstützen soll:
Wir analysieren diesen Review-Kohorten, damit diese verantwortliche Person diese Entscheidung bis zu diesem Datum treffen kann.
Dieser Satz hält die Metriken ehrlich. Wenn die Entscheidung lautet „die Produktdetailseite überarbeiten“, brauchen Sie Abdeckung der Käufersprache, Belege für Einwände und die Übergabe für Seitenänderungen. Wenn die Entscheidung lautet „Defekte priorisieren“, brauchen Sie Schweregrad, Wiederholung, Aktualität, betroffene Varianten und nachvollziehbare Beispiele. Wenn die Entscheidung lautet „Wettbewerber vergleichen“, brauchen Sie Kohortenkontrolle und einen Vergleich gleichartiger Themen.
Die erste Metrik ist die Entscheidungstauglichkeit:
| Metrik | Wie man sie misst | Gutes Zeichen | Warnsignal |
|---|---|---|---|
| Entscheidungstauglichkeit | Kann die Ausgabe die formulierte Entscheidungsfrage beantworten, ohne einen weiteren manuellen Prüfdurchlauf? | Die verantwortliche Person kann akzeptieren, ablehnen oder eine klare Rückfrage stellen | Die Ausgabe ist interessant, aber niemand weiß, was als Nächstes zu tun ist |
| Klarheit der Verantwortlichkeit | Lässt sich jede Erkenntnis Produkt, Listing, Support, Research, Operations oder Marketing zuordnen? | Jede Top-Erkenntnis hat eine verantwortliche Person | Themen liegen in einem gemeinsamen Dashboard ohne klaren Zuständigkeitsweg |
| Passung zum Entscheidungszeitpunkt | Kam die Analyse vor dem Planungs-, Launch-, Support- oder Review-Meeting an? | Die Evidenz ist bereit, wenn das Team entscheidet | Die Analyse trifft ein, nachdem sich das Entscheidungsfenster geschlossen hat |
Überspringen Sie diesen Schritt nicht. Die meisten schwachen Metriken der KI-Review-Analyse scheitern daran, dass sie das Modell isoliert bewerten, statt den Entscheidungs-Workflow zu bewerten.
Die 10 KI-Review-Analyse-Metriken, die zählen
Verwenden Sie diese Metriken als Stack. Sie brauchen nicht jede Metrik am ersten Tag, aber Sie brauchen mindestens eine Metrik für Umfang, Vertrauen, Handlung und Ergebnis.
| Ebene | Metrik | Was sie schützt | Was nicht optimiert werden sollte |
|---|---|---|---|
| Umfang | Abdeckungsrate der Evidenz | Die Analyse hat das richtige Review-Universum betrachtet | Die rohe Anzahl verarbeiteter Reviews |
| Vertrauen | Nachverfolgbarkeitsrate | Wichtige Aussagen können überprüft werden | Geglättete Zusammenfassungssprache |
| Signal | Themenpräzision und -abdeckung | Themen sind spezifisch und vollständig genug, um sie zu nutzen | Die bloße Anzahl der Themen |
| Risiko | Erhaltung von Widersprüchen | Segmentaufteilungen und Gegenbelege bleiben sichtbar | Erzwungener Konsens |
| Priorität | Schweregrad-gewichtete Problemrate | Dringende Probleme rücken über das Rauschen des Volumens hinaus nach oben | Erwähnungen ohne Konsequenz |
| Aktion | Umsetzungsrate | Erkenntnisse werden zu angenommener Arbeit | Generierte Ideen |
| Übergabe | Übergabe-Abschlussrate | Verantwortliche erhalten Evidenz und den nächsten Schritt | Dashboard-Abschluss |
| Effizienz | Gesparte Zeit pro akzeptierter Entscheidung | Das Team entscheidet schneller ohne verdeckte Nacharbeit | Allein die Verarbeitungsgeschwindigkeit |
| Verstärkung | Wiederverwendungsrate | Ergebnisse werden zu Bibliotheken, Baselines oder API-gestützten Workflows | Einmaliger Berichtsumfang |
| Ergebnis | Verknüpfung mit nachgelagerten Ergebnissen | Maßnahmen können anhand späterer Signale überprüft werden | Überzogene Zuschreibung |
Für einen ersten Pilotversuch wählen Sie Nachverfolgbarkeitsrate, Umsetzungsrate und gesparte Zeit pro akzeptierter Entscheidung. Diese drei Metriken der KI-Review-Analyse zeigen, ob der Workflow vertrauenswürdig ist, genutzt wird und schneller ist.
Metric 1: Abdeckungsrate der Evidenz
Die Abdeckungsrate der Evidenz fragt, ob die KI-Review-Analyse das richtige Review-Universum betrachtet hat.
Verwenden Sie diese Formel:
Abdeckungsrate der Evidenz = in die Analyse einbezogene Reviews / Reviews, die im Scope sein sollten
Der Scope sollte explizit sein:
- Produkt, ASIN, SKU, Variante, Plan, Feature oder Wettbewerber-Set
- Marktplatz, Kanal, Region oder Sprache
- Datumsbereich
- Sternebewertungsbereich
- Filter für verifizierten Kauf, falls relevant
- Start-, Kampagnen-, Supportvorfall- oder Produktversionsgrenze
- Ausgeschlossene Quellen oder Segmente
Für E-Commerce-Teams ist diese Metrik wichtiger als das reine Volumen. Eine Analyse von 10.000 Reviews kann trotzdem schwach sein, wenn alte Verpackungsbeschwerden mit einer neuen Variante vermischt werden, Wettbewerber- und First-Party-Reviews ohne Kennzeichnung kombiniert werden oder das Ein-Sterne-Kohortenbild ignoriert wird, das die Untersuchung ausgelöst hat. Die gleiche Logik gilt, wenn Teams Customer-Feedback-Analyse-Tools vergleichen: Die Kohorte muss zur Entscheidung passen.
Die öffentliche Seite Voice of Customer Analysis von VOC.AI ordnet die Review-Analyse so ein, dass Kundenbewertungen in Produktausrichtung, Käufersprache und marktreife Entscheidungen überführt werden. Der praktische Punkt für Ihren eigenen Prozess ist einfach: Messen Sie, ob die Kohorte zur Entscheidung passt, bevor Sie den Themen vertrauen.
Metric 2: Nachverfolgbarkeitsrate
Die Nachverfolgbarkeitsrate misst, wie viele wichtige Aussagen bis zu den Quell-Reviews zurückverfolgt werden können.
Verwenden Sie diese Formel:
Traceability-Rate = zitierte oder überprüfbare Aussagen / Gesamtzahl wichtiger Aussagen
Eine wichtige Aussage ist jede Aussage, die eine Entscheidung verändern könnte:
- "Kunden geben das Produkt zurück, weil der Deckel undicht ist."
- "Die Einrichtungsanleitung ist für Erstkäufer verwirrend."
- "Wettbewerber A gewinnt, weil Käufer der Akkulaufzeit vertrauen."
- "Die stärkste Kaufmotivation ist die Nutzung auf Reisen."
- "Die negative Stimmung hat nach der neuen Verpackung zugenommen."
Für jede wichtige Aussage sollte die KI-Review-Analyse genügend Belege bewahren, um die Quelle zu prüfen. Das können Review-IDs, zitierte Textauszüge, Produktlinks, Daten, Sternebewertungen, exportierte Belegzeilen oder eine andere Quellenreferenz sein, die Ihr Team erneut öffnen kann. Eine Zusammenfassung ohne Belege kann zur Orientierung nützlich sein, reicht aber nicht für Entscheidungen aus, die Roadmap, Listing, Support, Budget oder operative Änderungen betreffen.
Nachvollziehbarkeit ist auch der Punkt, an dem sich die KI-Review-Analyse von einer einfachen Review-Zusammenfassung unterscheidet. Eine Zusammenfassung komprimiert Sprache. KI-Review-Analyse auf Entscheidungsniveau hält den Pfad zurück zu den Belegen offen.
Metric 3: Theme precision and theme coverage
Theme precision fragt, ob extrahierte Themen spezifisch genug für den Einsatz sind. Theme coverage fragt, ob die Analyse die wichtigen Probleme in der Kohorte gefunden hat.
Beides tracken:
| Metrik | Frage | Starkes Ergebnis | Schwaches Ergebnis |
|---|---|---|---|
| Theme precision | Sind Themen klar unterscheidbar und konkret? | "Der Deckel leckt, wenn das Produkt seitlich in einer Arbeitstasche transportiert wird" | "Qualitätsproblem" |
| Theme coverage | Hat die Analyse die wichtigsten wiederkehrenden Probleme gefunden? | Erfasst Undichtigkeiten, Geruchsbindung, Verwirrung bei Ersatzteilen und Reibung beim Reinigen | Erfasst nur generische positive und negative Stimmung |
| Theme duplication | Werden ähnliche Themen sauber zusammengeführt? | "Der Ladeanschluss lockert sich nach 3-6 Monaten" ist ein verfolgtes Thema | Dasselbe Problem erscheint als Anschluss, Kabel, Laden und Haltbarkeit |
Ein schneller manueller Benchmark hilft. Ziehen Sie 30 bis 50 repräsentative Bewertungen heran. Bitten Sie eine Person aus Produkt, Support oder E-Commerce, die wichtigsten Themen aufzulisten. Vergleichen Sie dann die KI-Review-Analyse mit dieser Liste. Das Ziel ist nicht perfekte Übereinstimmung. Das Ziel ist zu erkennen, ob das Modell entscheidende Themen übersieht oder vage Cluster erzeugt, die nicht zugewiesen werden können.
Metric 4: Contradiction preservation
Gute KI-Review-Analyse glättet Meinungsverschiedenheiten nicht. Sie zeigt, wo Kunden gespalten sind.
Contradiction preservation misst, ob bedeutsame Gegenbelege sichtbar bleiben:
Widerspruchserhalt = Hauptthemen mit sichtbaren Gegenbelegen / Hauptthemen, bei denen Gegenbelege existieren
Beispiele:
- Einige Käufer sagen, das Produkt sei zu klein; andere loben die kompakte Größe.
- Neue Nutzer haben Schwierigkeiten mit der Einrichtung; Wiederholungskäufer sagen, die Einrichtung sei einfach.
- Ein-Stern-Bewertungen erwähnen Bruch; Fünf-Sterne-Bewertungen erwähnen Haltbarkeit bei leichter Nutzung.
- Käufer in den USA beschweren sich über die Größe; Käufer in der EU beschweren sich über das Materialgefühl.
Diese Metrik ist wichtig, weil viele E-Commerce- und Produktentscheidungen Segmententscheidungen sind. Ein Thema mag real sein, aber nicht universell. Wenn die KI-Review-Analyse die Aufteilung verschleiert, kann das Team überreagieren und das Segment schädigen, dem das Produkt bereits gefällt.
Metric 5: Severity-weighted issue rate
Themenvolumen allein ist eine schlechte Priorisierungsmetrik. Ein seltenes Problem mit Bezug zu Sicherheit, Rückerstattung, Compliance oder Kontorisiko kann wichtiger sein als eine häufige, aber kleine Präferenzabweichung.
Verwenden Sie eine nach Schwere gewichtete Sicht:
severity-weighted issue rate = issue frequency x severity score x recency weight
Halten Sie die Schweregradskala einfach:
| Severity | Meaning | Example |
|---|---|---|
| 1 | Präferenz- oder Formulierungsproblem | Käufer mögen einen Farbnamen nicht |
| 2 | Usability-Reibung | Käufer benötigen klarere Montageanleitungen |
| 3 | Produktfehler oder Erwartungsmismatch | Käufer melden Leckagen, frühes Brechen, fehlende Teile oder verwirrende Einrichtung |
| 4 | Risiko für Umsatz, Support oder Bindung | Käufer erwähnen Rücksendungen, Rückerstattungen, Abwanderung, Eskalation oder einen Wechsel zum Wettbewerber |
| 5 | Hochriskante Eskalation | Käufer beschreiben Sicherheits-, Rechts-, Konto-, Datenschutz- oder Plattformrichtlinien-Bedenken |
Bitten Sie die KI-Review-Analyse nicht darum, endgültige rechtliche, sicherheitsbezogene, medizinische, finanzielle oder Compliance-Entscheidungen zu treffen. Nutzen Sie sie, um Review-Belege sichtbar zu machen, die menschlich geprüft werden müssen. Die Metrik sollte Teams dabei helfen, Prüfungen zu priorisieren, nicht Urteile zu automatisieren.
Metric 6: Actionability rate
Die Actionability rate misst, wie oft die KI-Review-Analyse einen Befund liefert, der in einen echten Workflow überführt werden kann.
Verwenden Sie diese Formel:
actionability rate = findings converted into accepted actions / findings reviewed
Akzeptierte Maßnahmen können Folgendes umfassen:
- Produkt-Ticket
- Test der Listing-Texte
- Update der Support-Makros
- Update des Help Centers
- Follow-up zur Wettbewerbsrecherche
- Monitoring-Alarm
- Impuls für ein Kundeninterview
- Untersuchung von Garantie-, Rückerstattungs- oder Rücksendevorgängen
- API-gespeistes Dashboard oder wiederkehrender Bericht
Diese Metrik schützt das Team vor Insight-Theater. Ein Bericht mit 40 Befunden ist nicht unbedingt besser als ein Bericht mit sechs Befunden, wenn keiner der 40 die Prüfung übersteht. Verfolgen Sie akzeptierte Maßnahmen, nicht generierte Ideen.
Metric 7: Handoff completion rate
Die Handoff completion rate misst, ob das Ergebnis den richtigen Verantwortlichen mit genügend Kontext erreicht hat.
Verwenden Sie diese Formel:
handoff completion rate = findings with owner + evidence + next step / total accepted findings
Eine vollständige Übergabe umfasst:
- Verantwortlicher
- Beleglink oder Review-Beispiel
- betroffene Kohorte
- Schweregrad
- empfohlener nächster Schritt
- Entscheidungsfrist
- Folgemetrik
- Status
Dies ist eine der wichtigsten KI-Review-Analyse-Metriken für Teams, die bereits genug Dashboards haben. Der Engpass ist oft nicht das Finden eines Themas. Der Engpass ist, das Thema in das Betriebssystem zu bringen, in dem die Arbeit tatsächlich passiert.
Metric 8: Time saved per accepted decision
Gesparte Zeit ist nur dann nützlich, wenn sie an akzeptierte Entscheidungen gekoppelt ist.
Verwenden Sie diese Formel:
Zeitersparnis pro akzeptierter Entscheidung =
(manuelle Analysestunden - KI-gestützte Analysestunden) / akzeptierte Entscheidungen
Vermeiden Sie die Vanity-Variante: „Wir haben 20.000 Bewertungen in Minuten analysiert.“ Das mag stimmen und beweist dennoch keinen Mehrwert. Die bessere Frage ist, ob das Team schneller zu einer Entscheidung gekommen ist, ohne an Evidenzqualität zu verlieren.
Verfolgen Sie die Zeit nach Workflow:
| Workflow | Zu messende Zeit | Warum das wichtig ist |
|---|---|---|
| Produktfehler-Triage | Von der Kohorten-Auswahl bis zur akzeptierten Problem-Liste | Hilft Produkt und Operations, Prioritäten für Maßnahmen zu setzen |
| Listing-Umschreibung | Vom Abruf der Bewertungen bis zum freigegebenen Copy-Test-Briefing | Verknüpft Bewertungssprache mit Conversion-Arbeit |
| Wettbewerber-Review-Analyse | Vom Wettbewerber-Set bis zum Chancen-Briefing | Hilft Teams, Äpfel mit Äpfeln zu vergleichen |
| Support-Übergabe | Vom Beschwerde-Thema bis zum Makro- oder Eskalations-Update | Verwandelt Review-Analyse in Serviceverbesserung |
| Forschungsplanung | Von rohen Review-Belegen bis zu akzeptierten Interview-Prompts | Verknüpft Review-Themen mit Discovery-Arbeit |
Wenn KI-Review-Analyse Zeit spart, aber das Vertrauen senkt, verschwindet die Ersparnis später durch Nacharbeit. Kombinieren Sie diese Metrik mit Nachvollziehbarkeit, Themenqualität und Erhaltung von Widersprüchen.
Messgröße 9: Wiederverwendungsrate
Die Wiederverwendungsrate misst, ob Outputs der Review-Analyse zu wiederverwendbaren Assets werden statt zu Einmalberichten.
Verwenden Sie diese Formel:
Wiederverwendungsrate = in späteren Entscheidungen wiederverwendete Outputs / insgesamt abgeschlossene Outputs
Wiederverwendbare Assets umfassen:
- Käufer-Sprache-Bibliotheken
- Einwand-Bibliotheken
- Beschwerde-Taxonomien
- Matrixen mit Wettbewerbsbelegen
- Notizen zu Produktanforderungen
- Input für Support-Makros
- Baseline-Werte für das Review-Monitoring
- Dashboards mit API-Datenzufuhr
Die Seite Review Analysis API von VOC.AI positioniert die API rund um programmgesteuerten Zugriff auf Review-, Keyword-, Verkaufs- und Listing-Daten über API- und MCP-Oberflächen. Für Teams mit Engineering-Unterstützung ist die Wiederverwendungsrate eine nützliche KI-Review-Analyse-Metrik, weil sie zeigt, ob Review-Analyse zu Infrastruktur wird und nicht nur zu einem monatlichen Export.
Messgröße 10: Verknüpfung mit nachgelagerten Ergebnissen
Die Verknüpfung mit nachgelagerten Ergebnissen fragt, ob akzeptierte Erkenntnisse nach einer Maßnahme mit Geschäfts- oder Produktergebnissen verbunden werden können.
Das bedeutet nicht, so zu tun, als hätte ein einzelner Review-Analyse-Bericht jedes Ergebnis verursacht. Es bedeutet, die Kette zu erhalten:
Review-Belege -> akzeptierte Erkenntnis -> Maßnahme -> gemessenes Ergebnis
Nützliche Ergebnis-Metriken hängen von der Entscheidung ab:
| Entscheidungstyp | Zu beobachtende Ergebniskennzahl |
|---|---|
| Änderung der Produktlistung | Klickrate, Conversion-Rate, Verteilung der Rücksendegründe, Fragenvolumen |
| Produktbehebung | Erwähnungen von Defekten, Ersatzanfragen, Bewertungstrend, Verteilung der Rückerstattungsgründe |
| Support-Update | Kontaktquote, Eskalationsquote, Qualität der ersten Antwort, wiederholte Kontakte |
| Reaktion auf Wettbewerber | Gewinn-/Verlustnotizen, Änderungen am Review-Anteil, Positionierungstests |
| Marktforschung | Akzeptierte Hypothesen, gestartete Tests, Durchlaufzeit des Produktentdeckungszyklus |
Halten Sie die Zuschreibung bescheiden. Das Ziel ist nicht, den ROI zu übertreiben. Das Ziel ist zu wissen, ob die KI-Review-Analyse einen nachvollziehbaren Weg von der Kundensprache zu einer Maßnahme geschaffen hat, die für das Unternehmen wichtig war.
Eine praktische Scorecard für die KI-Review-Analyse
Verwenden Sie diese Scorecard während eines Piloten oder einer monatlichen Überprüfung:
| Scorecard-Zeile | Bestehensbedingung | Aufzubewahrende Nachweise |
|---|---|---|
| Entscheidungssatz | Der Verantwortliche, die Kohorte, die Entscheidung und das Datum sind genannt | Entscheidungsnotiz oder Besprechungsagenda |
| Abdeckungsgrad der Nachweise | Enthaltene Reviews passen zur abgegrenzten Entscheidung | Kohortenregel, Quellenanzahl, Ausschlüsse |
| Nachvollziehbarkeit | Wesentliche Erkenntnisse verweisen auf die Quell-Reviews | Review-IDs, Ausschnitte, Daten, Bewertungen |
| Qualität der Themen | Themen benennen Verhalten, Kontext und Konsequenz | Thementabelle und manueller Stichprobencheck |
| Widersprüche | Gegenbelege und Segmentaufteilungen sind sichtbar | Notizen zu Widersprüchen |
| Schweregrad | Erkenntnisse mit hohem Risiko werden zur Prüfung durch Menschen eskaliert | Schweregrad-Score und Eskalationsverantwortlicher |
| Handlungsfähigkeit | Akzeptierte Erkenntnisse werden zu Tickets, Tests, Warnungen oder Briefings | Aktionsprotokoll |
| Übergabe | Jede Maßnahme hat Verantwortlichen, nächsten Schritt, Status und Prüftermin | Übergabe-Tracker |
| Effizienz | Die eingesparte Zeit wird pro akzeptierter Entscheidung gemessen | Zeitprotokoll manuell vs. KI-unterstützt |
| Wiederverwendung | Ausgaben werden zu wiederverwendbaren Evidenz-Assets | Bibliothek, Taxonomie, Baseline oder API-Job |
| Ergebnis | Die Folgekennzahl wird nach der Maßnahme überprüft | Ergebnisnotiz |
Diese Scorecard ist bewusst operativ ausgelegt. Sie sollte in eine Pilotüberprüfung, ein Produktmeeting, eine Support-Triage, eine wöchentliche Ecommerce-Überprüfung oder eine Forschungssitzung zur Planung passen.
Wie man einen Pilotversuch in 14 Tagen misst
Führen Sie den Pilotversuch gegen eine echte Entscheidung durch, nicht gegen einen generischen Demo-Datensatz. Dieselbe Disziplin der gleichen Evidenz ist nützlich, wenn benachbarte Workflows bewertet werden, wie etwa ein Bewertungsrahmen für KI-Tools zur Produktforschung.
- Definieren Sie den Entscheidungssatz.
- Wählen Sie die Review-Kohorte aus und speichern Sie die Kohortenregeln.
- Führen Sie dieselbe Kohorte durch den Workflow für die KI-Review-Analyse aus.
- Bitten Sie den Verantwortlichen, die wichtigsten Erkenntnisse zu prüfen.
- Bewerten Sie Nachvollziehbarkeit, Themenqualität, den Umgang mit Widersprüchen, Schweregrad und Umsetzbarkeit.
- Konvertieren Sie akzeptierte Erkenntnisse in Tickets, Tests, Alerts, Research-Prompts oder Support-Updates.
- Dokumentieren Sie die von Menschen aufgewendete Zeit vor und nach der KI-Unterstützung.
- Prüfen Sie das erste nachgelagerte Signal, nachdem die Aktion ausgeliefert wurde oder die Untersuchung abgeschlossen ist.
Diese Pilotstruktur ist absichtlich klein gehalten. Sie brauchen kein komplexes Analyseprogramm, um zu lernen, ob KI-Review-Analyse funktioniert. Sie brauchen eine Entscheidung, eine Kohorte, Belege, einen Verantwortlichen und einen Folgetermin.
Wo VOC.AI passt
VOC.AI ist am stärksten, wenn KI-Review-Analyse von Reviewsprache in Produkt-, Listing-, Markt-, Support- oder API-Workflows überführt werden muss.
Verwenden Sie Voice of Customer Analysis, wenn das Team Review-Themen, Käuferbegriffe, Pain Points, Erwartungen und entscheidungsreife Ausgaben aus Evidenz aus Kundenbewertungen benötigt. Verwenden Sie die Review Analysis API, wenn dieselben Signale in ein internes Dashboard, einen Agenten, einen Bericht oder einen wiederkehrenden Workflow einfließen müssen. Verwenden Sie Pricing, wenn das Team zwischen einer Testphase, einem Workflow einer Review-Analytics-Plattform oder einem API/MCP-Abonnementpfad wählt.
Das ist für die Metriken in diesem Leitfaden wichtig. Evidenzabdeckung, Nachvollziehbarkeit, Übergabe, Wiederverwendung und Downstream-Verknüpfung lassen sich leichter steuern, wenn die Review-Analyse nicht in einer einmaligen Zusammenfassung gefangen ist. Der Sinn der KI-Review-Analyse besteht nicht darin, einen schöneren Bericht zu erstellen. Es geht darum, Kundenevidenz so nah am Workflow zu halten, dass Teams darauf reagieren können.
FAQ
Was ist die wichtigste Metrik für die KI-Review-Analyse?
Die Nachvollziehbarkeitsrate ist die erste Metrik, die geprüft werden sollte. Wenn sich wichtige Erkenntnisse nicht auf die zugrunde liegenden Reviews zurückführen lassen, wird es für Teams schwierig, der Analyse zu vertrauen oder die Entscheidung zu vertreten.
Reicht Modellgenauigkeit aus, um KI-Review-Analyse zu bewerten?
Nein. Genauigkeit ist wichtig, aber unvollständig. KI-Review-Analyse braucht außerdem Evidenzabdeckung, Themenspezifität, den Umgang mit Widersprüchen, die Übergabe an den Verantwortlichen und nachgelagerte Maßnahmen.
Wie viele Reviews sollte ich verwenden, um ein KI-Review-Analyse-Tool zu testen?
Verwenden Sie genügend Reviews, um die Entscheidungskohorte abzubilden. Für einen schnellen Benchmark prüfen Sie manuell 30 bis 50 repräsentative Reviews und vergleichen Sie dann die KI-Ausgabe mit den Themen und Belegen, die ein Verantwortlicher als wichtig identifiziert hat.
Sollte der Sentiment-Score eine primäre Metrik sein?
Der Sentiment-Score ist zur Orientierung nützlich, sollte aber nicht die primäre Entscheidungsmetrik sein. Teams müssen in der Regel wissen, was Kunden sagen, warum es wichtig ist, wo die Belege sind und welche Maßnahme folgen sollte.
Wie vermeide ich Vanity-Metriken in der KI-Review-Analyse?
Verknüpfen Sie jede Metrik mit einer Entscheidung. Verarbeitete Reviews, generierte Diagramme und erstellte Themen sind schwache Metriken, solange sie nicht zu nachvollziehbaren Erkenntnissen, akzeptierten Maßnahmen oder wiederverwendbaren Workflow-Artefakten führen.
Wann sollte die KI-Review-Analyse einen API-Workflow verwenden?
Verwenden Sie einen API-Workflow, wenn dieselben Review-Signale wiederholt aktualisiert werden müssen, ein anderes System speisen sollen oder einen Team-Workflow außerhalb eines eigenständigen Dashboards unterstützen sollen. Wenn die Analyse eine einmalige Entscheidung mit einem kleinen Review-Set ist, kann ein manueller Workflow ausreichen.
Fazit
Die KI-Review-Analyse-Metriken, die wirklich zählen, sind diejenigen, die die Entscheidung absichern: Hat das System die richtige Kohorte analysiert, die Belege erhalten, spezifische Themen gefunden, Widersprüche aufgezeigt, die Schwere priorisiert, Erkenntnisse an die Verantwortlichen weitergeleitet, Zeit gespart und Maßnahmen mit Ergebnissen verknüpft?
Beginnen Sie mit der Rückverfolgbarkeitsrate, der Umsetzungsrate und der pro bestätigter Entscheidung eingesparten Zeit. Ergänzen Sie dann im Zuge der Reifung des Workflows die Abdeckung der Belege, die Erhaltung von Widersprüchen, die Vollständigkeit der Übergabe, die Wiederverwendung und die Verknüpfung mit nachgelagerten Ergebnissen.
So wird KI-Review-Analyse zu einem Betriebssystem für Kundennachweise statt zu einem weiteren Dashboard, dem niemand vertraut.