Amazon-Bewertungsanalysen sollten mehr leisten, als nur einen Haufen Kommentare zusammenzufassen. Für Teams, die nach Amazon review analytics: Vergleich und Alternativen suchen, lautet die eigentliche Frage: Welcher Ansatz hilft Ihnen dabei zu entscheiden, was geändert werden sollte, was untersucht werden muss und worauf nicht überreagiert werden sollte?
Deshalb ist die beste Alternative nicht immer das Produkt mit der längsten Funktionsliste. Eine Tabellenkalkulation kann für eine einzelne Einführungsentscheidung ausreichen. Die nativen Tools von Amazon können eine Frage auf Kategorieebene abdecken. Eine spezialisierte Review-Analytics-Plattform kann sinnvoller sein, wenn mehrere Teams reproduzierbare Belege benötigen. Eine API-Pipeline kann gerechtfertigt sein, wenn Review-Intelligence in Ihre eigenen Systeme fließen muss.
Aktualisiert am 11. August 2026 vergleicht dieser Leitfaden sechs Ansätze für Amazon-Bewertungsanalysen anhand der Aufgaben, die sie zuverlässig unterstützen können:
- Manuelles Lesen und Tabellenkalkulationen
- Allzweck-KI-Assistenten
- Amazon-native Review-Einblicke
- Breite Amazon-Seller-Suiten
- Spezialisierte Review-Analytics-Plattformen
- Benutzerdefinierte API-Pipelines
Ziel ist nicht, einen universellen Gewinner zu küren. Es geht darum, Ihnen zu helfen, den kleinsten Ansatz zu wählen, der Ihre Entscheidungsfrage beantworten kann, ohne die Belege zu verdecken. Außerdem erhalten Sie eine Methode, um eine lange Liste auf drei bis fünf Finalisten zu reduzieren, sie mit entscheidungsspezifischen Gewichten zu bewerten, die Reproduzierbarkeit zu benchmarken, die Betriebskosten zu schätzen, native/API-gestützte Optionen zu testen, die Exportierbarkeit zu prüfen, ein Vendor-Demo-Skript durchzugehen und den Gewinner ohne vermeidbaren Lock-in in die Produktion zu überführen.
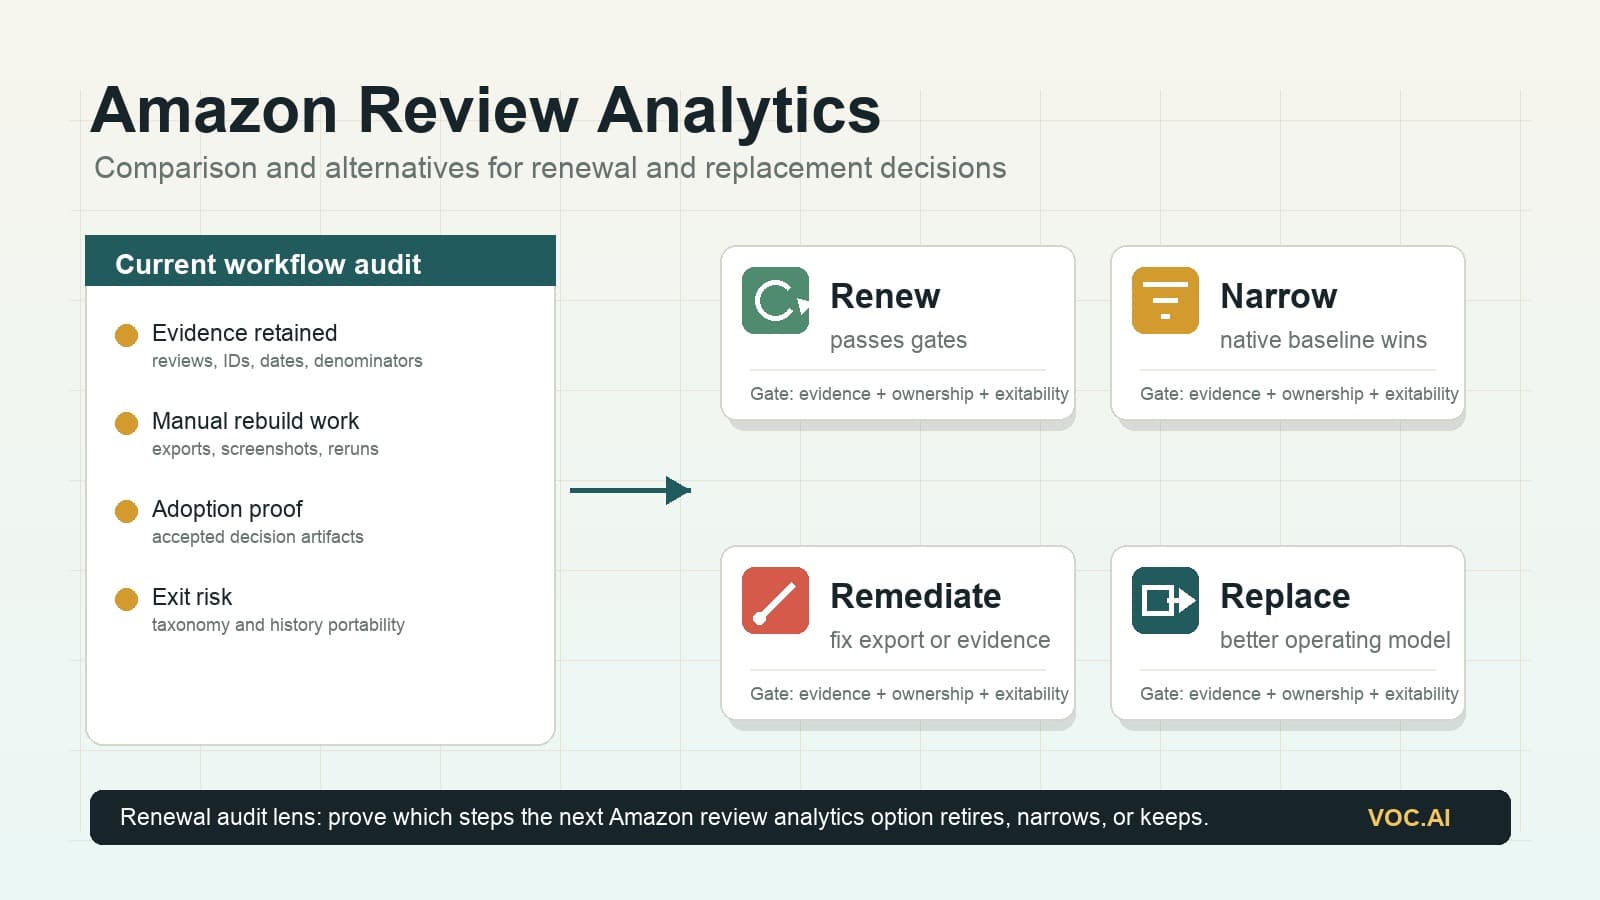
Das Update vom 11. August fügt eine Ebene für Erneuerung und Austausch hinzu: eine praktische Möglichkeit zu entscheiden, ob der aktuelle Workflow beibehalten, auf Amazon-native Abdeckung eingegrenzt, um eine spezialisierte Ebene ergänzt oder durch einen API-gestützten Prozess ersetzt werden soll. Amazon-native und Seller-Suite-Bewertungsanalysen sind zunehmend mit Amazons eigenen Kundenfeedback-Oberflächen und API-Verträgen verknüpft, daher geht es bei der ersten Frage weniger darum, ob ein Tool Themen anzeigen kann, sondern vielmehr darum, ob es den Korpus, die Belege, den Nenner, die Vergleichslogik, die Übergabe und die Migrationsspur bewahren kann, die Ihr Team nach dem Erscheinen der nativen Zusammenfassung benötigt.
Was zuerst vergleichen: Oberfläche, Belege oder Betriebsmodell?
Die meisten Käufer beginnen mit Screenshots der Benutzeroberfläche, weil sich Screenshots leicht vergleichen lassen. Das ist für Amazon-Bewertungsanalysen die falsche erste Ebene. Eine ausgefeilte Oberfläche kann dennoch den Review-Satz verschleiern, unterschiedliche Beschwerden zusammenführen oder Wettbewerbervergleiche mit inkonsistenten Zeitfenstern erstellen.
Verwenden Sie stattdessen diese Reihenfolge.
| Kaufschicht | Welche Frage sie beantwortet | Was geprüft werden sollte | Fehlermodus, wenn übersprungen |
|---|---|---|---|
| Betriebsmodell | Wer verantwortet den Datenzugriff, die Taxonomie, die QA und die wiederkehrende Arbeit? | Native Tool, Suite, Spezialplattform, KI-gestützter Workflow oder API-Pipeline | Das Team kauft ein Tool, das weder zum Rhythmus noch zum Verantwortlichen passt |
| Evidenzschicht | Lässt sich jede wichtige Erkenntnis auf Quellbewertungen und Nennerregeln zurückführen? | Korpusmanifest, Bewertungsausschnitte, Vertrauenshinweise, Gegenbeispiele, Datumsfenster und Filter | Stakeholder stellen die Schlussfolgerungen infrage und Analysten bauen die Arbeit manuell neu auf |
| Entscheidungsschicht | Kann das Ergebnis zu einem echten Aktionsartefakt werden? | Produktbrief, Listing-Brief, Qualitätsbericht, Wettbewerbs-Gap-Tabelle, Alarm, Ticket oder API-Antwort | Das Dashboard ist interessant, verändert aber nicht, was das Team tut |
| Ausstiegsschicht | Kann das Team gehen, ohne Taxonomie, Evidenz oder Historie zu verlieren? | Exporte, Schema, IDs, Versionshistorie und Migrationsprobe | Der gewählte Workflow wird teuer zu ändern, selbst wenn die Qualität nachlässt |
Diese Reihenfolge verändert, wie Sie Alternativen vergleichen. Manuelle Tabellenkalkulationen können ein Tool schlagen, wenn die Entscheidung eng gefasst ist und der Analyst jede Bewertung lesen muss. Eine breite Seller-Suite kann eine Speziallösung schlagen, wenn Keyword- und Listing-Workflows wichtiger sind als tiefgehende Feedback-Evidenz. Eine Speziallösung kann beide schlagen, wenn Review-Intelligence ein wöchentlicher bereichsübergreifender Input ist. Eine API-Pipeline kann die Interface-Kategorie schlagen, wenn das Ziel ein internes System ist.
Marktupdate August 2026: Native Themen getrennt von Entscheidungsevidenz vergleichen
Vergleiche im Bereich Amazon-Review-Analytik trennten früher sauber zwischen „nativen Tools“ und „Third-Party-Seller-Tools“. Diese Grenze ist heute weniger klar. Amazons offizielle Customer Feedback API stellt aggregierte Customer-Feedback-Themen für berechtigte ASIN-Workflows bereit, und die aktuelle Dokumentation zu Review Insights von Helium 10 sagt, dass die Funktion von Amazons Customer Feedback API betrieben wird. Mit anderen Worten: Ein Review-Modul einer Seller-Suite kann heute näher an einer Amazon-nativen Themenebene liegen als an einem vollständig unabhängigen Review-Mining-Workflow.
Das ist nützlich, verändert aber die Bewertung. API-gestützte Themenzusammenfassungen können den Einrichtungsaufwand senken und die Plattformlegitimität verbessern. Sie beantworten jedoch nicht automatisch, ob Ihr Team jede Behauptung prüfen, Wettbewerber mit demselben Nenner vergleichen, die Evidenz exportieren oder Review-Ergebnisse mit einer Produkt-, Listing-, Qualitäts- oder Überwachungsentscheidung verknüpfen kann.
Nutzen Sie diese Trennung, bevor Sie Tools in die engere Auswahl nehmen.
| Ebene | Was sie beweist | Was sie nicht beweist |
|---|---|---|
| Native Themenebene | Amazon hat positive oder negative Themen, Bewertungs-Snippets, Auswirkungsmessungen auf die Bewertung, Trends oder von der API zurückgegebene Themendaten für den berechtigten ASIN-Kontext erkannt | Dass der Workflow Ihre benutzerdefinierte Taxonomie, den Multi-ASIN-Wettbewerber-Denominator, kanalübergreifende Nachweise oder Export-/Audit-Anforderungen unterstützt |
| Seller-Suite-Workflow | Die Bewertungsansicht steht neben Keyword-, Listing-, Produktrecherche- oder Operations-Tools, die Ihr Team möglicherweise bereits nutzt | Dass die Review-Analytics tief genug ist, um ein wiederkehrendes Insights-System zu sein, statt nur ein unterstützendes Modul |
| Spezialisierte Analytics-Ebene | Das System ist auf wiederkehrende Evidenz-Synthese, Nachverfolgbarkeit, Vergleich und Übergabe ausgerichtet | Dass es jede Seller-Suite-Aufgabe ersetzt oder dass es gewinnen sollte, wenn eine native Ansicht bereits eine eng umrissene Frage beantwortet |
| API- oder Warehouse-Ebene | Die Organisation kann Review-Themen oder analysierte Felder in ihre eigenen Systeme einbetten | Dass Engineering-Verantwortung, QA, Evidenzspeicherung und Wartung günstiger sind als der Kauf eines gepflegten Workflows |
Für Amazon Review Analytics: Vergleich und Alternativen gilt praktisch Folgendes: Behandeln Sie „anhand von Amazon-Daten“ nicht als Ausschlusskriterium oder als vollständige Antwort. Behandeln Sie es als eine von mehreren Datenebenen. Der Gewinner muss dennoch den unten beschriebenen Evidence Packet, den Akzeptanztest, das Kostenmodell und die Exitability-Übung bestehen.
Minimum Viable Evidence Packet
Bevor Sie Demos durchführen, definieren Sie das Evidence Packet, das jede Alternative liefern muss. Dieses Packet sollte klein genug sein, um es in einer Arbeitssitzung zu erstellen, und vollständig genug, dass ein Verantwortlicher aus Produkt, Marketing, Qualität oder Operations es hinterfragen kann.
| Packet-Feld | Erforderlicher Standard |
|---|---|
| Corpus-Manifest | ASINs, Marktplatz, Extraktionsdatum, Anzahl der Bewertungen, Datumsfenster, Sterne-Filter, Sprachfilter, Variantenzuordnung und Ausschlüsse |
| Thementabelle | Rangierte Themen mit leicht verständlichen Labels, Mechanismus, Sentiment, betroffenes Produkt oder betroffener Wettbewerber sowie Anzahl oder Anteil mit Nenner |
| Nachweisanhang | Exakte Bewertungs-Auszüge für die wichtigsten Behauptungen, mindestens ein Gegenbeispiel pro Hauptthema, Bewertung, Datum, ASIN, Marktplatz und Quell-ID, falls verfügbar |
| Ansicht zu jüngsten Änderungen | Ein aktueller Zeitraum, verglichen mit einem Basiszeitraum unter Verwendung derselben Taxonomie und eines sichtbaren Nenners |
| Entscheidungsartefakt | Ein konkretes Ergebnis: Listing-Copy-Brief, Produktproblemmemo, Wettbewerber-Lückentabelle, Qualitätsuntersuchung, Monitoring-Alarm oder API-Antwort |
| Unsicherheitsprotokoll | Mehrdeutige Bewertungen, dünne Belege, verdächtige Muster, Taxonomie-Unstimmigkeiten und Behauptungen, die mit Support-, Retouren- oder Verkaufsdaten validiert werden müssen |
| Reproduktionshinweis | Die Einstellungen, der Prompt, die gespeicherte Ansicht, die Anfrage oder die Workflow-Version, die ein anderer Analyst benötigt, um dieselbe Analyse erneut auszuführen |
Wenn eine Alternative dieses Packet nicht erzeugen kann, kann sie für die Exploration dennoch nützlich sein, sollte aber nicht als produktives Review-Analytics-System behandelt werden.
Beschaffungspaket August 2026: Was vor dem Shortlist-Meeting gesammelt werden sollte
Die meisten Vergleiche von Amazon-Bewertungsanalysen enden bei einer Funktionstabelle. Das reicht für eine kommerzielle Prüfung nicht aus. Ein Käufer braucht ein Paket, das Produkt-, E-Commerce-, Forschungs-, Betriebs-, Engineering- und Sicherheitsverantwortlichen ermöglicht, dieselben Belege zu prüfen, bevor ein Finalist weiterkommt.
Erstellen Sie das Paket vor dem Shortlist-Meeting, nicht erst nachdem der Einkauf emotional bereits einen Gewinner ausgewählt hat.
| Paketabschnitt | Was enthalten sein sollte | Warum das den Vergleich verändert |
|---|---|---|
| Entscheidungsfrage | Eine Entscheidung, die der Workflow unterstützen muss, etwa ein Produktproblem-Memo, ein Listing-Sprachbriefing, ein Bericht über Wettbewerberlücken oder ein Monitoring-Alert | Verhindert, dass Anbieter die Demo um generische Dashboards herum optimieren |
| Produktumfang | Fokussierte ASINs, Wettbewerber-ASINs, Marktplatz, Sprache, Zeitfenster, Behandlung von Child-Variationen und Ziel für die Anzahl der Bewertungen | Macht Abdeckungslücken sichtbar, bevor der Proof beginnt |
| Belegregel | Exakter Bewertungstext, Quell-ID falls verfügbar, ASIN, Bewertung, Datum, Marktplatz, Filter, Nenner und Erwartungen an Gegenbeispiele | Trennt Analysen von nicht nachvollziehbaren Zusammenfassungen |
| Native Basis | Welche Amazon-nativen Bewertungs-Einblicke oder Daten zu Customer-Feedback-API-Themen bereits für denselben Produktumfang vorhanden sind | Verhindert, dass das Team für einen Workflow bezahlt, der nur eine vorhandene Basis neu verpackt |
| Shortlist-Begründung | Warum jeder Finalist im Vergleich bleibt: native, Seller-Suite, Spezialplattform, KI-gestützter Workflow oder API-Pipeline | Hält die Shortlist über Betriebsmodelle hinweg ausgewogen statt fünf ähnlicher Dashboards |
| Demo-Artefakte | Screenshots sind erlaubt, aber jeder Finalist muss außerdem einen Export, ein Briefing, eine Tabelle, einen Alert, ein Ticket oder ein API-Beispiel bereitstellen, das außerhalb des Calls geprüft werden kann | Testet, ob der Workflow auch außerhalb der Oberfläche funktioniert |
| Stakeholder-Notizen | Einwände von Produkt, Listing, Qualität, Support, Forschung, Engineering und Sicherheit mit Verantwortlichem und Follow-up-Status | Macht den Kaufprozess funktionsübergreifend, ohne ihn in vagen Konsens zu verwandeln |
| Gate-Ergebnis | Bestanden, bedingt bestanden oder nicht bestanden für Abdeckung, Nachvollziehbarkeit, Vergleichslogik, Trendlogik, Workflow-Ausgabe, Governance, Kosten und Ausstiegsfähigkeit | Verhindert, dass eine hohe Gesamtpunktzahl eine disqualifizierende Schwäche verdeckt |
Das Paket sollte kurz genug sein, um in einem Meeting geprüft zu werden. Wenn es einen Tag dauert, es zu erklären, ist der Vergleich noch immer zu abstrakt.
Nutzen Sie eine Agenda für die Stakeholder-Prüfung
Führen Sie das Shortlist-Meeting mit einer festen Agenda durch:
- Bestätigen Sie die Entscheidungsfrage. Wenn sich Stakeholder über die Entscheidung uneinig sind, pausieren Sie den Toolvergleich.
- Prüfen Sie die native Basislinie. Identifizieren Sie, welche Fragen Amazon-native Themen, Snippets, Trends oder von der API zurückgegebene Themadaten bereits beantworten.
- Überprüfen Sie das Evidenzpaket. Öffnen Sie mindestens drei Quellbewertungen hinter den wichtigsten Behauptungen und ein Gegenbeispiel.
- Hinterfragen Sie den Vergleich. Fragen Sie, ob Fokus- und Wettbewerbsprodukte denselben Nenner, dasselbe Zeitfenster und dieselbe Taxonomie verwenden.
- Prüfen Sie das Ausgabe-Artefakt. Entscheiden Sie, ob ein nicht-analytischer Verantwortlicher darauf handeln könnte, ohne die Arbeit neu aufzubauen.
- Prüfen Sie die operative Zuständigkeit. Benennen Sie, wer Taxonomie, QA, Exporte, Warnungen, Integrationen, Berechtigungen und erneute Läufe pflegt.
- Definieren Sie die Nachweis-Gates. Legen Sie fest, welcher Fehler den Finalisten während des 14-tägigen Nachweises eliminieren würde.
Diese Agenda ist bewusst praxisnah. Sie lenkt das Gespräch weg von „welches Tool ist das beste?“ hin zu „welches Betriebsmodell kann ein belastbares Entscheidungsartefakt für unser Produktportfolio erzeugen?“
Stakeholder-spezifische Fragen hinzufügen
Verschiedene Stakeholder sollten unterschiedliche Teile des Amazon-Review-Analytics-Workflows hinterfragen.
| Stakeholder | Zu stellende Frage | Nachweise, die sie zufriedenstellen sollten |
|---|---|---|
| Produktmanager | Welches Thema verändert die Roadmap, und welche Bewertungen belegen den Mechanismus? | Themen-Tabelle mit exakten Bewertungsnachweisen, Gegenbeispielen, Konfidenz und einer handlungsreifen Empfehlung |
| E-Commerce- oder Listing-Verantwortlicher | Welche Käuferformulierungen sollten Titel, Bullet Points, Bilder oder A+-Inhalte beeinflussen? | Wortgetreue Phrase-Cluster mit Bewertung, Datum, ASIN, Marketplace und Entscheidungsnotizen |
| Qualitäts- oder Operations-Verantwortlicher | Steht das Problem mit Produktdesign, Verpackung, Fulfillment, Erwartungen oder Nutzung in Zusammenhang? | Segmentierte Beschwerdemechanismen, Ansicht der jüngsten Änderungen, Variantenkontext und offene Validierungsfragen |
| Research- oder Insights-Leiter | Bewahrt die Taxonomie die Bedeutung über Produkte und Zeit hinweg? | Codebuch, menschlich codierte Referenzstichprobe, Abweichungsprotokoll und Wiederholbarkeitsresultat |
| Engineering- oder Data-Verantwortlicher | Können die Daten ohne Verlust von Evidenz in interne Systeme überführt werden? | Export-Schema, API-Beispiel, IDs, Zeitstempel, Versionierung, Limits und Fehlerverhalten |
| Security- oder Compliance-Prüfer | Sind Zugriff, Aufbewahrung, Berechtigungen, Audit-Historie und Praktiken zum Umgang mit Bewertungen akzeptabel? | Herstellerdokumentation, Rollenkontrollen, Löschverhalten, Hinweise zum Datenfluss und Richtlinienausnahmen |
| Finance- oder Operations-Einkäufer | Reduziert der Workflow wiederholte Arbeit genug, um die Kosten zu rechtfertigen? | Jährliches Betriebskostenmodell, Schätzung des Einrichtungsaufwands, QA-Schätzung und Kosten pro akzeptiertem Entscheidungsartefakt |
Wenn ein Finalist eine Stakeholder-Frage nicht beantworten kann, markieren Sie die Lücke präzise. Ein fehlendes API-Feld, ein unklarer Marketplace-Umfang oder ein nicht exportierbarer Evidenz-Anhang ist leichter zu beheben als die vage Sorge, dass das Tool unvollständig wirkt.
August 2026 renewal audit: entscheiden, ob behalten, eingrenzen, hinzufügen oder ersetzen
Viele Teams kommen nicht mit einem leeren Blatt zur Amazon-Bewertungsanalyse: Vergleich und Alternativen. Sie haben bereits eine Tabelle, ein Modul der Seller-Suite, einen nativen Amazon-Workflow, einen Review-Zusammenfasser oder eine halb fertige interne Pipeline. Die schwierigere Frage ist nicht „Welches Tool sollen wir kaufen?“, sondern „Haben wir genügend Belege, um den aktuellen Workflow zu erneuern, oder sollten wir einen Teil davon ersetzen?“
Führen Sie 30 bis 45 Tage vor Vertragsverlängerung, der jährlichen Planung oder einer größeren Produktlinienprüfung ein Verlängerungs-Audit durch. Das Audit sollte denselben Belegstandard verwenden wie ein Neukauf, aber es sollte auch die historische Kontinuität prüfen: Welche Taxonomien, Verknüpfungen zwischen Quellen und Bewertungen, Exporte, Dashboards, Warnmeldungen und Entscheidungen würden erhalten bleiben, wenn sich der Workflow ändert?
| Ergebnis des Verlängerungs-Audits | Darauf weist die Entscheidung hin | Was vor dem Handeln zu prüfen ist |
|---|---|---|
| Native Amazon-Themen beantworten die zentrale Produktfrage, und Stakeholder nutzen tiefere Ausgaben nur selten | Den Workflow auf Amazon-native Review-Erkenntnisse oder API-gestützte Themen verengen | Berechtigung, Marktplatzabdeckung, Aktualität der Themen, Exportanforderungen und ob die native Ansicht weiterhin genügend Entscheidungsbelege liefert |
| Die Review-Analytik der Seller-Suite ist nur nützlich, wenn sie mit Keyword-, Listing- oder Produktrecherche-Workflows kombiniert wird | Als unterstützendes Modul beibehalten, nicht als führendes System | Ob Review-Belege weiterhin außerhalb der Suite exportiert, zitiert und verglichen werden können |
| Analysten erstellen nach jeder Dashboard-Prüfung Beleganhänge manuell neu | Eine spezialisierte Review-Intelligence-Schicht hinzufügen oder den Beleg-Workflow neu gestalten | Themennachverfolgbarkeit, IDs auf Review-Ebene, Export-Schema, gespeicherte Ansichten und Übergabezeit an den Verantwortlichen |
| Produkt-, Qualitäts- und Listing-Teams verwenden für dieselben Bewertungen unterschiedliche Taxonomien | Taxonomie und QA konsolidieren, bevor Tools erweitert werden | Verantwortung für das Codebook, Protokolle von Meinungsverschiedenheiten, Label-Versionierung und Mapping von alten zu neuen Labels |
| Interne Teams benötigen Bewertungsdaten in BI, Tickets, Warnmeldungen oder proprietären Modellen | Spezifischen API-Zugriff mit einer Custom Pipeline vergleichen | API-Felder, Rate Limits, Anforderungsverlauf, Belegspeicherung, Schema-Versionierung und technische Verantwortung |
| Die Kosten steigen, aber die akzeptierten Entscheidungsartefakte bleiben unverändert | Neu verhandeln, den Umfang eingrenzen oder ersetzen | Lizenz-/API-Kosten, Analystenstunden, QA-Zeit, Engineering-Zeit, überwachte ASINs und pro Monat akzeptierte Deliverables |
Das Verlängerungs-Audit verhindert einen häufigen Fehler: ein Tool zu verlängern, weil es weiterhin attraktive Dashboards erzeugt, während der eigentliche Entscheidungs-Workflow längst woanders stattfindet. Wenn die Belege nicht mehr genutzt werden, ist der Workflow nicht bloß zu wenig angenommen. Er ist nicht länger das richtige Betriebsmodell.
Verwenden Sie ein Beleg-Ledger für den aktuellen Zustand
Bevor Sie Ersatzoptionen vergleichen, inventarisieren Sie, was der aktuelle Workflow bereits leistet. Verwenden Sie eine Zeile pro wiederkehrender Entscheidung, nicht eine Zeile pro Funktion.
| Ledger-Feld | Was erfasst werden soll |
|---|---|
| Entscheidung | Produktüberarbeitung, Listing-Überarbeitung, Wettbewerbslücke, Qualitätsuntersuchung, Monitoring-Alarm oder Executive Readout |
| Aktueller Input | Native Themenansicht, Review-Export, Seller Suite, Spezialisten-Dashboard, API-Antwort, Tabellenkalkulation oder KI-gestützte Analyse |
| Beibehaltener Nachweis | Review-Auszüge, Quell-IDs, Daten, ASINs, Marktplatz, Nenner, Gegenbeispiele und gespeicherte Filter |
| Beibehaltener Output | Brief, CSV, Ticket, Dashboard, Alarm, API-Payload, Codebuch oder Präsentation |
| Nacharbeitsaufwand | Manuelle Bereinigung, Zusammenstellung von Screenshots, erneute Prompt-Durchläufe, Abgleich in Tabellenkalkulationen, Stakeholder-Erklärung oder Engineering-Fix |
| Nachweis der Nutzung | Wer den Output verwendet hat, welche Entscheidung geändert wurde und ob das Entscheidungsartefakt ohne Nacharbeit akzeptiert wurde |
| Ersetzungsrisiko | Daten, die nicht exportiert werden können, Taxonomiehistorie, die verloren gehen könnte, Integrationen, die nachbearbeitet werden müssen, oder erforderliche Rechts-/Sicherheitsprüfung |
Dieses Ledger gibt Prüfern der Erneuerung eine bessere Vergleichsbasis als die Vertragskosten allein. Ein günstiger Workflow, der für jede wichtige Entscheidung zwei Tage manuelle Rekonstruktion erfordert, kann mehr kosten als ein höherpreisiges System, das Nachweise, Verantwortlichkeiten und Wiederholbarkeit bewahrt.
Bewerten Sie den aktuellen Workflow anhand derselben Gates wie neue Finalisten
Geben Sie dem Bestandsanbieter keinen Freifahrtschein. Bewerten Sie ihn anhand derselben Mindestanforderungen, die Sie auf eine neue Amazon-Review-Analytics-Alternative anwenden würden:
- Kann das Team genau sehen, welche Reviews, ASINs, Marktplätze, Daten, Filter und Varianten analysiert wurden?
- Kann jedes wichtige Thema auf die ursprüngliche Kundensprache und mindestens ein Gegenbeispiel zurückgeführt werden?
- Kann dieselbe Taxonomie ein Fokusprodukt, einen Wettbewerber und einen aktuellen Zeitraum ohne versteckte Änderungen am Nenner vergleichen?
- Kann ein Nicht-Analyst als Verantwortlicher den Output nutzen, ohne die Arbeit neu aufzubauen?
- Können Nachweise, Taxonomie und Entscheidungshistorie vor der Erneuerung exportiert werden?
- Kann ein wiederholter Lauf Änderungen erklären, die durch neue Reviews, Konfigurationsänderungen oder Modelländerungen verursacht wurden?
- Kann der Workflow seinen Wert durch akzeptierte Produkt-, Listing-, Qualitäts- oder Monitoring-Artefakte belegen?
Wenn der Bestandsanbieter ein nicht verhandelbares Gate nicht besteht, sollte die Erneuerungsentscheidung zu einem kontrollierten Ersatz oder einem Remediationsplan werden. Wenn er die Gates besteht, aber zusätzliche ungenutzte Module mitbringt, kann der richtige Schritt eher eine Einschränkung des Umfangs als ein Anbieterwechsel sein.
Definieren Sie Ersatz-Auslöser im Voraus
Der Ersatz sollte nicht davon abhängen, wer im Erneuerungstermin am frustriertesten ist. Definieren Sie die Auslöser vor dem Audit:
| Auslöser | Warum es wichtig ist | Beispielschwelle |
|---|---|---|
| Verlust von Nachweisen | Stakeholder können dem Befund nicht vertrauen oder ihn nicht erneut prüfen | Mehr als 10 % der hochpriorisierten Aussagen verfügen nicht über Nachweise aus der Quellenprüfung oder Kontext zum Nenner |
| Neuerstellung des Workflows | Das Tool erzeugt Ergebnisse, die wiederholt manuell neu zusammengestellt werden müssen | Mehr als ein Arbeitstag pro Monat wird damit verbracht, Beweisanhänge aus Screenshots, Exporten oder erneuten Läufen zusammenzustellen |
| Abweichung beim Umfang | Der aktuelle Workflow passt nicht mehr dazu, wo das Unternehmen konkurriert | Erforderliche Marktplätze, Wettbewerber, Sprachen, Varianten oder Produktlinien fehlen in der wiederkehrenden Analyse |
| Einführungsversagen | Das Tool wird beobachtet, aber nicht für Entscheidungen genutzt | Weniger als zwei akzeptierte Entscheidungsartefakte pro Quartal für einen wiederkehrenden Review-Workflow |
| Governance-Lücke | Zugriff, Aufbewahrung, Exporte, API-Handling oder Prüfverlauf passen nicht zur Richtlinie | Security-, Rechts- oder Dateneigentümer können den Live-Workflow nicht ohne Ausnahmen genehmigen |
| Ausstiegsrisiko | Ein Wechsel würde Taxonomie, Nachweise oder historische Kontinuität verlieren lassen | Vor der Verlängerung gibt es keinen nutzbaren Export von Nachweisen, Codebook, Entscheidungsverlauf oder Integrationszuordnungen |
Diese Schwellenwerte sind Beispiele, keine universellen Standards. Ziel ist es, das Verlängerungsgespräch von einer Präferenz hin zu beobachteter Arbeit zu verlagern.
Zwischen vier Verlängerungsergebnissen entscheiden
Am Ende des Audits wählen Sie eines von vier Ergebnissen:
- Unverändert verlängern. Verwenden Sie dies nur, wenn der Workflow die Prüfungen für Nachweise, Output, Nutzung, Governance, Kosten und Ausstiegsfähigkeit besteht.
- Mit engerem Umfang verlängern. Behalten Sie das Tool für die Aufgaben, die es tatsächlich unterstützt, und entfernen Sie überhöhte Erwartungen aus dem Betriebsmodell.
- Mit Behebung verlängern. Behalten Sie den Workflow nur, wenn bestimmte Lücken bis zu einem genannten Datum behoben werden, etwa das Exportschema, der Anhang mit Nachweisen, Taxonomie-Kontrollen oder die Übergabe an Stakeholder.
- Ersetzen oder neu aufbauen. Starten Sie einen Nachweis für einen Ersatz, wenn das bestehende System den aktuellen Entscheidungs-Workflow nicht unterstützen kann, den Nachweisverlauf nicht exportieren kann oder mehr kostet, als seine akzeptierten Entscheidungsartefakte rechtfertigen.
Hier werden Vergleiche von Amazon-Review-Analytics ehrlicher. Ein natives Tool kann nach einem spezialisierten Pilotprojekt die richtige Antwort sein. Eine Seller-Suite kann als unterstützendes Modul im Stack bleiben. Eine spezialisierte Plattform kann zum System of Record werden. Eine API-Pipeline kann gewinnen, wenn Nachweise in proprietäre Systeme fließen müssen. Das Verlängerungsaudit zwingt dazu, dass die Entscheidung der Arbeit folgt.
Amazon-Review-Analytics: Vergleich und Alternativen nach Betriebsmodell
Für die Arbeit mit Amazon-Review-Analytics: Vergleich und Alternativen ist das Betriebsmodell wichtig, weil jede Option die Verantwortung auf ein anderes Team verlagert.
| Ansatz | Am besten geeignet für | Hauptstärke | Hauptlimitation | Wählen Sie ihn, wenn |
|---|---|---|---|---|
| Manuelles Lesen und Tabellenkalkulationen | Einmalige Analyse eines kleinen Review-Sets | Maximale Kontrolle darüber, was codiert wird | Langsam, schwer zu wiederholen, anfällig für Abweichungen zwischen Analysten | Sie haben eine eng umrissene Frage und können die Quell-Reviews selbst prüfen |
| Allzweck-KI-Assistent | Schnelle Exploration und Erstellung einer ersten Taxonomie | Flexibles Prompting und schnelle Synthese | Datenerhebung, Nachvollziehbarkeit und Wiederholbarkeit hängen von Ihrem Prozess ab | Sie verfügen bereits über einen rechtmäßig erhobenen Review-Datensatz und benötigen eine erste Analyse |
| Amazon-native Review-Einblicke | Produkt- oder Nischenfragen innerhalb von Seller Central | Nativer Kontext und geringer Einrichtungsaufwand | Zugriff, Umfang, Exporte und Workflow-Flexibilität passen möglicherweise nicht zu jedem Team | Ihre Entscheidung spielt sich hauptsächlich innerhalb von Amazon ab und die native Abdeckung ist ausreichend |
| Breite Amazon-Seller-Suite | Teams, die auch Keyword-, Listing-, Werbe- oder Produktrecherche-Tools benötigen | Mehrere Seller-Workflows in einem Abonnement | Review-Analyse kann ein Modul statt des Kernbereichs des Systems sein | Konsolidierung ist wichtiger als ein tiefes Workflow-Design für die Review-Analyse |
| Spezialisierte Plattform | Wiederholbare Review-Intelligence über Produkte und Wettbewerber hinweg | Tiefere Themenanalyse, Evidenzabruf, Vergleich und Monitoring | Fügt dem Stack ein dediziertes System hinzu | Die Review-Sprache treibt wiederkehrende Produkt-, Listing-, Support- oder Rechercheentscheidungen an |
| Benutzerdefinierte API-Pipeline | Workflows mit hohem Volumen oder eingebettete Workflows | Kontrolle über Datenmodelle, Automatisierung und interne Integrationen | Aufwand für Engineering, Governance, QA und Wartung | Review-Intelligence muss proprietäre Dashboards, Modelle oder operative Prozesse speisen |
Eine spezialisierte Plattform und eine benutzerdefinierte API-Pipeline werden oft gemeinsam bewertet, lösen aber unterschiedliche Ownership-Probleme. Die eine kauft einen gepflegten Workflow, die andere baut einen.
Beginnen Sie mit der Entscheidung, nicht mit dem Dashboard
Bevor Sie Tools vergleichen, schreiben Sie einen Satz, der die Entscheidung definiert.
Zum Beispiel:
- Welche wiederkehrenden Beschwerden sollten unsere nächste Produktüberarbeitung beeinflussen?
- Welche Käuferformulierungen sollten unseren Listing-Text beeinflussen?
- Ist ein plötzlicher Bewertungsrückgang mit Verpackung, Qualität, Erwartungen oder Fulfillment verknüpft?
- Welche Schwäche des Wettbewerbers tritt oft genug auf, um sie zu untersuchen?
- Welche Review-Themen nehmen nach einer Lieferanten- oder Verpackungsänderung zu?
Das ist wichtig, weil „Reviews analysieren“ keine brauchbare Anforderung ist. Unterschiedliche Entscheidungen erfordern unterschiedliche Abdeckung, Zeitfenster, Vergleichsgruppen und Evidenzstandards.
Ein Projekt für Listing-Texte benötigt exakte Formulierungen und Nutzungsszenarien. Eine Qualitätsuntersuchung braucht Daten, Varianten, Chargen und Trendänderungen. Ein Beschaffungsprojekt benötigt Abdeckung von Wettbewerbern und Kategorien. Ein wöchentliches Monitoring-Workflow benötigt Alarme, Zuständigkeiten und Termine für Nachprüfungen.
Wenn das Tool die Verknüpfung zwischen einem Thema und den dahinterliegenden Reviews nicht bewahren kann, ist das Ergebnis ein Hinweis – kein Beleg.
Die 10 Kriterien, die nützliche Analytik von polierten Zusammenfassungen unterscheiden
Verwenden Sie diese Kriterien, um Amazon-Review-Analytics-Alternativen zu vergleichen.
1. Abdeckung der Bewertungen
Fragen Sie, was die Analyse tatsächlich umfasst:
- eine ASIN oder ein Portfolio?
- Ihre Produkte, Wettbewerber oder Sets auf Kategorieebene?
- Welche Marktplätze und Sprachen?
- Welcher Datumsbereich?
- Parent-Listings, Child-Varianten oder beides?
- Alle verfügbaren Bewertungen oder eine begrenzte Auswahl?
Die Abdeckung verändert das Ergebnis. Ein nativer oder API-gestützter Themen-Feed kann eine starke Basis sein, wenn er zu Ihrer ASIN, Ihrem Marktplatz, Ihrer Sprache und den Berechtigungsbedingungen passt. Es bleibt dennoch eine andere Evidenzbasis als eine benutzerdefinierte Vollkorpus- oder Multi-ASIN-Analyse, wenn der Workflow nicht denselben Nenner, dieselben Filter, dasselbe Zeitfenster und dieselben Ausschlüsse zeigen kann, die Ihre Entscheidung erfordert.
Die richtige Frage lautet nicht „Analysiert es Bewertungen?“ Sondern: „Welche Bewertungen bestimmen die Antwort?“
2. Qualität der Themen
Eine einfache Sentimentanalyse teilt Feedback in positiv, neutral und negativ ein. Nützliche Analytics sollten auch erkennen, worum es beim Sentiment geht.
Achten Sie auf Themen wie:
- Haltbarkeit
- Passform oder Größen
- Aufbau-/Einrichtungsaufwand
- Transportschäden
- Fehlendes Zubehör
- Akkulaufzeit
- Materialgefühl
- Abweichung von der Erwartung
- Anwendungsfall oder Käufertyp
Themenlabels sollten spezifisch genug sein, um Maßnahmen zuzuordnen. „Negatives Produktfeedback“ hat keinen Verantwortlichen. „Deckel reißt nach wiederholten Spülmaschinengängen“ kann an Produkt- und Qualitätsteams weitergeleitet werden.
3. Wörtliche Belege
Ein starkes System ermöglicht es, von einem Diagramm zu den relevanten Review-Ausschnitten zu wechseln. Das hilft Teams dabei:
- zu prüfen, ob das Label zur Sprache passt
- Kontext zu sehen, den eine Zusammenfassung ausgeblendet hat
- die Formulierungen zu erkennen, die Kunden natürlich verwenden
- Ausnahmen und Gegenbeispiele zu finden
- generierte Formulierungen nicht als Kundenzitat darzustellen
Das Abrufen von Belegen ist einer der klarsten Unterschiede zwischen Review Analytics und generischer Textzusammenfassung.
4. Vergleichslogik
Die Analyse von Wettbewerberbewertungen sollte Äpfel mit Äpfeln vergleichen. Prüfen Sie, ob Sie Folgendes steuern können:
- Produktsatz
- Zeitfenster
- Sternebereich
- Variante oder Modell
- Marktplatz
- Themendefinition
- Unterschiede im Bewertungsvolumen
Ein Wettbewerber kann schlicht mehr Beschwerden haben, weil er mehr Bewertungen hat. Ein neueres Produkt kann besser aussehen, weil weniger langfristige Haltbarkeitsprobleme Zeit hatten, sichtbar zu werden. Zählwerte ohne Nenner können in die Irre führen.
5. Zeitliche Trends
Eine Themenzählung über alle Zeiträume kann das Ereignis verbergen, das Sie sehen müssen. Achten Sie auf die Möglichkeit, Zeiträume zu vergleichen und Veränderungen nach folgenden Ereignissen zu erkennen:
- einem Lieferantenwechsel
- einer Verpackungsänderung
- einer Überarbeitung des Listings
- einer Preisänderung
- einem saisonalen Nachfragesprung
- einem Produktupdate
Amazon beschreibt Customer Review Insights so, dass es positive und negative Themen, den Einfluss von Themen auf Sternebewertungen, Review-Ausschnitte und sechsmonatige Trendthemen im Product Opportunity Explorer anzeigt. Diese native Ansicht kann für einige Produkt- und Nischenfragen ausreichend sein.
6. Filter und Segmentierung
Nützliche Filter hängen von der Entscheidung ab, aber gängige sind Bewertung, Datum, Produkt, Wettbewerber, Variante, Marktplatz, Sprache und Thema.
Behandeln Sie ein filterreiches Dashboard nicht automatisch als rigoros. Filter sind nur dann nützlich, wenn der zugrunde liegende Abdeckungsumfang klar ist und die resultierenden Belege überprüft werden können.
7. Workflow-Ergebnisse
Das Ergebnis sollte zur nächsten Aktion passen. Beispiele sind:
- ein Input für Produktanforderungen
- ein Briefing zur Listungssprache
- ein Bericht über Verpackungsprobleme
- ein Update der Support-FAQ
- eine Tabelle zu Wettbewerber-Lücken
- ein Monitoring-Alarm
- ein wöchentliches Entscheidungs-Memo
Wenn der Workflow mit „interessantes Dashboard“ endet, muss das Team die Analyse vor dem Handeln dennoch neu aufbauen.
8. Wiederholbarkeit
Kann eine andere Person dieselbe Analyse nächste Woche erneut ausführen und verstehen, was sich geändert hat?
Wiederholbarkeit erfordert mehr als gespeicherte Prompts. Dazu können eine stabile Taxonomie, ein benanntes Produktset, ein Datumsfenster, Filter, eine Analyseversion, Belege-Links und exportierbare Ergebnisse gehören.
Hier benötigen manuelle Analysen und allgemeine KI-Assistenten oft zusätzliches Prozessdesign. Sie können leistungsstark sein, aber das Team verantwortet die Methode.
9. Integration und Export
Überlegen Sie, wohin die Erkenntnisse gelangen müssen:
- CSV oder Tabellenkalkulation
- Produktmanagementsystem
- Business-Intelligence-Dashboard
- Datenlager
- Support-Plattform
- Internes Forschungs-Repository
- Automatisierter Alerting-Workflow
Die Customer Feedback API von Amazon kann autorisierten Anwendungen positive und negative Review-Themen für eine ASIN zurückgeben. VOC AI beschreibt außerdem eine Review Analysis API für Original-Review-Felder und von KI analysierte Ergebnisdaten. Eine API wird relevant, wenn der Zielort genauso wichtig ist wie die Analyseoberfläche.
10. Governance und Compliance
Review-Analysen sollten Ihnen helfen, aus Kundenfeedback zu lernen, nicht es zu manipulieren.
Die FTC Consumer Reviews and Testimonials Rule behandelt Praktiken wie gefälschte Bewertungen, von Sentiment abhängige Anreize, nicht offengelegte Insider-Bewertungen und die Unterdrückung von Bewertungen. Die Regel trat am 21. Oktober 2024 in Kraft.
Ihre Bewertung sollte Datenzugriff, Aufbewahrung, Benutzerberechtigungen, Exporte, Nachvollziehbarkeit und die Trennung generierter Zusammenfassungen von der ursprünglichen Kundensprache abdecken. Sie sollte außerdem bestätigen, dass die Erfassung von Bewertungen und die weitere Nutzung den geltenden Plattformbedingungen und internen Richtlinien entsprechen.
Führen Sie vor dem Vergleich von Funktionslisten einen Reproduzierbarkeits-Benchmark durch
Funktions-Checklisten sagen Ihnen, was ein Produkt angeblich tun kann. Ein Reproduzierbarkeits-Benchmark prüft, ob der Ansatz eine stabile, überprüfbare Antwort liefern kann, wenn Eingabe, Fragestellung und Regeln gleich bleiben.
Das ist wichtig, weil Amazon-Review-Analysen oft mehrere variable Schritte kombinieren: Korpusauswahl, Deduplizierung, Sprachverarbeitung, Themenzuordnung, Sentiment-Klassifizierung, Nennerwahl, Vergleichslogik und generierte Erklärungen. Zwei ansprechende Dashboards können aus denselben Reviews zu unterschiedlichen Schlussfolgerungen gelangen. Die nützliche Frage ist nicht, ob sie sich unterscheiden. Sie lautet, ob Sie die Abweichung finden und erklären können.
Erstellen Sie vor Anbieter-Demos oder Testphasen ein Benchmark-Paket. Verwenden Sie dasselbe Paket für manuelle Analysen, native Tools, Seller-Suites, spezialisierte Plattformen und API-basierte Workflows.
Stellen Sie ein festes Testpaket zusammen
Wählen Sie ein fokales Produkset, das normale Bewertungen und schwierige Fälle umfasst:
- Ein fokales ASIN mit ausreichender Bewertungsvergangenheit, um wiederkehrende Themen zu zeigen
- Ein enger Wettbewerber mit einem ähnlichen Anwendungsfall
- Ein Produkt mit Varianten, Bundles oder bedeutenden Konfigurationsunterschieden
- Ein fester Marktplatz und ein fester Datumsbereich
- Bewertungen mit gemischter Stimmung, Sarkasmus, bedingtem Lob und mehreren Problemen
- Bewertungen, die Verpackung, Fulfillment, Erwartungen und Produktleistung im selben Text erwähnen
- Mindestens fünf Bewertungen, die ein menschlicher Analyst als mehrdeutig einstuft
Dokumentieren Sie die ASINs, den Marktplatz, das Extraktionsdatum, die Anzahl der Bewertungen, den Datumsbereich, die Filter und alle Ausschlüsse. Wenn ein Workflow den analysierten Korpus oder seinen Nenner nicht offenlegen kann, markieren Sie dies vor der Prüfung der Ergebnisse als Messungsbeschränkung.
Bei API-gestützten Optionen bewahren Sie das Anfrage- und Antwortschema zusammen mit dem Ergebnis auf. Amazon stellt ein öffentliches Customer Feedback API model bereit, das ein nützliches Beispiel für die versionierten Verträge darstellt, die technische Käufer prüfen sollten.
Stellen Sie jeder Option dieselben fünf Fragen
Lassen Sie nicht zu, dass jede Demo die Frage auswählt, die ihre Oberfläche am besten erscheinen lässt. Verlangen Sie von allen Finalisten, dass sie dieselbe Fragenliste beantworten:
- Was sind die drei wichtigsten wiederkehrenden Beschwerdemechanismen für das fokale ASIN?
- Welche Beschwerde hat sich im jüngsten Zeitraum im Vergleich zum Basiszeitraum am stärksten verändert?
- Welches Thema unterscheidet das fokale ASIN am klarsten vom Wettbewerber?
- Welcher Befund ist am unsichersten, und welche Evidenz würde diese Unsicherheit verringern?
- Welche einzelne Produkt-, Listing- oder Monitoring-Maßnahme sollte ein Eigentümer als Nächstes ergreifen?
Die Fragen testen bewusst unterschiedliche Fähigkeiten. Die erste prüft Abdeckung und Taxonomie. Die zweite prüft Nenner und Zeitfenster. Die dritte prüft die Vergleichslogik. Die vierte prüft Sicherheit und Gegenbeweise. Die fünfte prüft, ob die Ausgabe die Grenze von der Analyse zu einem Entscheidungsworkflow überschreiten kann.
Erstellen Sie einen menschlich codierten Referenzsatz
Wählen Sie 30 bis 50 Bewertungen aus dem Testpaket aus und lassen Sie zwei Personen sie unabhängig voneinander codieren. Verwenden Sie ein kompaktes Schema:
| Feld | Beispielregel |
|---|---|
| Primäres Thema | Das wichtigste Kundenergebnis oder der Problemmechanismus |
| Sekundäres Thema | Ein deutlich zusätzliches Problem, kein Synonym des primären Themas |
| Stimmung | Positiv, negativ, gemischt oder auf Themenebene unklar |
| Mechanismus | Was das gelobte oder kritisierte Ergebnis verursacht hat |
| Evidenzspanne | Die genauen Wörter, die den Code stützen |
| Vertrauen | Hoch, mittel oder niedrig mit kurzer Begründung |
| Kontext | Variante, Nutzungsszenario, Verpackung, Fulfillment oder Erwartung, sofern verfügbar |
Lösen Sie Meinungsverschiedenheiten und bewahren Sie sowohl die ursprünglichen Codes als auch das adjudizierte Ergebnis auf. Dies ist keine perfekte Ground Truth. Es ist eine transparente Referenz, die aufzeigt, wie jeder Ansatz bekannte Randfälle behandelt.
Wenn Ihr Team einen breiteren Beschaffungsrahmen benötigt, verwenden Sie diesen Benchmark zusammen mit einer Scorecard für Customer-Review-Analyse-Tools, statt die Beurteilung durch eine einzelne Genauigkeitszahl zu ersetzen.
Score-Übereinstimmung, Stabilität und Nachvollziehbarkeit getrennt bewerten
Eine einzelne „Accuracy“-Kennzahl verdeckt wichtige Fehlerarten. Bewerten Sie mindestens diese vier Dimensionen auf einer Skala von 0 bis 2:
| Benchmark-Dimension | 0 | 1 | 2 |
|---|---|---|---|
| Themenübereinstimmung | Wichtige manuell kodierte Themen werden übersehen oder erheblich verzerrt | Wesentliche Themen erscheinen, aber Grenzen oder Mechanismen sind inkonsistent | Wesentliche Themen und Mechanismen stimmen gut genug überein, um die Entscheidung zu unterstützen |
| Stabilität von Lauf zu Lauf | Das Wiederholen desselben Tests führt ohne Erklärung zu erheblich unterschiedlichen Prioritäten | Die Prioritäten sind ähnlich, aber Bezeichnungen, Zählungen oder Belege verschieben sich | Wiederholte Durchläufe erhalten die Schlussfolgerung oder erklären klar die durch die Version bedingte Änderung |
| Nachvollziehbarkeit der Belege | Ergebnisse können nicht auf einzelne Bewertungen oder freigegebene Quellverweise zurückgeführt werden | Einige Beispiele sind sichtbar, aber der Nenner oder der vollständige Belegsatz ist unklar | Jeder wichtige Befund verfügt über abrufbare Belege, Korpuskontext und Berechnungsgrundlage |
| Diagnose von Abweichungen | Das Team kann nicht lokalisieren, warum das Ergebnis von der Referenz abweicht | Unterschiede können durch manuelle Rekonstruktion gefunden werden | Der Workflow legt Filter, Taxonomie, Konfidenz, Ausnahmen und betroffene Belege offen |
Führen Sie denselben Benchmark zweimal aus, ohne das Korpus oder die Anweisungen zu ändern. Wenn sich die Ausgabe ändert, fragen Sie, ob der Unterschied von einer Modellversion, einer Taxonomieänderung, einer Korpusaktualisierung, einer zufälligen Generierung, einem versteckten Filter oder einer Berechnungsregel herrührt. Eine stabile falsche Antwort ist nicht gut, aber eine instabile Antwort, die sich nicht erklären lässt, ist schwer zu steuern.
Führen Sie ein Abweichungsprotokoll
Dokumentieren Sie bei jeder wesentlichen Abweichung:
- Die Aussage oder das gerankte Thema, das sich geändert hat
- Die betroffenen Bewertungen oder Datensätze
- Ob der Unterschied ein Problem mit Abdeckung, Kodierung, Sentiment, Nenner, Aktualität oder Erklärung ist
- Ob ein menschlicher Prüfer ihn korrigieren kann
- Ob die Korrektur beim nächsten Lauf bestehen bleibt
- Ob die Abweichung die empfohlene Maßnahme ändert
Dieses Protokoll ist nützlicher als das Sammeln einzelner Screenshots. Es zeigt, ob sich der Workflow durch Taxonomieänderungen, Ausschlüsse, Prompt-Anpassungen, Datenkorrekturen oder Produktkonfiguration verbessert – und ob diese Verbesserungen über die Sitzung eines einzelnen Analysten hinaus Bestand haben.
Definieren Sie eine Passbedingung, die an die Entscheidung gekoppelt ist
Verlangen Sie nicht, dass jedes Themenlabel Wort für Wort übereinstimmt. Verlangen Sie, dass der Ansatz die entscheidungsrelevante Bedeutung erhält.
Zum Beispiel können „Deckel reißt beim Versand“ und „versandbedingte Beschädigung des Deckels“ akzeptable Varianten sein, wenn beide auf dieselben Belege und denselben Verantwortlichen verweisen. „Schlechte Qualität“ ist kein akzeptabler Ersatz, wenn dadurch Deckelschäden, Batterieausfälle und Größenbeschwerden in eine vage Kategorie zusammengefasst werden.
Ein Finalist besteht, wenn er Folgendes kann:
- Die wichtigsten entscheidungsrelevanten Themen reproduzieren
- Wichtige Unterschiede zum Referenzsatz erklären
- Quellnachweise und Nenner beibehalten
- Eine stabile Prioritätsreihenfolge über wiederholte Durchläufe hinweg erzeugen
- Das Ergebnis ohne versteckte Rekonstruktionsarbeit in das erforderliche Deliverable überführen
Dieser Benchmark beseitigt nicht die Notwendigkeit eines Produktionspiloten. Er macht den Pilotversuch diagnostischer. Sie gehen mit dem 14-tägigen Proof of Concept in die Phase, wissend, welche Edge Cases, Kontrollen und Evidenzlücken Aufmerksamkeit erfordern.
Alternative 1: manuelles Lesen von Bewertungen und Tabellenkalkulationen
Manuelle Analyse ist nicht obsolet. Sie ist oft der beste Ausgangspunkt, wenn die Entscheidung eng begrenzt ist und der Bewertungsumfang überschaubar bleibt.
Wann es funktioniert
- Sie bewerten eine kleine Anzahl von Produkten
- Sie müssen die Fachsprache der Kategorie lernen, bevor Sie automatisieren
- Die Entscheidung ist von großer Tragweite und erfordert sorgfältiges Lesen
- Sie möchten eine erste Taxonomie erstellen
- Die Analyse ist gelegentlich statt wiederkehrend
Wo es scheitert
- Die Codierung ändert sich, während der Analyst dazulernt
- Duplikate von Themen und inkonsistente Bezeichnungen häufen sich an
- Die Nachverfolgbarkeit der Bewertungen wird mühsam
- Der Vergleich von Zeiträumen oder Wettbewerbern erfordert wiederholte Bereinigung
- Die Arbeitsmappe wird für andere Teams schwer wiederverwendbar
Ein praktisches manuelles Setup verwendet eine Zeile pro Bewertung, unveränderliche Quellfelder, separate von Analysten codierte Felder und ein Codebook, das jedes Thema definiert. Bewahren Sie Kundenzitate getrennt von Zusammenfassungen auf.
Alternative 2: ein allgemeiner KI-Assistent
Ein allgemeiner KI-Assistent kann den von Ihnen bereitgestellten Bewertungstext schnell klassifizieren, zusammenfassen und explorieren. Er ist eine nützliche Alternative, wenn Ihr Team den Datensatz bereits kontrolliert und bereit ist, die Methode zu verantworten.
Wann es funktioniert
- Sie benötigen eine schnelle Erst-Taxonomie
- Die Analyse ist explorativ
- Ein Mensch wird die Evidenz prüfen
- Sie können Chunking, Prompts und Ausgaben verwalten
- Sie benötigen kein dauerhaft laufendes Überwachungssystem
Wo es scheitert
- Eingabelimits können die Analyse fragmentieren
- Das Modell kann unterschiedliche Mechanismen zu breiten Themen zusammenführen
- Ergebnisse können sich mit Prompts oder Modellversionen ändern
- Zitate auf Quellzeilen erfordern eine bewusste Implementierung
- Datenerfassung und Plattformzugang bleiben separate Probleme
Verwenden Sie strukturierte Ausgabefelder wie theme, mechanism, sentiment, evidence_id, product, date und confidence. Prüfen Sie dann eine Stichprobe der Klassifizierungen, bevor Sie die Ergebnisse für eine Produkt- oder Marketingentscheidung verwenden.
Alternative 3: Amazon-native Einblicke in Bewertungen
Amazon's Customer Review Insights ist in Product Opportunity Explorer in Seller Central integriert. Amazon sagt, dass es häufige positive und negative Themen gruppiert, Ausschnitte anzeigt, darstellt, wie Themen die Sternebewertungen beeinflussen, und Themen-Trends darstellt.
Wann es funktioniert
- Die Fragestellung konzentriert sich auf Amazon-Produkte oder -Nischen
- Ihr Team arbeitet bereits in Seller Central
- Native Themen- und Trendansichten beantworten die Entscheidung
- Sie möchten geringen Einrichtungsaufwand
Woran Sie die Eignung prüfen
- Berechtigung und Verfügbarkeit im Marktplatz
- Exakte Produkt- und Nischenabdeckung
- Export- und Integrationsanforderungen
- Historische Tiefe
- Anforderungen an eine benutzerdefinierte Taxonomie
- Bedarf an kanalübergreifendem oder nicht auf Amazon bezogenem Feedback
Native Tools sind eine starke Grundlage. Vergleichen Sie kostenpflichtige Alternativen mit der nativen Antwort, die Sie bereits erhalten können, nicht mit einer leeren Tabelle.
Alternative 4: eine umfassende Amazon-Verkäufer-Suite
Seller Suites kombinieren mehrere Aufgaben wie Produktrecherche, Keyword-Analyse, Listing-Workflows, Werbung und operative Abläufe. Review-Analyse kann als eine Funktion enthalten sein.
Die Nuance im August 2026 ist, dass sich einige Review-Funktionen in Seller Suites inzwischen um Amazons offizielle Kundendaten herum positionieren und nicht nur um exportierten Review-Text. Das kann ein bedeutender Vorteil für Teams sein, die ein Signal in der Nähe von Seller Central möchten, ohne einen API-Workflow aufzubauen. Es bedeutet auch, dass Sie prüfen sollten, ob die Funktion hauptsächlich eine native Themenansicht, ein Workflow zur Review-Text-Analyse oder ein tieferes System für Entscheidungsnachweise ist.
Wann es funktioniert
- Dieselben Nutzer benötigen mehrere Seller-Workflows
- Die Konsolidierung von Tools reduziert operative Reibung
- Die Review-Analyse unterstützt die Aufgabe, definiert sie aber nicht
- Eine konsistente Suite ist wertvoller als maximale Tiefe in einem einzelnen Modul
- Die Amazon-native Themenabdeckung reicht für die Fragestellung aus und die Suite übernimmt bereits den umliegenden Workflow
Worauf Sie beim Fit achten sollten
- Ob die Funktion Amazon-native Themendaten, Export von Review-Texten, proprietäre Analyse oder eine Mischung davon verwendet
- Der genaue ASIN-, Marktplatz-, Sprach- und Berechtigungsumfang
- Wettbewerber- und Multi-ASIN-Vergleich
- Review-Exporte
- Anpassung von Themen
- Nachvollziehbarkeit der Belege
- Monitoring und Warnmeldungen
- Ob die benötigte Funktion im relevanten Plan enthalten ist
Vergleichen Sie Suite-Preise nicht allein anhand der Review-Funktion. Vergleichen Sie die gesamte Menge an Aufgaben, die Ihr Team tatsächlich nutzen wird.
Alternative 5: eine spezialisierte Review-Analytics-Plattform
Eine spezialisierte Plattform ist sinnvoll, wenn Kundensprache ein wiederkehrender operativer Input ist und nicht nur eine gelegentliche Rechercheaufgabe.
Wann es funktioniert
- Mehrere Teams nutzen Review-Nachweise
- Sie vergleichen wiederholt Produkte, Wettbewerber oder Kategorien
- Themenkonsistenz ist über die Zeit wichtig
- Die exakte Kundensprache fließt in Listings und Produktentscheidungen ein
- Monitoring und wiederverwendbare Berichte sind Teil des Workflows
Die VOC-Analyse von VOC AI ist ein Beispiel für diesen Ansatz. Sie ist darauf ausgelegt, Feedback nach Schmerzpunkt, Erwartung und Funktionsnennung zu clustern, wiederkehrende Beschwerden mit Produkt- und Listing-Entscheidungen zu verknüpfen und Review-Intelligenz über Dashboards, Agenten-Workflows und API-Zugriff hinweg zu nutzen.
Die Kaufentscheidung lautet nicht, ob ein Spezialist mehr Diagramme erstellen kann. Entscheidend ist, ob er die wiederholte Arbeit zwischen Quell-Review, abgesicherter Schlussfolgerung, Verantwortlichem und nächster Maßnahme reduziert.
Alternative 6: eine benutzerdefinierte API-Pipeline
Eine benutzerdefinierte Pipeline ist die Alternative mit der höchsten Kontrolle und die am leichtesten zu unterschätzende.
Wann es funktioniert
- Review-Intelligence muss in ein internes Produkt eingebettet sein
- Sie benötigen eine proprietäre Taxonomie oder ein Scoring-Modell
- Große Produktsets erfordern eine geplante Verarbeitung
- Ausgaben müssen mit Verkaufs-, Retouren-, Support- oder Qualitätsdaten verknüpft werden
- Engineering- und Data-Governance-Verantwortliche stehen zur Verfügung
Was Sie verantworten
- Rechtskonformer Datenzugriff
- Schema und Identitätsauflösung
- Duplikatbereinigung und Sprachverarbeitung
- Modellauswahl und Bewertung
- Versionierung von Themen
- Speicherung von Nachweisen
- Berechtigungen und Aufbewahrung
- Überwachung und Wartung
Der Vergleich zwischen Eigenentwicklung und Kauf sollte laufende QA und Verantwortlichkeiten einschließen, nicht nur den ersten Prototyp.
Namentlich genannte Amazon-Review-Analytics-Tools und Alternativen
Die oben genannten Kategorien sind hilfreicher als eine generische Liste der „Top-Tools“, da mehrere Produkte, die in den Suchergebnissen zusammen erscheinen, unterschiedliche Aufgaben lösen. Dennoch brauchen Käufer Namen für eine praktische Shortlist.
Verwenden Sie die folgende Übersicht als Ausgangspunkt, nicht als endgültiges Ranking. Produktzugang, Marktplatzabdeckung, Exporte und Verpackung können sich ändern. Prüfen Sie den aktuellen Workflow mit dem Anbieter und testen Sie jeden Finalisten mit demselben ASIN-Set.
| Option | Betriebsmodell | Bestes Einstiegsanwendungsfall | Was vor der Eingrenzung zu prüfen ist |
|---|---|---|---|
| Amazon Customer Review Insights | Amazon-native Analyse innerhalb des Product Opportunity Explorer | Aufbau einer nativen Basis für Themen, Snippets, Bewertungseffekte und Trends | Kontoberechtigung, Marktplatz- und Nischenabdeckung, Exportoptionen, historische Tiefe und ob die native Taxonomie Ihre Entscheidung beantwortet |
| Amazon Customer Feedback API | Amazon-API-Eingabe für einen kontrollierten Workflow | Einbindung berechtigter Kundenfeedback-Themen in internes Reporting oder Anwendungen | Verfügbare Endpunkte und Datenumfang, wöchentliches Aktualisierungsverhalten, Sprach- und Marktplatzbeschränkungen, Autorisierung, Aufbewahrungsregeln, technische Verantwortung, nachgelagerte Evidenzspeicherung und laufende Wartung |
| Helium 10 Review Insights | Funktion der Seller-Suite, die Daten der Amazon Customer Feedback API nutzt | Kombination von Amazon-Feedback-Themen mit anderen Seller-Recherchen und Listing-Workflows | Welche Tarife und Marktplätze den benötigten Workflow enthalten, ob API-Themendaten für Ihre Entscheidung ausreichen, Exporttiefe, benutzerdefinierte Vergleichssteuerung und ob Themen mit der Quell-Evidenz verknüpft bleiben |
| SellerSprite Review Analysis | Amazon-Recherche-Suite mit Review-Analyse-Workflows | Wettbewerbs- und Produktbewertung innerhalb eines Seller-Research-Stacks | ASIN- und Marktplatzabdeckung, Vergleichssteuerung, Datumsfilter, Exporte, Taxonomie-Verhalten und wie die Ausgabe in den bestehenden Rechercheprozess des Teams passt |
| ReviewMeta | Prüfung der Review-Authentizität | Überprüfen, ob ein Review-Korpus vor einer tieferen Auswertung verdächtige Muster enthalten könnte | Ob die Ausgabe Authentizitätsprüfung statt Produkt-Themenanalyse adressiert, die verwendete Methodik und wie die bereinigte Ansicht die Entscheidung beeinflussen wird |
| Allzweck-KI-Assistent | Flexible Analyseschicht über einem Datensatz, den Sie bereits kontrollieren | Schnelles Erstellen einer Taxonomie, Extrahieren von Evidenz oder Testen einer eng gefassten Frage | Rechtmäßiger Datenzugriff, Eingabelimits, Reproduzierbarkeit, Prompt- und Modellversionierung, Zitate auf Review-Ebene sowie menschliche Prüfverfahren |
| VOC AI Voice of Customer Analysis | Spezialisierte Plattform für Review- und Feedback-Intelligence | Wiederkehrende Analysen über Produkte, Wettbewerber, Teams oder Feedback-Kanäle hinweg | Quellenabdeckung, Rückverfolgbarkeit der Evidenz, Taxonomie-Steuerung, Monitoring, Zusammenarbeit, Exporte, API-Tauglichkeit und die genaue Übergabe von der Erkenntnis zur Entscheidung |
Diese Tabelle ist absichtlich kein eins-bis-sieben-Ranking. Amazon-native Erkenntnisse können die beste Antwort auf eine eng gefasste Frage in Seller Central sein. ReviewMeta kann als Echtheitsprüfung nützlich sein, ist aber kein Ersatz für die Themenanalyse. Eine Seller-Suite kann gewinnen, wenn Konsolidierung wichtig ist. Ein Spezialisten- oder API-Workflow wird relevanter, wenn dieselbe Evidenz wiederkehrende Entscheidungen zu Produkt, Marketing, Recherche und Betrieb stützen muss.
Die wichtige Anpassung für 2026 besteht darin, dieselbe native Kennzahl nicht doppelt zu zählen. Wenn sowohl ein Modul einer Seller-Suite als auch ein direkter API-Workflow aus Amazons Customer Feedback API ziehen, vergleichen Sie sie anhand von Workflow, Exporten, Steuerungsmöglichkeiten und operativer Verantwortung — nicht auf Basis der Annahme, dass sie zwei völlig unterschiedliche zugrunde liegende Datensätze offenlegen.
Für eine Erneuerungs- oder Austauschentscheidung fügen Sie Ihrer internen Kopie dieser Tabelle noch eine Spalte hinzu: Was würde diese Option ersetzen? Wenn die Antwort „nichts“ lautet, fügen Sie möglicherweise nur eine weitere Review-Oberfläche hinzu, statt Arbeit zu ersetzen. Eine neue Alternative für Amazon Review Analytics sollte manuelle Beweiszusammenstellung, inkonsistente Taxonomien, screenshotbasierte Berichte, langsame Exportbereinigung oder ein Dashboard ersetzen, das niemand für eine Entscheidung nutzt.
Vergleichen Sie benannte Tools mit einem gemeinsamen Testpaket
Erstellen Sie vor den Demos mit den Anbietern ein Testpaket:
- Ein fokussierter ASIN: das Produkt, bei dem eine echte Entscheidung ansteht.
- Zwei Vergleichs-ASINs: ein enger Wettbewerber und eine deutlich andere Alternative.
- Ein festes Zeitfenster: zum Beispiel die letzten 90 oder 180 Tage plus eine Referenzansicht für den Gesamtzeitraum.
- Fünf bekannte Bewertungen: Beispiele, die Ihr Team bereits codiert hat, einschließlich mehrdeutiger oder gemischt-positiver/-negativer Kommentare.
- Ein erforderliches Ergebnis: ein Listing-Brief, ein Memo zu Produktproblemen, ein Bericht zu Launch-Risiken oder ein Wettbewerbsvergleich.
- Eine Evidenzregel: Jede wichtige Behauptung muss auf den exakten Bewertungstext verweisen und ASIN, Datum, Bewertung und Marktplatzkontext beibehalten.
Bitten Sie dann jeden Finalisten, dieselben Fragen zu beantworten:
- Was hat sich kürzlich geändert, statt nur dauerhaft häufig aufzutreten?
- Welche Beschwerdemechanismen unterscheiden den fokussierten ASIN von den beiden Alternativen?
- Welche Schlussfolgerung wird schwächer, wenn doppelte, vage oder verdächtige Bewertungen entfernt werden?
- Welche Quellbewertungen stützen die drei wichtigsten Erkenntnisse?
- Welches Entscheidungsartefakt kann exportiert und an eine verantwortliche Person übergeben werden?
Dadurch wird ein Feature-Vergleich zu einem kontrollierten Workflow-Vergleich.
Wählen Sie eine Alternative nach der Einschränkung aus
Wenn Ihre Shortlist immer noch zu breit ist, beginnen Sie mit der Einschränkung, die am schwersten zu ändern ist.
| Harte Einschränkung | Standardoption, die zuerst getestet werden sollte | Warum |
|---|---|---|
| Kein Budget und nur eine eng umrissene Entscheidung | Manuelles Coding oder eine kontrollierte KI-gestützte Tabelle | Hält den Workflow klein und bewahrt gleichzeitig den direkten Zugang zu den Belegen |
| Seller Central steht im Zentrum der Aufgabe | Amazon-native Insights | Prüft, ob die eigene Sicht der Plattform die Frage bereits mit minimalem Setup beantwortet |
| Das Team möchte eine einzige Seller-Suite | Breite Seller-Suite | Bündelt mehrere Workflows, wenn Review Analytics nur ein Teil der Aufgabe ist; prüfen Sie, ob die Review-Ebene nativ/API-basiert oder eine tiefere Beleganalyse ist |
| Review-Belege werden wöchentlich von mehreren Teams genutzt | Spezialisierte Review-Analytics-Plattform | Priorisiert Wiederholbarkeit, gemeinsame Taxonomie, Nachvollziehbarkeit, Monitoring und wiederverwendbare Ergebnisse |
| Review-Intelligence muss in einem internen Produkt leben | Customer Feedback API oder eine andere verwaltete API-Pipeline | Bietet Kontrolle über Schemas, Integrationen, Berechtigungen und proprietäre Entscheidungslogik |
| Vertrauen in das Review-Korpus ist das unmittelbare Anliegen | Authentizitätsprüfungs-Tool vor der Themenanalyse | Trennt die Frage „Können wir diesem Korpus vertrauen?“ von „Was erleben Kunden?“ |
| Das Team muss Reviews mit Support, Rücksendungen, Umfragen oder Social Feedback kombinieren | Cross-Channel-Voice-of-Customer-Plattform oder warehouse-gestützte Pipeline | Verhindert, dass die Entscheidung auf eine einzige, selbst ausgewählte Feedbackquelle beschränkt bleibt |
Die Standardoption ist nur ein erster Test. Eine harte Einschränkung grenzt das Feld ein; der Nachweis auf demselben ASIN bestimmt den Gewinner.
Den Markt auf drei bis fünf Finalisten reduzieren
Ein Vergleich wird weniger nützlich, wenn jedes mögliche Produkt in der Tabelle bleibt. Ziel des ersten Durchgangs ist nicht, einen Gewinner auszuwählen. Es geht darum, Ansätze zu entfernen, die die erforderliche Entscheidung nicht unterstützen können.
In einer Shortlist für Amazon Review Analytics: Vergleich und Alternativen mischt die stärkste Auswahl normalerweise Betriebsmodelle, statt mehrere Tools zu sammeln, die dieselbe Aufgabe lösen.
Beginnen Sie mit sechs unverzichtbaren Filtern:
- Abdeckung: Der Ansatz kann die erforderlichen ASINs, Marktplätze, Sprachen, den Datumsbereich und Varianten analysieren.
- Belege: Wichtige Themen können bis zum exakten Review-Text zurückverfolgt werden.
- Vergleich: Produkte können mit demselben Zeitfenster, Nenner und derselben Taxonomie verglichen werden.
- Workflow: Die Ausgabe kann den Verantwortlichen erreichen, der darauf reagieren muss.
- Governance: Datenzugriff, Aufbewahrung, Berechtigungen und der Umgang mit Reviews entsprechen Ihrer Richtlinie.
- Operative Passung: Ihr Team kann den Workflow nach dem Pilotbetrieb betreiben, prüfen und pflegen.
Schließen Sie jede Option aus, die eine echte unverzichtbare Anforderung nicht erfüllt. Lassen Sie eine starke Demo, einen niedrigen Einführungspreis oder eine lange Funktionsliste nicht eine fehlende Anforderung ausgleichen.
Ihre Shortlist sollte normalerweise verschiedene Betriebsmodelle enthalten, nicht fünf nahezu identische Anbieter. Ein nützlicher Finalisten-Satz mit drei bis fünf Optionen könnte Folgendes umfassen:
- Amazon-native Bewertungseinblicke als Basis
- Eine umfassende Seller-Suite, wenn Konsolidierung wichtig ist
- Eine oder zwei spezialisierte Plattformen für Bewertungsanalysen
- Ein allgemeiner KI-Workflow, wenn das Team den Datensatz bereits kontrolliert
- Ein individueller API-Pfad, wenn die Analyse eingebettet werden muss
Eine Basislinie einzubeziehen verhindert, dass ein kostenpflichtiges Produkt allein deshalb gewinnt, weil es ausgefeilter wirkt als gar nichts zu tun. Das Einbeziehen einer glaubwürdigen Build- oder manuellen Alternative macht außerdem sichtbar, welcher Teil des bezahlten Workflows den Wert schafft.
Verwenden Sie eine gewichtete Scorecard für Amazon-Bewertungsanalysen
Eine gleichmäßige Gewichtung verschleiert die Entscheidung. Ein Listing-Team, ein Qualitätsteam, eine Forschungsgruppe und ein Data-Platform-Team sollten nicht dieselbe Punktzahl erhalten.
Für die Beschaffung von Amazon Review Analytics: Comparison and Alternatives sollten Sie die Gewichte vor den Demos festlegen, damit die ausgefeilteste Oberfläche die Anforderungen nicht neu definiert.
Verwenden Sie für jedes Kriterium eine Bewertung von 0 bis 5:
- 0: nicht vorhanden oder unbrauchbar
- 1: nur mit hohem manuellem Aufwand möglich
- 2: teilweise unterstützt, mit wichtigen Lücken
- 3: ausreichend für den Piloten
- 4: stark und reproduzierbar
- 5: im genauen Workflow nachgewiesen
Wenden Sie dann Gewichte an, die zusammen 100 % ergeben. Die gewichtete Punktzahl lautet:
Gewichtete Punktzahl = Summe aus (Kriterienbewertung / 5 × Kriteriumsgewicht)
Hier ist ein praktisches Startmodell für einen wiederkehrenden E-Commerce-Workflow:
| Kriterium | Gewicht | Was für eine Punktzahl von 5 erforderlich ist |
|---|---|---|
| Abdeckung von Bewertungen und Marktplätzen | 15 % | Erforderliche Produkte, Varianten, Sprachen, Daten und Vergleichssets sind verfügbar und dokumentiert |
| Qualität der Themen und Kontrolle der Taxonomie | 15 % | Themen sind kohärent, bearbeitbar oder verständlich, stabil genug für Vergleiche und auf Ihre Fachsprache getestet |
| Wörtliche Belege und Auditierbarkeit | 15 % | Nutzer können unterstützende und widersprüchliche Bewertungstexte prüfen, ohne die Analyse neu aufzubauen |
| Vergleichs- und Trendlogik | 10 % | Produkte und Zeiträume verwenden konsistente Nenner, Fenster und Bezeichnungen |
| Workflow-Ergebnisse | 10 % | Ergebnisse werden mit wenig Umformatierung zu Briefings, Berichten, Warnungen, Tickets oder Belegpaketen |
| Demo-Steuerbarkeit | 5 % | Das Team kann während der Bewertung dieselbe Aufgabe, denselben ASIN-Satz, dieselben Filter, dieselbe Ausgabe und dieselben Belegregeln erzwingen |
| Reproduzierbarkeit und Zusammenarbeit | 10 % | Ein weiterer qualifizierter Nutzer kann den Workflow erneut ausführen und das Entscheidungsartefakt reproduzieren |
| Integration und Export | 10 % | Benötigte Exporte, API-Zugriff und Systemverbindungen sind im erforderlichen Plan und Umfang verfügbar |
| Governance und Sicherheit | 5 % | Zugriff, Aufbewahrung, Berechtigungen, Verarbeitung und Löschanforderungen sind dokumentiert und akzeptabel |
| Gesamte Betriebskosten | 5 % | Abonnement-, Nutzungs-, Arbeits-, QA-, Implementierungs- und Wartungskosten sind sichtbar |
Behandeln Sie die Gesamtpunktzahl nicht als automatische Kaufentscheidung. Setzen Sie Mindestschwellen für kritische Kriterien. Ein Produkt, das insgesamt 88 Punkte erzielt, aber bei der Nachvollziehbarkeit der Belege nur 1 Punkt erreicht, sollte beispielsweise bei einer evidenzsensiblen Produktentscheidung nicht gewinnen.
Gewichten Sie nach Aufgabe unterschiedlich
Passen Sie die Scorecard an, bevor Sie die Ergebnisse der Anbieter sehen.
- Listing-Optimierung: erhöhen Sie wörtliche Belege, Sprachabdeckung und Workflow-Ausgaben.
- Qualitätsüberwachung: erhöhen Sie Zeittrends, Variantenfilter, Warnmeldungen und Prüfbarkeit.
- Wettbewerbsanalyse: erhöhen Sie den Vergleich mehrerer ASINs, die Klarheit der Abdeckung und die Konsistenz der Taxonomie.
- Produktstrategie: erhöhen Sie die Qualität der Themen, die Zusammenarbeit und Verknüpfungen zu angrenzenden Kundennachweisen.
- Eingebettete Analytik: erhöhen Sie API-Zugriff, Zuverlässigkeit, Sicherheit, Observability und die Verantwortung für Wartung.
Wenn Sie die Gewichtungen zuerst festlegen, verringert sich die Wahrscheinlichkeit, dass die beeindruckendste Demo die Anforderungen im Nachhinein bestimmt.
Verwenden Sie ein kontrolliertes Demo-Skript für die Finalisten
Die meisten Amazon-Review-Analytics-Demos sind darauf ausgelegt, den stärksten Weg des Produkts zu zeigen. Das ist normal, kann aber dazu führen, dass Alternativen unterschiedlicher oder vollständiger wirken, als sie wirklich sind. Ein kontrolliertes Demo-Skript zwingt jeden Finalisten, dieselbe Arbeit unter denselben Bedingungen zu erledigen.
Verwenden Sie dieses Skript nach den ersten Screening-Filtern und vor dem 14-tägigen Nachweis. Der Zweck besteht nicht darin, den Einkauf in einem einzigen Meeting abzuschließen. Es soll aufdecken, ob jeder Finalist innerhalb Ihres Belegstandards ohne Sonderbehandlung arbeiten kann.
| Demo-Block | Was der Finalist tun soll | Was protokolliert werden soll |
|---|---|---|
| Corpus-Bestätigung | Zeigen Sie die analysierten ASINs, den Marktplatz, den Datumsbereich, die Anzahl der Bewertungen, Filter und Ausschlüsse | Ob der Nenner sichtbar ist und ob das Team später denselben Korpus reproduzieren kann |
| Themenextraktion | Identifizieren Sie die wichtigsten Beschwerdemechanismen und die wichtigsten positiven Differenzierungsmerkmale | Ob die Labels spezifisch genug sind, um sie an Produkt, Listing, Support oder Qualitätsverantwortliche weiterzuleiten |
| Evidenz-Drilldown | Öffnen Sie die Quellbewertungen hinter drei wichtigen Aussagen und einem Gegenbeispiel | Ob exakter Bewertungstext, Sternebewertung, Datum, ASIN, Marktplatz und Kontext erhalten bleiben |
| Ansicht der jüngsten Veränderungen | Vergleichen Sie einen jüngeren Zeitraum mit einem Basiszeitraum | Ob Trendänderungen konsistente Zeitfenster und Nenner verwenden |
| Wettbewerbsvergleich | Vergleichen Sie die fokale ASIN mit zwei Alternativen unter Verwendung derselben Taxonomie | Ob der Workflow nach Bewertungsvolumen und Produktunterschieden normalisiert |
| Umgang mit Unklarheiten | Klassifizieren Sie fünf gemischte oder mehrdeutige Bewertungen aus dem Referenzsatz | Ob Unsicherheit sichtbar bleibt oder in überkonfidente Labels umgewandelt wird |
| Übergabe der Ergebnisse | Exportieren oder erzeugen Sie das erforderliche Artefakt: Kurzbericht, Tabelle, Alarm, Ticket, Dashboard oder API-Antwort | Ob das Ergebnis außerhalb der Demo-Oberfläche nutzbar ist |
| Administration und Governance | Zeigen Sie Rollen, Aufbewahrungseinstellungen, Exportkontrollen, Prüfhistorie sowie API- oder Integrationsdokumentation | Ob der Workflow einer Sicherheitsprüfung und der operativen Verantwortung standhält |
Geben Sie dem Anbieter oder dem internen Build-Team das Skript vor der Demo. Ein Finalist sollte nicht dafür bestraft werden, dass er eine angemessene Konfigurationszeit benötigt, aber er sollte dafür bestraft werden, wenn er den Korpus, die Evidenz, den Nenner, die Ausgabe oder die Kontrollen, die die Entscheidung erfordert, nicht zeigen kann.
Erstellen Sie für jeden Finalisten ein eigenes Abnahme-Paket
Lassen Sie die Bewertung nicht als Notizen in einer Beschaffungs-Tabellkalkulation stehen. Erstellen Sie für jeden Finalisten ein kleines Abnahme-Paket:
| Paketbestandteil | Erforderlicher Inhalt |
|---|---|
| Input-Manifest | ASINs, Marktplatz, Extraktionsdatum, Datumsbereich, Filter, Bewertungsanzahl, Ausschlüsse und Methode des Datenzugriffs |
| Ausgabe-Artefakt | Das genaue Deliverable, das das Unternehmen verwenden würde, nicht nur eine Demo-Zusammenfassung als Screenshot |
| Evidenz-Anhang | Quellbewertungen hinter den wichtigsten Aussagen, Gegenbeispiele und mindestens fünf geprüfte Randfälle |
| Scorecard | Gewichtete Bewertungen, Ergebnisse der Mindest-Gates und Gründe für niedrige Scores |
| Abweichungsprotokoll | Materielle Unterschiede zum menschlich codierten Referenzsatz und ob sie die Empfehlung verändert haben |
| Aufwandschätzung für den Betrieb | Einrichtungszeit, Analystenzeit, QA-Zeit, Engineering-Aufwand, wiederkehrende Kadenz und erwartete Wartung |
| Risikohinweis | Abdeckungslücken, Governance-Bedenken, Exportbeschränkungen, Abhängigkeitsrisiken und Annahmen, die eine Bestätigung erfordern |
Dieses Paket ist auch dann nützlich, wenn der Käufer keinen Anbieter auswählt. Wenn die Alternativen manuelle Analyse, ein allgemeiner KI-Workflow, eine spezialisierte Plattform und eine benutzerdefinierte API-Pipeline sind, sorgt das Paket dafür, dass der Vergleich fair bleibt. Jede Option muss denselben Entscheidungsnachweis liefern.
Warnsignale während der Demo
Achten Sie auf diese Fehlermuster:
- Die Demo kann nicht zeigen, welche Bewertungen einbezogen wurden.
- Wichtige Diagramme lassen sich nicht auf Nachweise auf Bewertungsebene zurückführen.
- Das System fasst unterschiedliche Mechanismen unter vagen Bezeichnungen wie „Qualitätsproblem“ zusammen.
- Wettbewerbsvergleiche verwenden unterschiedliche Zeitfenster oder versteckte Filter.
- Die Ausgabe funktioniert nur als Screenshot oder manuell bearbeitete Folie.
- Der Export lässt Beweis-IDs, Taxonomie-Definitionen, Datumsfenster oder Kommentare weg.
- Mehrdeutige Bewertungen werden ohne ein Vertrauensfeld in sichere Aussagen gezwungen.
- Der Anbieter verspricht, dass eine API oder ein Export den Workflow unterstützen kann, kann aber die Felder, Grenzen oder das Schema nicht zeigen.
- Eine menschliche Korrektur verbessert die Demo, kann aber nicht gespeichert, versioniert oder reproduziert werden.
- Governance-Kontrollen werden mündlich besprochen, aber nicht im Produkt oder in der Dokumentation gezeigt.
Das sind nicht für jedes Team automatische Ausschlussgründe. Ein einmaliges Analystenprojekt kann mehr manuelle Rekonstruktion tolerieren als ein wöchentlicher Betriebsworkflow. Aber diese Warnsignale müssen in Arbeitsaufwand, QA, Migration und Risiko eingepreist werden.
Die Demo in eine Go-, Conditional-Go- oder No-Go-Entscheidung überführen
Schließen Sie jede Beurteilung eines Finalisten mit einem von drei Status ab:
| Status | Verwendung wenn | Nächste Aktion |
|---|---|---|
| Go für den Proof | Der Finalist erfüllt nicht verhandelbare Anforderungen an Abdeckung, Nachweise, Workflow und Governance | Nehmen Sie ihn in den 14-tägigen Proof mit demselben ASIN-Set und dem erforderlichen Artefakt auf |
| Conditional Go | Der Finalist ist vielversprechend, hat aber eine spezifische Lücke, die schnell getestet werden kann | Führen Sie einen gezielten Folge-Test durch, etwa eine Exportprüfung, eine API-Schema-Überprüfung oder einen Taxonomie-Kontrolltest |
| No-Go | Der Finalist kann die Nachweise nicht bewahren oder die erforderliche Workflow-Ausgabe nicht erzeugen | Entfernen Sie ihn aus der engeren Auswahl, auch wenn die Oberfläche oder der Preis attraktiv wirkt |
Der Status sollte sich auf beobachtete Nachweise stützen. „Dem Team hat es gefallen“ ist keine Entscheidung. „No-Go, weil die drei wichtigsten Themen nicht bis zu den Quellbewertungen zurückverfolgt oder mit Datumsfenstern exportiert werden konnten“ ist eine Entscheidung.
Fügen Sie einen Live-Workflow-Abnahmetest hinzu
Eine kontrollierte Demo beweist, dass ein Finalist unter Beobachtung arbeiten kann. Ein Live-Workflow-Abnahmetest beweist, dass das Team das Ergebnis nach dem Ende des Calls nutzen kann.
Führen Sie diesen Test mit jedem Finalisten vor der Freigabe für die Beschaffung durch:
| Abnahmetest | Bestandbedingung | Warum das wichtig ist |
|---|---|---|
| Übergabe an den Eigentümer | Ein Nicht-Analyst als Eigentümer kann das Artefakt lesen und die empfohlene nächste Maßnahme, unterstützende Prüfungen und offene Fragen identifizieren | Das Ergebnis bleibt auch außerhalb der Sitzung mit dem Analysten oder Anbieter erhalten |
| Nachweisprüfung | Ein Stakeholder kann die Belege hinter drei zentralen Aussagen und einem Gegenbeispiel anklicken oder öffnen | Das Team kann das Ergebnis in der Planung oder Qualitätsprüfung verteidigen |
| Erneuter Durchlauf | Ein zweiter Nutzer kann denselben Workflow erneut ausführen und die entscheidungsrelevante Antwort reproduzieren oder kontrollierte Änderungen erklären | Der Workflow ist nicht von einem einzelnen Expertenbediener abhängig |
| Rekonstruktion aus dem Export | Die exportierte Datei oder API-Antwort enthält genügend IDs, Bezeichnungen, Zeitfenster und Belegfelder, um das Ergebnis nachzubilden | Das Team kann Ergebnisse prüfen, migrieren oder mit einem anderen System verknüpfen |
| Fehlersimulation | Das Team weiß, was passiert, wenn ein Produkt wenige Bewertungen, gemischte Sprache, Variantenmehrdeutigkeit oder verdächtige Muster aufweist | Grenzfälle bleiben sichtbar, statt zu selbstsicheren Zusammenfassungen zu werden |
Dies ist die praktische Grenze zwischen einer nützlichen Demo und einem nutzbaren Betriebsprozess. Für Amazon Review Analytics sollte ein Tool, das den Abnahmetest nicht besteht, auch dann in einer explorativen Rolle bleiben, wenn es ansprechende Diagramme hat.
Vergleichen Sie die gesamten Betriebskosten, nicht den Abonnementpreis
Alternativen für Amazon Review Analytics verlagern Arbeit zwischen Software, Analysten, Bedienern und Ingenieuren. Ein fairer Vergleich berücksichtigt alle diese Faktoren.
Das nützlichste Kostenmodell für Amazon Review Analytics: Vergleich und Alternativen misst abgeschlossene Entscheidungen, nicht nur Sitze, Credits oder das Bewertungsvolumen.
Schätzen Sie die jährlichen Betriebskosten mit diesen Posten:
| Kostenposten | Enthalten |
|---|---|
| Plattform | Abonnement, Sitze, Nutzung, Datenlimits, Add-ons und erforderliche Tarifstufe |
| Implementierung | Einrichtung, Taxonomie-Design, historische Importe, Integrationen, Schulung und Dokumentation |
| Analysearbeit | Erfassung, Bereinigung, Prompting, Codierung, Prüfung, Belegkontrollen und Berichtserstellung |
| Qualitätssicherung | Stichprobenprüfungen, Prüfung von Abweichungen, False-Positive-Checks, Pflege der Taxonomie und Abnahmetests |
| Engineering | API-Arbeit, Datenpipelines, Orchestrierung, Speicherung, Monitoring, Incident Response und Upgrades |
| Governance | Sicherheitsprüfung, Zugriffsverwaltung, Aufbewahrung, Löschung, Rechtsprüfung und Lieferantenmanagement |
| Änderungskosten | Überarbeitung des Workflows, Migration, Akzeptanz bei Stakeholdern und Parallelbetrieb während der Einführung |
Berechnen Sie für jeden Finalisten:
Jährliche Betriebskosten = Plattform + Amortisation der Implementierung + Arbeit + QA + Engineering + Governance + Änderungskosten
Teilen Sie das Ergebnis dann durch die abgeschlossenen Entscheidungsartefakte, nicht durch die Anzahl der verarbeiteten Bewertungen:
Kosten pro abgeschlossener Entscheidung = jährliche Betriebskosten / akzeptierte Entscheidungsartefakte
Ein kostengünstiger Zusammenfasser kann teuer werden, wenn Analysten immer wieder Belege neu aufbauen, Taxonomien abgleichen und Ausgaben neu formatieren. Eine Plattform mit höheren Kosten kann dennoch das günstigere Betriebsmodell sein, wenn sie wiederkehrende Arbeit eliminiert. Das Gegenteil ist ebenfalls wahr: Eine spezialisierte Plattform ist verschwenderisch, wenn das Team nur zwei eng umrissene Analysen pro Jahr benötigt.
Verwenden Sie den ROI-Rechner für Product Review Mining, wenn Sie Arbeitsaufwand, Amortisation und confidence-gewichtete Vorteile detaillierter modellieren müssen.
Testen Sie die Exitbarkeit, bevor Sie sich festlegen
Die meisten Vergleiche von Amazon-Review-Analytics konzentrieren sich darauf, Daten in ein Tool zu bekommen. Eine Produktionsentscheidung muss auch prüfen, wie die Belege wieder herauskommen.
Das ist nicht nur eine Beschaffungsfrage. Ihr Workflow kann sich ändern, weil ein Team umstrukturiert wird, sich ein Marktplatz oder eine Integration ändert, ein Anbieter sein Produkt verändert, ein interner Datenstandard ausgereifter wird oder ein besseres Betriebsmodell verfügbar wird. Wenn Belege, Taxonomie und Entscheidungshistorie nicht mitgenommen werden können, kann der scheinbare Gewinner später ein zweites Implementierungsprojekt verursachen.
Fügen Sie dem Vergleich vor der Vertrags- oder Rollout-Entscheidung einen Exitability-Score hinzu. Bewerten Sie jede Zeile von 0 bis 2:
- 0: nicht verfügbar oder nur innerhalb der Oberfläche sichtbar
- 1: teilweise verfügbar, vereinfacht oder von manueller Arbeit abhängig
- 2: in dokumentierter, wiederverwendbarer Form exportierbar
| Exitability-Test | Was ein wiederverwendbares Ergebnis bewahren sollte | Warum das wichtig ist |
|---|---|---|
| Quellenbelege | Rezensionstext oder genehmigte Quellenreferenz, stabile Beleg-ID, ASIN, Bewertung, Datum, Marktplatz, Variante und anderer verfügbarer Kontext | Hält Themen auch nach Änderungen der Oberfläche auditierbar |
| Codierte Analyse | Themenzuordnung, Mechanismus, Sentiment, Konfidenz, Analysten- oder Modellversion und Ausnahmen | Verhindert, dass eine Migration wieder auf Rohtext zurückfällt |
| Taxonomie | Themennamen, Definitionen, Hierarchie, Aliasse, Ausschlüsse und Versionshistorie | Bewahrt die Bedeutung von Trendlinien und Vergleichen |
| Abgeleitete Kennzahlen | Zähler, Nenner, Filter, Zeitfenster, Vergleichsmenge und Berechnungsnotizen | Macht Dashboards reproduzierbar statt dekorativ |
| Workflow-Datensätze | Verantwortliche, Status, Kommentare, Entscheidungen, verknüpfte Artefakte und Prüfdaten | Hält Erkenntnisse mit Maßnahmen und Verantwortlichkeit verbunden |
| Lieferkonfiguration | Gespeicherte Abfragen, Alarmregeln, Zeitpläne, Webhooks, API-Zuordnungen und Ziele | Zeigt den betrieblichen Aufwand, der nötig ist, um den Workflow neu aufzubauen |
| Governance-Datensätze | Rollen, Berechtigungen, Prüfverlauf, Aufbewahrungsregeln und Löschstatus, wo verfügbar | Unterstützt Sicherheitsprüfung und kontrollierte Übergabe |
| Dokumentation | Felddefinitionen, Exportformat, API- oder Schema-Version, Beschränkungen und bekannte Auslassungen | Ermöglicht einem anderen Team, das Paket ohne Rückgriff auf stillschweigendes Wissen zu interpretieren |
Belohnen Sie keinen riesigen Export nur deshalb, weil er viele Spalten enthält. Der Test besteht darin, ob ein anderer Analyst ein akzeptiertes Entscheidungsartefakt aus dem exportierten Paket reproduzieren kann, ohne das ursprüngliche Tool erneut zu öffnen.
Führen Sie einen 60-minütigen Export-Test durch
Verwenden Sie denselben Schwerpunkt-ASIN und dieselbe Entscheidungsfrage aus dem 14-Tage-Nachweis.
- Fordern Sie den Standardexport an. Bitten Sie nicht um einen kundenspezifischen Serviceeinsatz oder einen einmaligen Engineering-Extrakt. Testen Sie, was ein gewöhnlicher Kontoinhaber abrufen kann.
- Verfolgen Sie fünf wichtige Erkenntnisse. Lokalisieren Sie für jedes Thema die unterstützende Bewertungsbelegung, den Produktkontext, das Datumsfenster, die Taxonomiedefinition und die Berechnungsgrundlage.
- Erstellen Sie ein Ergebnis außerhalb des Tools neu. Rekonstruieren Sie aus den exportierten Dateien eine Tabelle zur Beschwerde-Priorisierung, ein Briefing zur Listensprache, eine Tabelle mit Wettbewerbslücken oder die Übergabe für das Monitoring.
- Dokumentieren Sie, was verschwindet. Notieren Sie fehlende Evidenzlinks, abgeschnittenen Bewertungstext, verlorene Filter, abgeflachte Hierarchien, undokumentierte Scores, nicht zugängliche Kommentare und Alert-Logik, die manuell neu aufgebaut werden muss.
- Schätzen Sie die Rekonstruktionszeit. Addieren Sie die Stunden, die zum Bereinigen, Zuordnen, Validieren, Dokumentieren und Wiederherstellen des Workflows erforderlich sind. Tragen Sie diese Schätzung in die Zeile für Änderungskosten des Betriebskostenmodells ein.
Ein Finalist besteht den Export-Test, wenn das Team den Datensatz erklären, das gewählte Artefakt reproduzieren und jede wichtige Einschränkung benennen kann. Eine rohe CSV ohne Definitionen besteht nicht. Ein Screenshot besteht nicht. Ein Versprechen, dass „die API das wahrscheinlich kann“, besteht erst dann, wenn die Felder und Grenzen demonstriert wurden.
Bei API-basierten Optionen sollten Sie das gepflegte Schema prüfen, statt sich auf eine Vertriebsbeschreibung zu verlassen. Amazon veröffentlicht seine Selling Partner API-Modelle, einschließlich des Customer Feedback API model. Eine spezialisierte API sollte dieselbe Klarheit für die Quellfelder, analysierten Felder, Versionen, Authentifizierung, Kontingente, Fehler und das Löschverhalten bieten, die für Ihren Workflow relevant sind.
Verwenden Sie einen 30-Tage-Migrationsplan für die letzten beiden Optionen
Der beste Vergleich wartet nicht auf eine spätere Kündigung, um zu erfahren, ob ein Wechsel möglich ist. Führen Sie eine begrenzte Migrationsprobe zwischen den letzten beiden Betriebsmodellen durch.
Tag 1-5: Inventarisieren Sie den aktuellen Workflow
- Listen Sie jeden Input, jede gespeicherte Ansicht, jede Taxonomie, jeden wiederkehrenden Bericht, jeden Alert, jede Integration, jeden Verantwortlichen und jedes nachgelagerte Entscheidungsartefakt auf.
- Markieren Sie die Datensätze, die für Audit, Trendkontinuität oder den operativen Einsatz aufbewahrt werden müssen.
- Frieren Sie einen Vergleichssatz und ein Datumsfenster ein, damit beide Systeme anhand derselben Evidenz bewertet werden.
- Definieren Sie den Rollback-Trigger, bevor irgendeine produktive Umstellung erfolgt.
Tag 6-10: Exportieren und zuordnen
- Exportieren Sie Quellbelege, codierte Analysen, Taxonomie, abgeleitete Kennzahlen und Workflow-Datensätze.
- Ordnen Sie Quellfelder dem Zielschema zu und kennzeichnen Sie Felder ohne Entsprechung.
- Trennen Sie echten Datenverlust von Darstellungsunterschieden.
- Dokumentieren Sie Transformationen, damit das migrierte Ergebnis erneut ausgeführt werden kann.
Tag 11-20: Führen Sie eine doppelte Ausführung für eine wiederkehrende Entscheidung durch
- Führen Sie den alten und den neuen Ansatz im selben neuen Bewertungsfenster aus.
- Vergleichen Sie Abdeckung, Themennzuweisungen, Evidenzabruf, Nenner, Trendrichtung und endgültige Empfehlungen.
- Untersuchen Sie Abweichungen, statt sie wegzumitteln.
- Verfolgen Sie Analystenzeit, QA-Zeit, Engineering-Arbeit und Übergaben der Verantwortlichen in beiden Workflows.
Tag 21-25: Wenden Sie Akzeptanzkriterien an
Ein Sign-off erforderlich für:
- Nachweisbare Rückverfolgbarkeit für die wichtigsten Erkenntnisse
- Taxonomie-Mapping und bekannte Diskontinuitäten
- Reproduzierbare Kennzahlen und Zeitfenster
- Erforderliche Exporte, Integrationen, Berechtigungen und Warnmeldungen
- Benannte Verantwortliche für Ausnahmen und fehlgeschlagene Jobs
- Ein dokumentierter Archivierungs- und Aufbewahrungsplan
Tage 26-30: umschalten oder stoppen
Schalten Sie nur dann um, wenn das Ziel die eigentlichen Entscheidungsabläufe vollständig abdeckt und das Migrationspaket auch außerhalb des Implementierungsteams verständlich ist. Lassen Sie das bisherige System für den vereinbarten Aufbewahrungszeitraum schreibgeschützt, wenn dies zulässig und sinnvoll ist. Stoppen Sie oder rollen Sie zurück, wenn Nachweise mit hoher Priorität fehlen, die Kontinuität der Trends nicht erklärt werden kann, erforderliche Ausgaben fehlschlagen oder der Betriebsaufwand das genehmigte Modell übersteigt.
Diese Probe verlagert das Migrationsrisiko von einer vagen Beschaffungsfrage hin zu beobachtbarer Arbeit. Sie legt auch eine nützliche Alternative offen: Wenn keiner der beiden Finalisten die von Ihnen benötigten Nachweis- und Workflow-Datensätze bewahren kann, kann eine kleinere, gesteuerte Datenebene wertvoller sein als ein weiteres Dashboard.
Ein einfacher Entscheidungsbaum
Nutzen Sie diese Abfolge, um die Alternativen einzugrenzen.
Schritt 1: Ist dies eine einmalige, eng umrissene Entscheidung?
Wenn ja, beginnen Sie mit einer manuellen Analyse oder einem allgemeinen KI-Assistenten. Kaufen Sie kein Betriebssystem für eine einmalige Frage.
Schritt 2: Kann die native Amazon-Ansicht dies beantworten?
Wenn die Entscheidung Amazon-spezifisch ist und Customer Review Insights ausreichend Produkt-, Nischen-, Themen-, Snippet- und Trendkontext bietet, nutzen Sie zuerst den nativen Workflow.
Schritt 3: Benötigen Sie den Rest einer Seller-Suite?
Wenn Keyword-, Listing-, Produktforschungs-, Werbe- und Betriebstools ebenfalls Priorität haben, vergleichen Sie umfangreiche Suites anhand der kombinierten Aufgabenstellung.
Schritt 4: Ist Review Intelligence wiederkehrend und funktionsübergreifend?
Wenn Produkt, Marketing, Support, Research oder Führungsebene wiederholt dieselben Nachweise benötigen, bewerten Sie eine spezialisierte Plattform.
Schritt 5: Müssen Erkenntnisse in proprietäre Systeme fließen?
Wenn ja, vergleichen Sie den API-Zugang des Spezialanbieters mit einer eigenen Pipeline. Wählen Sie eine Eigenentwicklung nur dann, wenn die erforderliche Kontrolle den Aufwand für Engineering und Governance rechtfertigt.
Führen Sie vor der Zusage einen 14-Tage-Nachweis durch
Testen Sie die Finalisten anhand derselben Entscheidung und desselben Produktsets.
Tage 1-2: den Test definieren
- Eine Entscheidung auswählen
- Ihren ASIN und zwei bis fünf relevante Wettbewerber auswählen
- Das Zeitfenster festlegen
- Fünf bis zehn erwartete Themen definieren
- Festlegen, welche Nachweise aufbewahrt werden müssen
- Den aktuellen Workflow benennen, den der Finalist übertreffen muss, einschließlich manueller Schritte und Zeitaufwand der Verantwortlichen
Tage 3-7: jeden Ansatz durchführen
Verfolgen Sie:
- Einrichtungszeit
- Abgedeckte Bewertungen oder Produkte
- Themenpräzision
- Zeit bis zum Abrufen von Nachweisen
- Fähigkeit, Gegenbeispiele zu finden
- Nützlichkeit für Vergleich und Trendanalyse
- Aufwand für Export oder Übergabe
- Welche aktuellen Schritte abgeschafft, eingegrenzt oder beibehalten würden
Tage 8-10: die Ergebnisse prüfen
Prüfen Sie stichprobenartig manuell eine Auswahl der Quellbewertungen. Achten Sie auf übersehene Themen, falsche Labels, zu allgemeine Zusammenfassungen, doppelte Kategorien und Schlussfolgerungen auf dünner Beweisbasis.
Tage 11-14: ein echtes Ergebnis erstellen
Erstellen Sie das Artefakt, das das Unternehmen benötigt: ein Briefing zu Produktänderungen, ein Briefing zur Listing-Sprache, eine Tabelle zu Wettbewerberlücken, eine Qualitätsuntersuchung oder einen Monitoring-Bericht.
Der erfolgreiche Ansatz ist derjenige, der mit dem geringsten wiederholten Aufwand und dem klarsten Austauschpfad ein vertrauenswürdiges Entscheidungsartefakt erzeugt — nicht die beeindruckendste Demo.
Definieren Sie die Produktionsfreigabe, bevor der Pilot endet
Ein guter Pilot kann in der Produktion trotzdem scheitern, wenn das Team niemals Zuständigkeiten und Service-Standards festlegt. Schreiben Sie vor der Auswahl ein Abnahmeblatt für den Live-Workflow.
Folgendes aufnehmen:
- Verantwortlicher: wer die Analyse durchführt und wer das Entscheidungsartefakt freigibt
- Taktung: einmalig, wöchentlich, monatlich, durch Launch ausgelöst oder durch Vorfall ausgelöst
- Eingaben: Produkte, Wettbewerber, Marktplätze, Sprachen, Datumsfenster und verbundene Datensätze
- Evidenzstandard: wie viele Quellbeispiele, Gegenbeispiele und manuelle Prüfungen erforderlich sind
- Ausgabe: das genaue Briefing, Dashboard, Alarm, Ticket oder die API-Antwort, die nachgelagerte Nutzer erhalten
- Qualitätsschwelle: akzeptable Themenpräzision, Rate verpasster Themen, Rate ungestützter Behauptungen und Prozess zur Abweichung zwischen Analysten
- Fehlerpfad: was passiert, wenn Daten unvollständig sind, sich die Taxonomie ändert oder die Modellausgabe unzuverlässig ist
- Änderungskontrolle: wer Prompts, Labels, Regeln, Modelle oder Integrationen ändern darf
- Monitoring: welche Signale zu Abdeckung, Latenz, Fehlern, Drift und Nutzung überprüft werden
- Ausstiegsplan: wie Daten, Taxonomien, Nachweise und Workflows exportiert oder migriert werden können
Behandeln Sie Vendor-Dokumentation, Sicherheitsantworten und Pilotresultate als Nachweise für dieses Blatt. Ein während einer Demo gegebenes mündliches Versprechen ist keine Produktionskontrolle.
Setzen Sie Mindesthürden, bevor Sie die Endpunktzahl ansehen
Gewichtete Bewertungsbögen sind hilfreich, aber sie können disqualifizierende Schwächen glattmitteln. Setzen Sie Mindesthürden, die nicht durch andere Stärken ausgeglichen werden können.
Für einen wiederkehrenden Amazon-Review-Analytics-Workflow beginnen Sie mit diesen Hürden:
| Hürde | Mindestanforderung an den Nachweis |
|---|---|
| Korpus-Klarheit | Die analysierten Produkte, der Marktplatz, die Daten, die Anzahl der Bewertungen, Filter und Ausschlüsse sind sichtbar oder exportierbar |
| Nachverfolgbarkeit auf Bewertungsebene | Wichtige Themen verweisen zurück auf die ursprüngliche Kundensprache, nicht nur auf generierte Zusammenfassungen |
| Konsistenter Vergleich | Fokus- und Wettbewerbsprodukte verwenden dasselbe Zeitfenster, denselben Nenner und dieselbe Taxonomie, sofern Abweichungen nicht offengelegt werden |
| Analyse jüngster Änderungen | Der Workflow kann Gesamtvolumen und eine jüngste Verschiebung voneinander trennen |
| Entscheidungsoutput | Das Ergebnis kann ohne manuelles Zusammenstellen von Screenshots zu einem Entscheidungsartefakt werden |
| Governance-Tauglichkeit | Zugriff, Aufbewahrung, Exporte, API-Nutzung und der Umgang mit Bewertungen passen zu Plattformregeln und interner Richtlinie |
| Ausstiegsfähigkeit | Nachweise, Taxonomie und Outputs können mit ausreichend Struktur exportiert werden, um zu migrieren oder zu auditieren |
Ein Finalist, der eine dieser Hürden nicht erfüllt, kann dennoch für ein einmaliges Projekt in Betracht gezogen werden. Er sollte jedoch keinen wiederkehrenden, teamübergreifenden Workflow gewinnen, es sei denn, das Team akzeptiert den manuellen Aufwand und das Risiko ausdrücklich.
Formulieren Sie die finale Empfehlung als Entscheidungsnotiz
Das Auswahl-Dokument sollte kurz genug für eine Prüfung und spezifisch genug für ein Audit sein. Verwenden Sie diese Struktur:
Für Entscheidungen zu Amazon review analytics: Vergleich und Alternativen sollte das Memo erklären, warum das ausgewählte Betriebsmodell gegenüber der nativen Ausgangsbasis und der besten glaubwürdigen Alternative gewonnen hat.
- Entscheidung: der ausgewählte Amazon-review-analytics-Ansatz.
- Umfang: Produkte, Marktplätze, Teams, Entscheidungen und Integrationen, die enthalten sind.
- Berücksichtigte Alternativen: die drei bis fünf Finalisten und warum jeder im Rennen blieb.
- Nachweise: gewichtete Scores, Gate-Ergebnisse, Audit-Stichproben und das tatsächliche Artefakt, das während des Proofs erstellt wurde.
- Kosten: Erstjahres- und laufende Betriebskosten, mit sichtbarem Arbeitsaufwand und QA.
- Risiken: Abdeckungslücken, Workflow-Abhängigkeiten, Governance-Bedenken und Annahmen, die noch validiert werden müssen.
- Rollout: Verantwortlicher, erster Anwendungsfall, Akzeptanzschwellen, Prüftermin und Bedingungen für die Ausweitung.
- Ausstiegskriterien: die Bedingungen, die einen Rollback-, Ersatz- oder Build-Entscheid auslösen würden.
So wird aus „uns hat das Tool gefallen“ eine Entscheidung, die ein anderer Stakeholder anfechten, genehmigen und später erneut prüfen kann.
Bewerten Sie Reviews als Signale, nicht als repräsentative Umfrage
Amazon-Bewertungen sind selbst ausgewähltes Kundenfeedback. Sie sind wertvoll, weil sie konkrete Erfahrungen, Fehlerbilder, Erwartungen und Sprache enthalten. Sie sollten nicht automatisch als repräsentative Schätzung der Meinung jedes Käufers behandelt werden.
Die Methodik für Umfragen unterscheidet zwischen Wahrscheinlichkeitsstichproben und Nicht-Wahrscheinlichkeits- bzw. Opt-in-Stichproben, weil die Auswahlwahrscheinlichkeit bei Letzteren nicht bekannt ist. Dieselbe Vorsicht ist hier sinnvoll: Die Häufigkeit von Reviews kann die Untersuchung priorisieren, beweist für sich genommen aber weder die Verbreitung in der Population noch die geschäftliche Wirkung.
Stützen Sie Review-Ergebnisse nach Möglichkeit mit weiteren Nachweisen:
- Retourengründe
- Support-Kontakte
- Garantieansprüche
- Produktanalysen
- Vertriebs- und Konversionsdaten
- Qualitätskontrollaufzeichnungen
- Strukturierte Kundenforschung
Nutzen Sie Review Analytics, um Signale zu finden und zu erklären. Verwenden Sie abgeglichene Betriebsdaten oder kontrollierte Tests, um die Wirkung zu validieren.
Häufig gestellte Fragen
Was ist Amazon Review Analytics?
Amazon Review Analytics ist der Prozess, Review-Text, Bewertungen, Daten, Produkte, Varianten und Kundensprache in Nachweise zu organisieren, die eine Entscheidung unterstützen. Nützliche Analysen gehen über reine Sentiment-Summen hinaus. Sie identifizieren Themen und Mechanismen, bewahren Verknüpfungen zu den Quell-Reviews, vergleichen Produkte nach konsistenten Regeln und trennen wiederkehrendes Volumen von jüngsten Veränderungen.
Was ist die beste Alternative zur manuellen Amazon-Review-Analyse?
Die beste Alternative hängt von der wiederkehrenden Aufgabe ab. Nutzen Sie Amazon-native Insights für eine eng umrissene Seller-Central-Frage, eine Seller-Suite, wenn Review-Analyse Teil eines breiteren Seller-Workflows ist, eine spezialisierte Plattform für wiederholbare Review-Intelligence über Teams hinweg, und eine API-Pipeline, wenn die Ausgabe in proprietäre Systeme eingebettet werden muss. Ein allgemeiner KI-Assistent kann die Analyse nur beschleunigen, nachdem Sie einen rechtmäßigen, kontrollierten Datensatz und einen Prozess für den Nachweis-Audit haben.
Sind Amazon-Review-Zusammenfasser dasselbe wie Review-Analytics-Tools?
Nein. Ein Zusammenfasser komprimiert den Rezensionstext. Ein Analytics-Workflow sollte außerdem das Korpus definieren, Belege auf Rezensionsebene bewahren, einen konsistenten Vergleich unterstützen, mit Daten und Segmenten umgehen, wiederverwendbare Ausgaben erzeugen und es einem anderen Analysten ermöglichen, das Ergebnis erneut auszuführen oder zu hinterfragen. Zusammenfassungen können Teil des Workflows sein, aber sie sind nicht der ganze Workflow.
Should I choose Amazon-native tools or third-party software?
Beginnen Sie mit der nativen Baseline, wenn sie die Produkte, den Marktplatz, den Zeitraum und die Entscheidung abdeckt, die Ihnen wichtig sind. Testen Sie Drittanbieter-Software, wenn Sie einen breiteren Vergleich, benutzerdefinierte Taxonomien, wiederholte Berichterstattung, Zusammenarbeit, kanalübergreifende Belege, Exporte, Monitoring oder die Integration in ein anderes System benötigen. Eine kostenpflichtige Alternative sollte gewinnen, weil sie den Entscheidungs-Workflow besser abschließt, nicht weil ihr Dashboard ausgefeilter aussieht.
Is Helium 10 Review Insights an Amazon review analytics alternative?
Ja, aber bewerten Sie es als Review-Workflow einer Seller-Suite und nicht als eigenständige Review-Intelligence-Plattform. In der aktuellen Dokumentation heißt es, dass Review Insights von Amazons Customer Feedback API angetrieben wird, was nützlich sein kann, wenn native Amazon-Feedback-Themen die richtige Eingabe sind. Die Vergleichsfrage ist, ob dieser API-gestützte Seller-Workflow Ihrem Team genug Nachvollziehbarkeit der Belege, Vergleichskontrolle, Exporte und Übergabe für die Arbeit bietet, die Sie benötigen.
How should I compare Amazon review analytics tools fairly?
Geben Sie jedem Finalisten dieselben ASINs, denselben Datumsbereich, bekannte Edge Cases, dieselbe Entscheidungsfrage und dasselbe erforderliche Ergebnis. Erstellen Sie einen kleinen, von Menschen codierten Referenzsatz, wiederholen Sie den Test ohne Änderung der Eingaben und protokollieren Sie wesentliche Abweichungen. Legen Sie die Gewichtungen vor den Demos fest. Bewerten Sie Abdeckung, Themenübereinstimmung, Stabilität von Lauf zu Lauf, Nachvollziehbarkeit der Belege, Vergleichslogik, Trendbehandlung, Ausgaben, Governance, Integration, Betriebskosten und Migrationsrisiko. Lehnen Sie jede Option ab, die ein nicht verhandelbares Kriterium verfehlt, auch wenn ihre Gesamtpunktzahl bei den Funktionen hoch ist.
What should an Amazon review analytics procurement packet include?
Ein Beschaffungspaket für Amazon Review Analytics sollte die Entscheidungsfrage, die Fokus- und Vergleichs-ASINs, den Marktplatz, den Datumsbereich, das Ziel für die Anzahl der Rezensionen, die Regeln für Belege, die native Baseline, die Begründung der Shortlist, Demo-Artefakte, Einwände der Stakeholder, Gate-Ergebnisse, eine Schätzung der Betriebskosten und Hinweise zur Exit-Fähigkeit enthalten. Das Paket sollte es einem Reviewer ermöglichen, Quellbelege zu prüfen, den Nenner zu verstehen, den Vergleich anzufechten und zu entscheiden, ob der Finalist in einen 14-Tage-Nachweis eintreten sollte.
When should I replace my current Amazon review analytics workflow?
Ersetzen Sie den aktuellen Workflow, wenn er wiederholt Quellbelege verliert, Regeln für den Nenner verschleiert, Produkte nicht konsistent vergleichen kann, für jede Entscheidung eine manuelle Rekonstruktion erfordert, die Governance-Prüfung nicht besteht oder Taxonomie und Beleghistorie vor der Verlängerung nicht exportieren kann. Verkleinern oder beheben Sie ihn stattdessen, wenn der Workflow eine bestimmte Aufgabe noch unterstützt, aber für mehr eingesetzt werden soll, als er ursprünglich dafür entworfen wurde.
How much should Amazon review analytics software cost?
Der Abonnementpreis allein ist kein verlässlicher Vergleichsmaßstab. Berechnen Sie die gesamten Betriebskosten: Lizenz- oder API-Kosten, Analystenzeit, Datenaufbereitung, QA, Engineering, Governance, Schulung, Wartung und Änderungsaufwand. Teilen Sie diese Summe durch eine sinnvolle Einheit wie abgeschlossene Entscheidungszyklen, überwachte ASINs oder freigegebene Deliverables. Nutzen Sie einen 14-tägigen Proof, um zu testen, ob der Workflow die wiederholte Arbeit tatsächlich reduziert.
Können Amazon-Bewertungen belegen, wie verbreitet ein Kundenproblem ist?
Nicht für sich allein. Bewertungen sind selbst ausgewähltes Feedback, daher ist die Häufigkeit eher ein Signal für eine Untersuchung als eine automatische Schätzung der Verbreitung über alle Käufer hinweg. Bewahren Sie den Nenner und den Zeitrahmen, und validieren Sie wichtige Erkenntnisse nach Möglichkeit mit Rücksendungen, Support-Kontakten, Garantieansprüchen, Produktanalysen, kontrollierten Tests oder strukturierter Forschung.
Abschließende Checkliste zum Vergleich von Amazon-Review-Analytics-Alternativen
Bevor Sie sich entscheiden, stellen Sie sicher, dass Sie diese Fragen beantworten können:
- Welcher genaue Bewertungsdatensatz wird analysiert?
- Verwendet der Finalist Amazon-native Themen-Daten, Rohtext der Bewertungen, proprietäre Analyse oder eine Mischung?
- Hat jeder Finalist dasselbe Minimum-Viable-Evidence-Paket erstellt?
- Hat jeder Finalist vor dem Shortlist-Meeting dasselbe Beschaffungspaket erstellt?
- Kann ich die Bewertungen hinter jedem wichtigen Thema prüfen?
- Kann ich Produkte mit konsistenten Nennern und Zeitfenstern vergleichen?
- Kann ich das Gesamtvolumen von der aktuellen Veränderung trennen?
- Kann ich die Taxonomie anpassen oder zumindest verstehen?
- Kann die Ausgabe in den Workflow überführt werden, in dem Entscheidungen getroffen werden?
- Kann ein anderer Analyst die Arbeit erneut ausführen?
- Erhält ein wiederholter Lauf die Entscheidung oder erklärt er, warum sie sich geändert hat?
- Haben wir die Ausgabe mit einem manuell codierten Referenzsatz verglichen?
- Können wir wesentliche Abweichungen diagnostizieren, ohne die Analyse manuell neu aufzubauen?
- Hat jeder Finalist dasselbe Demo-Skript mit denselben ASINs, Datumsfenstern, Evidenzregeln und derselben erforderlichen Ausgabe befolgt?
- Hat jeder Finalist nachgewiesen, welche aktuellen Workflow-Schritte er ersetzen, eingrenzen oder unverändert lassen würde?
- Haben Product-, E-Commerce-, Qualitäts-, Forschungs-, Engineering-, Security- und Finance-Stakeholder die für ihr Risiko relevanten Belege geprüft?
- Hat der gewählte Finalist einen Live-Workflow-Übergabetest mit einem Nicht-Analysten als Verantwortlichem bestanden?
- Entspricht der Prozess den Plattformregeln und der internen Governance?
- Ersetzt das Tool wiederholte Arbeit oder fügt es lediglich ein weiteres Dashboard hinzu?
- Kann ich den Wert mit einem echten Entscheidungsartefakt belegen?
- Habe ich drei bis fünf Finalisten mit vor den Demos festgelegten Gewichtungen verglichen?
- Habe ich Arbeitsaufwand, QA, Engineering, Governance und Änderungsaufwand einbezogen?
- Gibt es einen benannten Verantwortlichen und ein Abnahmeformular für die Produktion?
- Haben wir Mindestschwellen festgelegt, bevor wir die gewichtete Punktzahl angesehen haben?
- Können wir die Belege und die Taxonomie exportieren, wenn sich der Workflow ändert?
Wenn wiederholbare Amazon-Review-Intelligenz in Ihrem Workflow fehlt, verwenden Sie diesen Leitfaden zu Amazon-Review-Analysen: Vergleich und Alternativen als Entscheidungsmaßstab und erkunden Sie dann die Voice-of-Customer-Analyse von VOC AI, vergleichen Sie Review-Signale in einem Produktforschungs-Workflow oder bewerten Sie die Review Analysis API für einen eingebetteten Ansatz.