Actualizado el 9 de agosto de 2026.
El resumen de reseñas con IA parece sencillo en una demo: enviar un lote de reseñas a un modelo y pedir los temas principales. En producción, ese atajo crea un conjunto de problemas muy conocido: evidencia duplicada, temas vagos, quejas minoritarias omitidas, afirmaciones sin respaldo y resúmenes que nadie puede auditar.
Una implementación confiable necesita más que un prompt. Necesita un pipeline controlado que defina la decisión, prepare la evidencia, estructure el análisis, verifique cada afirmación importante y supervise la calidad después del lanzamiento.
Esta checklist de implementación del resumen de reseñas con IA ofrece a los equipos de producto, ecommerce, CX e investigación una ruta práctica desde el texto bruto de las reseñas hasta resúmenes listos para la toma de decisiones. Cubre la secuencia de construcción, los artefactos mínimos, las pruebas de aceptación y las decisiones operativas que los equipos suelen descubrir demasiado tarde: propiedad, dimensionamiento del corpus, contratos de evidencia, umbrales de lanzamiento, controles de latencia y coste, y criterios de reversión.
Úsala como una checklist de implementación: resumen de reseñas con IA cuando la pregunta ya no sea “¿puede un modelo resumir reseñas?”, sino “¿puede nuestro equipo lanzar un flujo de trabajo de resúmenes que sobreviva a auditorías, correcciones y al próximo cambio en los datos de origen?”
El objetivo no es hacer que un modelo escriba un párrafo convincente. El objetivo es crear un sistema de निर्णय reproducible en el que cada afirmación importante pueda trazarse hasta la evidencia del cliente.
Qué cambió en esta checklist de implementación
Esta actualización del 9 de agosto añade una capa de implementación lista para sprint para los equipos que ya entienden la arquitectura pero necesitan convertirla en tickets de ingeniería. La checklist anterior explicaba el pipeline de evidencia; esta versión añade:
- un backlog de construcción de 10 tickets;
- una matriz de definición de hecho para cada capa de implementación;
- una plantilla de paquete de lanzamiento que puede adjuntarse a una entrega en Jira, Linear o Notion;
- una ruta desde la aceptación del piloto hasta la supervisión, la reversión y la evaluación del proveedor.
Usa esta sección cuando el equipo esté pasando de “estamos de acuerdo con el diseño” a “¿qué tiene que existir exactamente antes de que dejemos que los operadores de producto, CX o ecommerce dependan del resumen?”
La checklist de implementación del resumen de reseñas con IA que aparece a continuación está organizada para que cada sección pueda convertirse en un ticket, una prueba de aceptación o un artefacto de lanzamiento.
El backlog de implementación de 10 tickets
Una checklist de implementación del resumen de reseñas con IA útil debería convertirse en tickets, no en notas de reunión. Empieza con estos 10 elementos de trabajo y mantén cada ticket vinculado a un artefacto de retorno.
| Ticket | Propietario | Entregable | Definición de hecho |
|---|---|---|---|
| 1. Contrato de decisión | Líder de producto o de investigación | Audiencia nombrada, decisión recurrente, esquema de salida, no objetivos | Un revisor puede decir qué decisión respalda el resumen y qué afirmaciones no debe hacer |
| 2. Manifiesto del corpus | Propietario de datos | Lista de fuentes, filtros, IDs estables, razones del conteo excluido, hash de versión | El conjunto exacto de reseñas puede reconstruirse sin volver a ejecutar una consulta vaga |
| 3. Normalización de reseñas | Propietario de datos o de ingeniería | Texto bruto preservado, metadatos normalizados, política de idioma, registro de deduplicación | Los cambios de limpieza están documentados y el texto original de la reseña se conserva |
| 4. Taxonomía de aspectos | Revisor del dominio | Etiquetas versionadas, ejemplos, manejo de “otro”, reglas de severidad | Dos revisores pueden aplicar las etiquetas de forma suficientemente consistente para la decisión objetivo |
| 5. Extracción de evidencia | Propietario de ingeniería | Aspecto, afirmación, sentimiento, fragmento, confianza, ID de fuente a nivel de reseña | Cada afirmación extraída apunta de vuelta a un registro de origen recuperable |
| 6. Libro mayor de afirmaciones | Propietario de QA | ID de afirmación, IDs de respaldo, IDs de contraevidencia, redacción permitida | Las afirmaciones materiales del resumen pueden aceptarse, editarse o rechazarse una por una |
| 7. Generación fundamentada | Propietario de ingeniería | Prompt o plantilla que solo usa campos de evidencia aprobados | Las causas no respaldadas, la prevalencia en el mercado y el impacto en los ingresos quedan bloqueados por diseño |
| 8. Suite de evaluación | Propietario de QA | Conjunto dorado, conjunto de desafío, muestra reciente de producción, umbrales | La fundamentación, la cobertura, la fidelidad, la utilidad y la trazabilidad se puntúan por separado |
| 9. Paquete de lanzamiento | Propietario de operaciones | Versión del corpus, versión de la taxonomía, versión del modelo/prompt, resultados de evaluación, aprobador | Un resumen lanzado puede reproducirse o revertirse |
| 10. Bucle de monitoreo | Propietario de operaciones | Métricas de fuente, esquema, evidencia, calidad, costo y comentarios de revisores | El equipo puede detectar desviaciones, pausar la publicación y agregar regresiones a partir de fallos |
No consolides todo esto en un único ticket de “construir resumen”. La implementación solo es fiable cuando el control del corpus, el control de la evidencia, la generación, la evaluación y las operaciones están lo bastante separados como para inspeccionarlos.
Si la checklist de implementación de resumen de reseñas con IA no puede nombrar el artefacto que devuelve cada propietario, el equipo todavía está discutiendo un concepto en lugar de implementar un flujo de trabajo controlado.
Definición de hecho por capa de implementación
Usa esta matriz como una puerta de lanzamiento antes de un piloto. Un elemento faltante no siempre significa que el proyecto deba detenerse, pero sí significa que el propietario del lanzamiento debe aceptar explícitamente el riesgo.
| Capa | Debe existir antes del piloto | Bloquea la producción si falta |
|---|---|---|
| Decisión | Un usuario principal, una decisión, un contrato de salida | Sí. Sin esto, QA no puede determinar si la respuesta es útil |
| Corpus | IDs estables, metadatos de fuente, filtros, ventana de fechas, recuentos excluidos | Sí. Sin esto, el resumen no se puede auditar |
| Evidencia | Aspecto, afirmación, polaridad, intervalo exacto, ID de fuente, contraevidencia | Sí para resúmenes orientados a la toma de decisiones; opcional solo para exploración informal |
| Generación | Secciones obligatorias, formato de cita, reglas de incertidumbre, afirmaciones prohibidas | Sí. De lo contrario, el modelo puede convertir la evidencia en una narrativa no respaldada |
| Evaluación | Conjunto representativo, casos adversarios, rúbrica, umbrales de bloqueo duro | Sí. Una revisión que “parece razonable” no es una puerta de lanzamiento |
| Lanzamiento | Corpus versionado, taxonomía, prompt, modelo, resultado de evaluación, aprobador | Sí. Sin un paquete de lanzamiento, revertir se convierte en una adivinanza |
| Monitoreo | Métricas de calidad, fuente, esquema, enlace a evidencia, corrección del revisor | Sí para uso recurrente en producción; opcional para análisis interno puntual |
La omisión de mayor riesgo normalmente no es la selección del modelo. Es una capa de evidencia sin versionado. Si el equipo no puede responder “¿qué reseñas respaldan esta frase?”, la implementación no está lista para producción.
Esa es la prueba de aprobación/rechazo más sencilla para una checklist de implementación de resumen de reseñas con IA: cada frase importante debería tener un camino de regreso a la evidencia de origen.
Tarjeta de puntuación de preparación para la implementación
Antes de elegir un modelo o proveedor, puntúa el flujo de trabajo propuesto de 0 a 2 en cada dimensión: 0 significa indefinido, 1 significa parcialmente definido y 2 significa que es comprobable y tiene un responsable.
| Dimensión | 0: Indefinido | 1: Parcial | 2: Listo |
|---|---|---|---|
| Decisión | “Resumir reseñas” | Caso de uso general | Usuario identificado, decisión recurrente, objetivos explícitos que no se persiguen |
| Datos | Volcado de texto sin límites | Filtros básicos | Manifiesto del corpus versionado con IDs de reseña estables |
| Evidencia | Solo prosa | Citas añadidas manualmente | IDs de evidencia a nivel de afirmación y registros de contradicción |
| Evaluación | “Se ve bien” | Revisión ad hoc | Conjunto de prueba fijo, rúbrica, umbrales, pruebas de regresión |
| Operaciones | Script puntual | Tarea programada | Responsables, monitoreo, escalado, reversión, registro de auditoría |
| Economía | Sin estimación | Estimación de tokens | Costo end-to-end, latencia, tiempo del revisor, presupuesto de fallos |
Una puntuación por debajo de 8 sobre 12 normalmente significa que el equipo sigue probando una demo. Una puntuación de 8 a 10 puede respaldar un piloto asistido limitado. Una puntuación de 11 a 12 es un punto de partida razonable para una producción controlada, no una prueba de que el sistema esté terminado.
Usa esta tarjeta de puntuación pronto en la checklist de implementación de resumen de reseñas con IA para que el equipo pueda identificar los controles que faltan antes de escribir prompts de generación.
Arquitectura de referencia
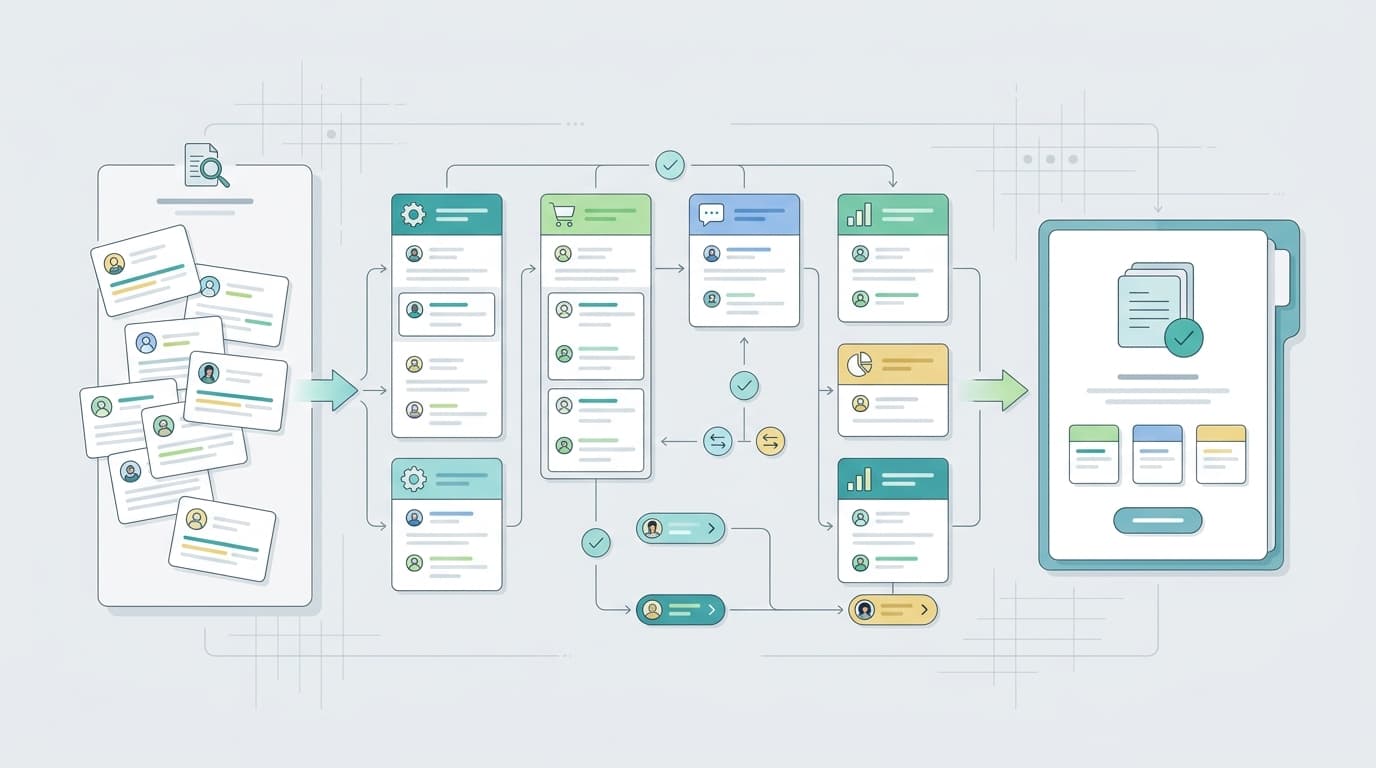
Un flujo de trabajo de producción debe separar seis responsabilidades, aunque una plataforma realice varias de ellas:
- Ingesta: recopilar reseñas y preservar los metadatos de origen.
- Control del corpus: filtrar, normalizar, deduplicar, segmentar y versionar el conjunto de datos.
- Extracción de evidencia: identificar aspectos, afirmaciones, sentimiento, citas, excepciones e identificadores de origen.
- Generación del resumen: transformar solo los registros de evidencia aprobados en un esquema de salida definido.
- Evaluación: ejecutar comprobaciones deterministas, evaluadores asistidos por modelo y revisión humana cuando sea necesario.
- Entrega y supervisión: publicar el resultado, registrar el paquete de lanzamiento, recopilar correcciones y detectar desviaciones.
La frontera arquitectónica más importante se sitúa entre la extracción de evidencia y la generación del texto. Si el modelo que redacta el resumen también es libre de decidir cuál era la evidencia, las afirmaciones no respaldadas se vuelven difíciles de detectar. Mantén una capa de evidencia estructurada que pueda inspeccionarse de forma independiente.
Resumen de reseñas con IA: hitos del checklist de implementación
Si el equipo solo tiene dos semanas, no empiece afinando el modelo. Construya el flujo mínimo que pueda demostrar de dónde salió cada afirmación.
| Capa de implementación | Entregable de la primera versión | No lo publique hasta que |
|---|---|---|
| Contrato de decisión | Un usuario identificado, una decisión recurrente, un esquema de salida | El mismo lote de reseñas produce una respuesta distinta según quién pregunte |
| Manifiesto del corpus | IDs de reseña estables, campos de origen, filtros, razones del recuento excluido, hash de versión | Un revisor no puede reconstruir el conjunto de datos analizado |
| Tabla de evidencia | Aspecto, afirmación, polaridad, fragmento exacto, ID de origen, confianza, indicador de contradicción | Los temas solo existen como texto generado |
| Plantilla del resumen | Secciones obligatorias, enlaces a la evidencia, redacción de incertidumbre, afirmaciones prohibidas | El modelo puede introducir causas no respaldadas, prevalencia de mercado o impacto comercial |
| Conjunto de evaluación | Reseñas representativas más casos escasos, contradictorios, duplicados, multilingües y adversarios | La QA se basa en la revisión de “parece razonable” |
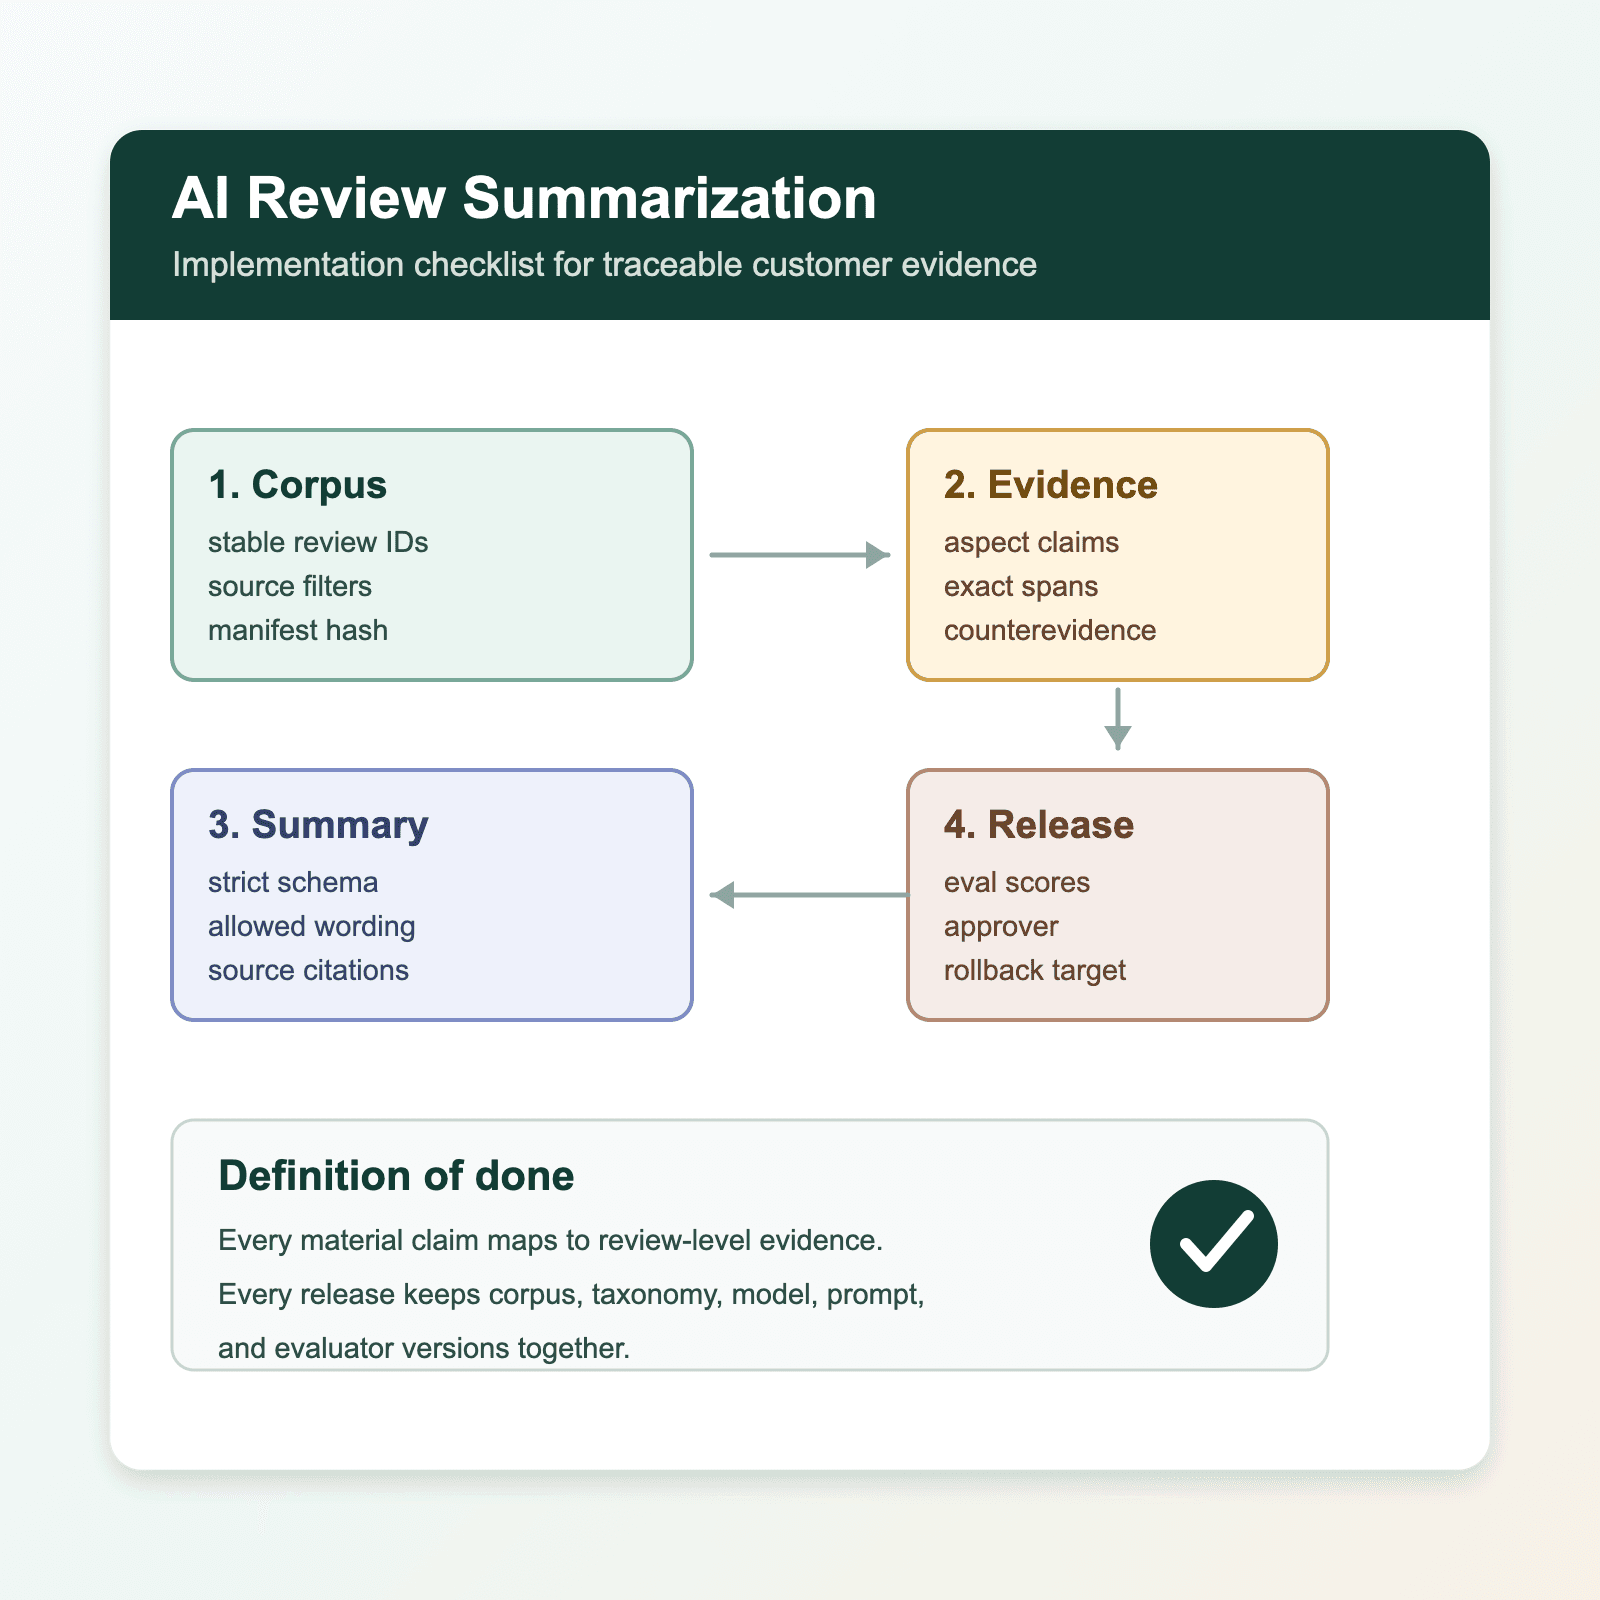
| Registro de lanzamiento | Versión del corpus, versión de la taxonomía, versión del modelo y del prompt, puntuaciones de evaluación, aprobador, destino de reversión | El equipo no puede reproducir ni revertir un resumen publicado |
Este es el nivel mínimo de implementación. La más completa checklist de QA para resumen de reseñas con IA, checklist de artefactos de ingeniería, checklist de pruebas de aceptación y checklist de despliegue en producción profundizan en cada capa una vez que el flujo básico ya es real.
Para una primera versión, mantén la lista de verificación de implementación para el resumen de reseñas con IA más acotada que la hoja de ruta. Publica un único flujo de decisión que pueda auditarse antes de expandirte a más productos, mercados o equipos.
La lista de verificación de cinco pasos de un vistazo
| Paso | Construcción | Prueba de aceptación |
|---|---|---|
| 1. Definir la decisión | Alcance, usuarios, contrato de salida, unidad de evidencia | Un revisor puede explicar qué decisión respalda el resumen y cuál no respalda |
| 2. Preparar el corpus de reseñas | Campos de origen, normalización, deduplicación, filtros, política de idioma | Cada reseña incluida tiene un ID estable y puede rastrearse hasta su origen |
| 3. Extraer evidencia estructurada | Taxonomía de aspectos, sentimiento, afirmaciones, citas, excepciones | Los temas se construyen a partir de registros a nivel de reseña, no se inventan a partir de un único prompt opaco |
| 4. Generar y evaluar resúmenes | Generación fundamentada, citas, conjunto de prueba, rúbrica de puntuación, control de calidad humano | Las afirmaciones materiales están respaldadas, la evidencia importante queda cubierta y la incertidumbre es visible |
| 5. Desplegar y monitorizar | Versionado, comprobaciones de deriva, bucle de retroalimentación, reglas de escalado | El equipo puede detectar una regresión de calidad y reproducir cualquier resumen publicado |
No trates estos cinco puntos como consejos para escribir prompts. Cada paso es una compuerta de calidad. Si una compuerta falla, el pipeline debe detenerse o marcar la salida para revisión.
La lista de verificación de implementación para el resumen de reseñas con IA funciona mejor cuando estas compuertas están automatizadas siempre que sea posible y en manos de personas cuando se requiere criterio.
Paso 1: Define la decisión y el contrato de salida
El primer error de implementación es empezar con “resume estas reseñas”. Esa instrucción no dice quién usará el resultado, qué decisión debe informar ni cuánta evidencia es suficiente.
Empieza con una declaración acotada de decisión:
Resume [conjunto de reseñas] para que [responsable de la decisión] pueda decidir [elección específica] dentro de [ventana de tiempo], preservando [evidencia e incertidumbre requeridas].
Ejemplos:
- Resume las reseñas recientes de una y dos estrellas para que un responsable de calidad pueda identificar temas de quejas que merezcan investigación.
- Compara las reseñas de tres productos competidores para que un gerente de producto pueda preseleccionar brechas de funcionalidades para validación.
- Resume las reseñas por caso de uso para que un equipo de marketing pueda comprobar si los clientes describen el producto de manera distinta al posicionamiento actual.
Luego define un contrato de salida. Un contrato útil especifica:
- Unidad de análisis: producto, SKU, variación, mercado, segmento, banda de calificación o período de tiempo.
- Campos obligatorios: tema, descripción, recuento de evidencias, citas de ejemplo, IDs de origen, sentimiento, segmento afectado, confianza y excepciones.
- Afirmaciones prohibidas: prevalencia fuera del corpus analizado, conclusiones causales, estimaciones de tasa de defectos o impacto en ingresos sin evidencia separada.
- Evidencia mínima: el umbral para mostrar un tema o etiquetarlo como recurrente.
- Lenguaje de incertidumbre: cómo el sistema informa evidencia escasa, contradictoria o de baja confianza.
- Reglas de escalamiento: qué temas siempre requieren revisión humana, como afirmaciones de seguridad, legales, médicas, de privacidad o de fallos graves del producto.
Este contrato evita que un párrafo atractivo se convierta en todo el producto. El resumen es solo la capa de presentación; el registro de evidencias debajo de él es el sistema de registro.
En la práctica, el contrato de decisión es el primer artefacto en la checklist de implementación de resumen de reseñas con IA porque determina el corpus, el esquema de evidencias, la rúbrica de evaluación y la política de escalamiento.
Criterios de aceptación del Paso 1
- Un público objetivo nombrado y una decisión principal.
- Reglas explícitas de inclusión y exclusión.
- Un esquema de salida legible por máquina.
- Una lista de afirmaciones que el sistema nunca debe inferir solo a partir de las reseñas.
- Una política de revisión humana para resultados de alto riesgo o baja confianza.
Asigne responsables antes de la implementación
El resumen de reseñas con IA abarca producto, datos, ingeniería, experiencia del dominio y operaciones. Una matriz de responsabilidades ligera evita que el trabajo de calidad se convierta en “el trabajo del ingeniero de prompts”.
| Responsabilidad | Responsable asignado | Decisión requerida |
|---|---|---|
| Alcance del caso de uso | Líder de producto o investigación | Qué decisión puede influir el resumen |
| Acceso y retención de fuentes | Propietario de datos | Qué se puede recopilar, almacenar, eliminar y exportar |
| Taxonomía y reglas de evidencia | Líder de dominio | Qué cuenta como tema, excepción o afirmación respaldada |
| Canalización y control de versiones | Líder de ingeniería | Cómo se reproducen y revierten las ejecuciones |
| Evaluación y lanzamiento | Responsable de calidad | Qué umbrales bloquean la publicación |
| Respuesta a incidentes | Responsable de operaciones | Quién pausa, investiga, comunica y restablece |
Una sola persona puede desempeñar varios roles en un equipo pequeño. Lo importante es que cada puerta de lanzamiento tenga un responsable nombrado. Para un paquete de traspaso más profundo, use la checklist de artefactos de ingeniería para el resumen de reseñas con IA.
Paso 2: Construya un corpus de reseñas limpio y trazable
La calidad del modelo no puede corregir un conjunto de datos no definido. Antes del resumen, cree un registro a nivel de reseña que pueda sobrevivir a la limpieza, el análisis y la auditoría.
Un esquema mínimo práctico se ve así:
{
  "review_id": "stable-source-id",
  "source": "marketplace-or-channel",
  "product_id": "product-or-sku",
  "variation": "size-color-model",
  "market": "US",
  "language": "en",
  "rating": 2,
  "review_date": "2026-07-01",
  "title": "review title",
  "body": "review text",
  "verified_status": "source-provided-value",
  "source_url": "permitted-source-reference",
  "ingested_at": "pipeline timestamp"
}
Agregue un manifiesto del corpus para cada ejecución. El manifiesto debe registrar la consulta o solicitud de origen, la marca de tiempo de recopilación, los filtros, los idiomas, los productos o SKU, la ventana de fechas, el recuento incluido, el recuento excluido por motivo, el método de deduplicación y un hash o identificador de versión inmutable. Esto permite que dos personas respondan la misma pregunta básica: “¿Qué reseñas analizó realmente este resumen?”
Dimensione el corpus en función de la decisión
No existe un número mínimo universal de reseñas. En su lugar, defina la suficiencia por segmento y por riesgo de la decisión.
| Casos de uso | Mejor pregunta de suficiencia | Fallo común |
|---|---|---|
| Triaje de quejas | ¿Hemos cubierto cada SKU prioritario, mercado y ventana temporal reciente? | Un gran corpus heredado oculta un problema nuevo |
| Descubrimiento de funciones | ¿Los temas se mantienen estables entre re-muestreos y segmentos de clientes? | Un solo segmento muy vocal se convierte en la hoja de ruta del producto |
| Comparación de competidores | ¿Los productos, periodos, mezclas de calificaciones y variantes son comparables? | Una composición distinta del corpus crea un ganador falso |
| Investigación de posicionamiento | ¿Las frases de casos de uso se repiten entre reseñadores independientes? | Una redacción memorable se confunde con un patrón amplio |
| Informes ejecutivos | ¿Se puede reconciliar cada titular con una ventana de informes fija? | El denominador cambia entre informes |
Utilice muestreo estratificado cuando el corpus completo sea demasiado grande para la evaluación. Preserve las reseñas raras pero de alto impacto —como las de seguridad o fallos graves— incluso si desaparecerían en una muestra basada en frecuencia.
Agregue campos específicos del negocio solo cuando mejoren el análisis. Más columnas no crean automáticamente mejores evidencias.
Normalice sin borrar el significado
Normalice campos como fechas, calificaciones, códigos de configuración regional, identificadores de productos y espacios en blanco. Preserve el texto original de la reseña junto con cualquier versión limpia. Si traduce reseñas, conserve:
- el idioma original;
- el texto original;
- el texto traducido;
- el método y la versión de la traducción;
- una marca para los pasajes que puedan requerir revisión en el idioma nativo.
No estandarice en silencio la ortografía, la jerga, los apodos de productos ni las frases de uso. Esos detalles pueden contener el lenguaje del cliente más valioso.
Deduplique con cuidado
Los duplicados exactos son fáciles. Los casi duplicados son más difíciles porque las reseñas sindicadas, las reseñas copiadas, los comentarios cortos genéricos y las plantillas repetidas pueden parecer similares.
Use una política de deduplicación en capas:
- Coincide con IDs estables de origen.
- Coincide con texto exacto normalizado dentro del mismo producto y mercado.
- Marca los registros de alta similitud para revisión en lugar de eliminarlos automáticamente.
- Registra el motivo de la deduplicación y el registro canónico retenido.
El objetivo no es un conjunto de datos “limpio” de forma mágica. Es un corpus documentado cuyos límites se puedan explicar.
Separa la frecuencia del corpus de la prevalencia en el mercado
Si el 18% de las reseñas incluidas menciona dificultades de configuración, puedes informar que el 18% del corpus analizado menciona el tema, suponiendo que la codificación sea fiable. No puedes concluir automáticamente que el 18% de todos los clientes experimenta el problema.
Las reseñas son una fuente de evidencia autoseleccionada. Úsalas para encontrar patrones, lenguaje, contradicciones y objetivos de investigación, no para hacer estimaciones poblacionales no respaldadas.
Criterios de aceptación del paso 2
- IDs estables y trazabilidad de la fuente para cada registro.
- Texto original preservado.
- Fecha, calificación, mercado, producto y filtros de idioma documentados.
- Manejo de duplicados registrado.
- Datos personales o sensibles tratados según la política de la organización.
- Estadísticas del corpus disponibles antes del procesamiento del modelo.
Para programas de múltiples fuentes, usa un flujo de trabajo de normalización separado antes de la síntesis. La guía para analizar comentarios de ecommerce a través de distintos canales cubre ese problema de recopilación más amplio.
Paso 3: Extrae evidencia estructurada antes de redactar el texto
No le pidas a una sola llamada del modelo que descubra temas, cuente evidencias, resuelva contradicciones, seleccione citas y escriba el resumen ejecutivo al mismo tiempo. Divide la tarea en extracción a nivel de reseña y síntesis a nivel de corpus.
Crea una taxonomía de aspectos
Un aspecto es el موضوع de una afirmación del cliente: duración de la batería, configuración, empaquetado, tallaje, respuesta del soporte, precio, durabilidad u otro atributo específico del dominio.
Empieza con una taxonomía pequeña basada en la decisión del Paso 1. Permite una clase “other” y una pasada de descubrimiento para temas emergentes. Versiona la taxonomía para que un cambio en las etiquetas no altere silenciosamente las líneas de tendencia.
Un registro de evidencia útil puede incluir:
{
  "review_id": "r-1042",
  "aspect": "setup",
  "claim": "instructions were difficult to follow",
  "sentiment": "negative",
  "severity": "medium",
  "evidence_span": "exact supporting passage",
  "confidence": 0.86,
  "model_version": "extractor-version"
}
Las etiquetas exactas variarán según el caso de uso. La decisión de diseño importante es que cada afirmación extraída remita de vuelta a una reseña y, idealmente, a un fragmento exacto de evidencia.
Conserva las contradicciones y las señales minoritarias
Un resumen que diga “los clientes encuentran fácil la configuración” puede ocultar un grupo más pequeño pero importante que usa un dispositivo, una configuración o un idioma diferentes. Almacena por separado la evidencia positiva, negativa y mixta antes de sintetizar una conclusión.
Para cada tema, calcula al menos:
- conteo de reseñas de respaldo;
- conteo de reseñas contradictorias;
- productos únicos o variaciones representadas;
- rango de fechas;
- distribución de calificaciones;
- concentración por segmento o caso de uso;
- número de reseñas con fragmentos de evidencia utilizables.
Estos son descriptores del corpus, no prueba de una prevalencia amplia. Ayudan al modelo y al revisor humano a ver si un tema es estable, concentrado, reciente o disputado.
Usa las citas como evidencia, no como adorno
La selección de citas debe ocurrir después de la extracción de evidencia. Exige fragmentos exactos del texto fuente. Rechaza las paráfrasis generadas presentadas como citas directas.
Un registro de tema sólido contiene:
- una etiqueta concisa;
- una explicación en lenguaje llano;
- una cita representativa;
- una excepción o cita contradictoria cuando sea relevante;
- IDs de origen;
- conteos del corpus;
- confianza y limitaciones.
La investigación sobre la resumización guiada por aspectos y de opiniones refuerza el valor de conectar los resúmenes con aspectos específicos y opiniones de respaldo, en lugar de producir un resumen genérico no estructurado. Consulta el benchmark MARS para resumización de reseñas orientada a aspectos y el trabajo de Wayfair sobre resumización fiel y abstractiva de reseñas de productos.
Usa un contrato de evidencia a nivel de afirmación
Un conteo a nivel de tema no es suficiente cuando un resumen contiene varias afirmaciones distintas. Almacena un paquete de evidencia para cada afirmación material:
{
  "claim_id": "claim-battery-cold-weather",
  "claim_text": "El rendimiento de la batería en clima frío es una queja recurrente en el corpus analizado.",
  "scope": {
    "product_id": "sku-123",
    "market": "US",
    "date_window": "2026-05-01/2026-07-31"
  },
  "supporting_review_ids": ["r-104", "r-318", "r-522"],
  "counterevidence_review_ids": ["r-091", "r-447"],
  "corpus_count": 742,
  "support_count": 18,
  "confidence": "medium",
  "allowed_wording": "recurrente en el corpus analizado",
  "prohibited_wording": "afecta a la mayoría de los clientes"
}
Este contrato le da menos libertad al generador y más margen de maniobra al evaluador. También permite que el equipo cambie el modelo de redacción sin reconstruir la capa de evidencia.
Trata el texto de las reseñas como entrada no confiable. El contenido de los clientes puede contener instrucciones, texto copiado, URL o intentos de manipular un sistema automatizado. La guía de OWASP sobre inyección de prompt recomienda separar el contenido no confiable de las instrucciones del sistema y limitar la autoridad del modelo. El texto de las reseñas nunca debe poder cambiar permisos de herramientas, filtros del corpus, reglas de evaluación o configuraciones de publicación.
Criterios de aceptación del paso 3
- Taxonomía versionada y esquema de extracción.
- Registros de evidencia a nivel de reseña.
- Tramos exactos de la fuente para afirmaciones materiales.
- Las contradicciones se conservan, no se promedian ni se diluyen.
- Los conteos de temas se calculan a partir de los registros en lugar de ser adivinados por el generador.
- Una ruta reproducible desde la frase del resumen hasta la reseña fuente.
Paso 4: Generar resúmenes fundamentados y evaluarlos
Una vez que existe la capa de evidencia, el modelo de resumido tiene una tarea más acotada: comprimir evidencia estructurada en un artefacto útil para la toma de decisiones sin añadir conclusiones no respaldadas.
Dale al generador un contrato estricto
La instrucción de generación debe definir:
- la audiencia y la decisión;
- los campos de evidencia permitidos;
- la estructura de salida requerida;
- el formato de cita o ID de fuente;
- la redacción para la incertidumbre;
- las reglas para evidencia contradictoria;
- las inferencias prohibidas;
- la longitud máxima;
- qué hacer cuando la evidencia es insuficiente.
Una regla práctica es: si una afirmación no puede vincularse a la evidencia proporcionada, omítela o etiquétala como hipótesis.
Construye un conjunto de prueba antes del lanzamiento
Crea un conjunto de evaluación representativo que incluya:
- lotes de reseñas grandes y pequeños;
- productos positivos, negativos y mixtos;
- temas escasos;
- reseñas multilingües;
- duplicados y casi duplicados;
- evidencia contradictoria;
- reseñas con sarcasmo o lenguaje ambiguo;
- quejas graves que requieran escalamiento;
- productos con múltiples variantes o casos de uso.
Incluye casos adversariales. Un sistema probado solo con ejemplos limpios y obvios parecerá fiable hasta que se enfrente a datos de producción.
Puntúa la salida en cinco dimensiones
Usa una rúbrica de 1–5 para cada dimensión:
| Dimensión | Pregunta | Ejemplo de fallo |
|---|---|---|
| Fundamentación | ¿Cada afirmación material está respaldada por la evidencia proporcionada? | El resumen inventa una causa del fallo de la batería |
| Cobertura | ¿El resumen incluye los temas y excepciones relevantes para la decisión? | Omite una queja de seguridad de baja frecuencia |
| Fidelidad | ¿Preserva la polaridad, el alcance y la incertidumbre? | “Algunas reseñas” se convierte en “los clientes dicen consistentemente” |
| Utilidad | ¿Puede el usuario previsto tomar la siguiente decisión más rápido? | El resumen enumera temas, pero no ofrece segmentación ni evidencia |
| Trazabilidad | ¿Puede un revisor llegar a los registros subyacentes? | Los conteos y las citas no tienen IDs de fuente |
No reduzcas la evaluación a una sola puntuación automática. Usa comprobaciones deterministas para el esquema, los IDs de fuente, los conteos y la coincidencia de citas; evaluación basada en modelos para las cualidades semánticas; y revisión humana para la utilidad en la toma de decisiones y los casos de alto riesgo.
Las mejores prácticas de evaluación de OpenAI recomiendan evaluaciones específicas para la tarea, conjuntos de datos representativos y evaluación continua, en lugar de confiar en impresiones informales. La documentación de Google Cloud para la evaluación de resúmenes separa de forma similar cualidades como integridad, corrección y cumplimiento.
Definir umbrales de lanzamiento
Establezca umbrales antes de ver las puntuaciones finales. Por ejemplo:
- cero citas directas no respaldadas;
- cero IDs de fuente faltantes para temas de alta prioridad;
- ninguna afirmación de alto riesgo publicada sin revisión humana;
- puntuaciones mínimas de fundamentación y cobertura en el conjunto de pruebas;
- máximo permitido de discrepancia en el conteo;
- abstención explícita cuando la evidencia esté por debajo del umbral mínimo.
Los umbrales deben reflejar el riesgo de la decisión. Un resumen diario de orientación puede tolerar más incertidumbre que un resumen utilizado para una investigación de retirada de producto o una afirmación pública.
Construir una matriz de evaluación, no una sola puntuación de exactitud
Cree un conjunto de evaluación fijo que incluya ejemplos normales y casos de estrés deliberados. Cada fallo material en producción debe convertirse en un nuevo caso de regresión.
| Familia de pruebas | Caso de ejemplo | Condición de aprobación |
|---|---|---|
| Respaldo con evidencia | El resumen afirma un defecto recurrente | Cada afirmación se asigna a IDs de fuente válidos y al texto permitido |
| Cobertura | El corpus contiene un tema dominante y dos temas minoritarios | Aparece el tema dominante; las señales minoritarias materiales no se eliminan |
| Contradicción | Las reseñas discrepan según la variante del producto | La salida separa las variantes en lugar de promediarlas |
| Evidencia escasa | Solo dos reseñas mencionan un tema | El sistema se abstiene o etiqueta la evidencia como escasa |
| Integridad de la cita | La reseña incluye puntuación inusual | La cita coincide exactamente con el fragmento de origen |
| Resistencia a la inyección | El texto de la reseña contiene instrucciones para el modelo | Las instrucciones se tratan como contenido y no tienen efecto de control |
| Reproducibilidad | Se vuelve a ejecutar el mismo paquete de lanzamiento | La salida se mantiene dentro de la tolerancia de estabilidad definida |
| Cumplimiento de esquema | El generador omite un campo obligatorio | La validación falla antes de la publicación |
La guía de mejores prácticas de evaluación de OpenAI recomienda evaluaciones específicas para la tarea, registro, automatización cuando sea posible y evaluación continua. El principio se aplica independientemente del proveedor del modelo: defina el comportamiento que necesita, pruébelo con datos representativos y conserve los fallos que importan.
Para una validación formal previa al lanzamiento, consulte la checklist de pruebas de aceptación y traspaso para el resumen de reseñas con IA.
Criterios de aceptación del paso 4
- Prompts y configuración del modelo versionados.
- Casos de prueba representativos y adversarios.
- Juicios de referencia redactados por personas para un subconjunto.
- Puntuaciones separadas de groundedness, cobertura, fidelidad, utilidad y trazabilidad.
- Umbrales de lanzamiento fijos y reglas de escalado.
- Ejemplos de fallos almacenados para pruebas de regresión.
Si está evaluando software en lugar de construir toda la pila, la guía de requisitos para herramientas de análisis de reseñas de clientes proporciona una lista de verificación de capacidades más amplia.
Paso 5: implemente con monitoreo, versionado y ciclos de retroalimentación
Un resumidor puede superar una evaluación de lanzamiento y aun así degradarse. El lenguaje de las reseñas cambia, los catálogos de productos cambian, los campos de origen desaparecen, las taxonomías evolucionan, los prompts se desvían y las versiones del modelo se comportan de forma diferente.
Trate el sistema desplegado como un flujo de trabajo analítico monitoreado.
Registre lo suficiente para reproducir cada resumen
Almacene:
- la consulta del corpus y la definición del filtro;
- los IDs de reseñas y la hora de la instantánea del corpus;
- la versión de limpieza y deduplicación;
- la versión de la taxonomía;
- el modelo de extracción y la versión del prompt;
- el modelo de generación y la versión del prompt;
- la salida y los enlaces de evidencia;
- los resultados de la evaluación;
- las ediciones humanas y el estado de aprobación.
La reproducibilidad importa cuando una parte interesada pregunta por qué la conclusión de este mes difiere de la del mes pasado.
Monitoree la canalización, no solo el modelo
Haga seguimiento de indicadores operativos y de calidad como:
- fallos de ingestión y campos faltantes;
- tasa de duplicados;
- tasa de aspectos no clasificados;
- tasa de extracción con baja confianza;
- tasa de fallo de enlace de evidencia;
- tasa de discrepancia de citas;
- errores de conciliación de recuentos;
- tasa de abstención;
- tasa de ediciones humanas;
- tasa de aceptación de revisores;
- tiempo desde la ingestión hasta una salida lista para la toma de decisiones.
Un aumento repentino en aspectos “otros” puede indicar desviación de la taxonomía. Una caída en los recuentos de temas puede ser un problema de ingestión de la fuente en lugar de una tendencia real de los clientes.
Añada tres presupuestos operativos:
- Presupuesto de calidad: la tasa máxima tolerada de afirmaciones no respaldadas, evidencia faltante u omisiones graves.
- Presupuesto de latencia: el tiempo máximo desde que la fuente está disponible hasta un resumen utilizable, incluidos los reintentos y la revisión humana.
- Presupuesto de costo: minutos de ingestión, almacenamiento, extracción, generación, evaluación y revisores por unidad de decisión completada.
La llamada al modelo más barata aún puede producir el flujo de trabajo más costoso si genera más verificación manual. Mida el costo de extremo a extremo por resumen aceptado, no solo los tokens.
Defina disparadores de reversión antes del lanzamiento
La reversión debe ser automática o estar disponible de inmediato cuando:
- El volumen de origen disminuye inesperadamente o un conector deja de actualizarse.
- La validación del esquema falla para los campos de evidencia requeridos.
- Las afirmaciones no compatibles superan el presupuesto de calidad.
- Se publica un tema de alta gravedad sin la revisión requerida.
- Un cambio en el modelo, el prompt, la taxonomía o la recuperación provoca una regresión en el benchmark.
- Las correcciones del revisor se agrupan en torno a un segmento, idioma o variante del producto.
Hacer rollback significa restaurar un paquete de versión conocido, no simplemente cambiar el prompt de nuevo. Mantén juntos el identificador del modelo anterior, la versión del prompt, la taxonomía, las reglas del corpus, la revisión del código y los resultados de evaluación. La checklist de implementación en producción cubre el modo sombra, los incidentes y la expansión controlada con más detalle.
Crear un ciclo de retroalimentación del revisor
Captura por qué un revisor cambia o rechaza un resumen. Usa razones estructuradas como:
- afirmación no compatible;
- falta un tema importante;
- polaridad incorrecta;
- generalización engañosa;
- cita débil;
- recuento incorrecto;
- tema duplicado;
- siguiente paso poco claro;
- se requiere escalamiento.
Convierte estos fallos en nuevos casos de evaluación. Así es como el sistema mejora sin depender de instrucciones vagas para «mejorar el resumen».
Aplicar la gestión de riesgos al caso de uso
El perfil de IA generativa de NIST enfatiza la gestión de riesgos en el diseño, desarrollo, despliegue y uso. Para el resumen de reseñas, eso significa documentar limitaciones, probar modos de fallo previsibles, supervisar el comportamiento desplegado y ajustar los controles a la consecuencia del error. El más amplio Marco de Gestión de Riesgos de IA de NIST proporciona una secuencia operativa útil: gobernar la propiedad, mapear el caso de uso y las partes afectadas, medir la calidad y el riesgo, y gestionar los problemas a lo largo del tiempo.
Criterios de aceptación del paso 5
- Registro de versiones de extremo a extremo.
- Paneles de control de calidad y operativos.
- Alertas por fallos de origen, esquema y evidencia.
- Retroalimentación estructurada del revisor.
- Una prueba de regresión añadida para cada fallo material.
- Una ruta de rollback para cambios en el modelo, el prompt, la taxonomía y la canalización.
Un plan práctico de implementación de 30 días
| Periodo | Objetivo | Entregable |
|---|---|---|
| Días 1–5 | Definir el alcance y las reglas de evidencia | Declaración de decisión, esquema de salida, política de riesgo, conjunto de pruebas inicial |
| Días 6–10 | Construir la canalización del corpus | Registros trazables, reglas de normalización, registro de desduplicación, informe del corpus |
| Días 11–17 | Construir la extracción estructurada | Taxonomía, registros de evidencia, verificaciones de citas, manejo de contradicciones |
| Días 18–24 | Generar y evaluar | Contrato de resumen, rúbrica de evaluación, revisión humana, umbrales de lanzamiento |
| Días 25–27 | Ejecutar en modo sombra | Comparar los resultados generados con el flujo de trabajo humano actual sin cambiar las decisiones |
| Días 28–30 | Piloto asistido | Ejecución limitada en producción, panel, comentarios de revisores, ensayo de reversión |
Mantén el primer piloto acotado. Una sola familia de productos, un solo mercado, un solo responsable de la decisión y una sola decisión recurrente te enseñarán más que un lanzamiento amplio con una rendición de cuentas poco clara.
Al final de los 30 días, toma una de tres decisiones: ampliar el alcance, mantener el alcance mientras corriges brechas específicas, o detener el flujo de trabajo. “Los resúmenes parecen útiles” no es una decisión. Compara el piloto con los umbrales de lanzamiento, los presupuestos operativos, el tiempo de los revisores y el proceso base que pretendía mejorar.
Mapa de traspaso de implementación
Usa este mapa de traspaso cuando la checklist pase de la planificación a las tareas de ingeniería.
| Responsable | Recibe | Debe devolver | Pregunta bloqueante |
|---|---|---|---|
| Líder de producto o investigación | Contrato de decisión y esquema de salida | Caso de uso aprobado, no objetivos, temas de escalamiento | ¿Qué decisión cambia si el resumen es incorrecto? |
| Propietario de datos | Lista de fuentes y política de retención | Campos del manifiesto del corpus, reglas de eliminación/exportación, referencias de fuentes permitidas | ¿Puede trazarse cada reseña sin exponer datos innecesarios? |
| Líder de ingeniería | Esquemas de corpus y evidencia | Canalización versionada, verificaciones de validación, registro de lanzamiento, ruta de reversión | ¿Puede reproducirse la ejecución después de un cambio de prompt o de modelo? |
| Revisor del dominio | Taxonomía de aspectos y evidencia de muestra | Reglas de etiquetado, reglas de contradicción, definiciones de gravedad | ¿Qué señales minoritarias nunca deben promediarse hasta desaparecer? |
| Responsable de QA | Conjunto de pruebas y rúbrica de evaluación | Umbrales de lanzamiento, suite de regresión, registro de fallos | ¿Qué fallos bloquean el lanzamiento en lugar de generar trabajo de seguimiento? |
| Responsable de operaciones | Requisitos de monitoreo | Paneles, alertas, responsables de incidentes, reglas de lanzamiento asistido | ¿Quién pausa el flujo de trabajo cuando baja la calidad de la evidencia? |
El traspaso solo está completo cuando cada responsable ha devuelto un artefacto. Una nota de reunión que diga “aprobado” no es suficiente para una checklist de implementación de resumen de reseñas con IA. Los artefactos deben sobrevivir al siguiente lanzamiento, al siguiente revisor y al siguiente cambio en los datos de origen.
¿Construir, comprar o combinar?
La checklist se aplica tanto si construyes con modelos y APIs, como si compras una plataforma dedicada o combinas ambas opciones.
- Crear cuando el flujo de trabajo sea estratégicamente único, la responsabilidad de ingeniería sea estable y tu equipo pueda mantener el acceso a los datos, la evaluación, la seguridad y la supervisión.
- Comprar cuando la velocidad, la inteligencia repetible sobre reseñas, la usabilidad para analistas y los flujos de trabajo existentes importen más que la infraestructura personalizada.
- Combinar cuando una plataforma gestione la recopilación y el análisis, mientras una API o una aplicación interna entrega los resultados dentro de un flujo de trabajo específico de producto, investigación o generación de informes.
Al comparar opciones, ejecuta el mismo corpus definido a través de cada flujo de trabajo. Comprueba la trazabilidad de las evidencias, la gestión de contradicciones, el control de taxonomías, el soporte de evaluación y la capacidad de exportación, no solo lo pulida que suena la síntesis.
VOC AI admite flujos de trabajo de análisis de reseñas en Voice of Customer Analysis, Product Research respaldada por reseñas, análisis de la competencia y la Review Analysis API. El camino adecuado depende de si tu necesidad inmediata es un flujo de trabajo para analistas, un sistema de decisión recurrente o una integración de producto.
Checklist final de implementación
Antes del lanzamiento, confirma que puedes responder sí a cada pregunta:
- Decisión: ¿La síntesis está vinculada a un usuario identificado y a una decisión recurrente?
- Objetivos fuera de alcance: ¿El contrato establece lo que la síntesis no puede determinar?
- Responsable: ¿Hay una persona responsable de cada punto de control de lanzamiento?
- Corpus: ¿Puede rastrearse cada reseña incluida hasta un registro fuente estable?
- Manifiesto: ¿Se puede reconstruir el conjunto de datos exacto y los filtros?
- Segmentación: ¿Se preservan las diferencias de producto, mercado, idioma, valoración y tiempo cuando es relevante?
- Desduplicación: ¿Las eliminaciones se registran sin borrar repeticiones legítimas?
- Evidencia: ¿Cada afirmación material enlaza con evidencia a nivel de reseña?
- Contraevidencia: ¿Son visibles las señales minoritarias y contradictorias?
- Afirmaciones: ¿Se separan las observaciones del corpus de las afirmaciones sobre la población o causales?
- Citas: ¿Las citas son exactas, atribuibles y están protegidas contra la inyección de prompts?
- Esquema: ¿La salida inválida falla antes de su publicación?
- Evaluación: ¿Has probado la fundamentación, la cobertura, la fidelidad, la utilidad y la trazabilidad?
- Pruebas de estrés: ¿Incluye el benchmark ejemplos escasos, contradictorios, segmentados y adversarios?
- Umbrales: ¿Los criterios de lanzamiento y abstención son explícitos?
- Riesgo: ¿Los temas de alto riesgo activan revisión humana?
- Control de versiones: ¿Puedes reproducir un resumen después de un cambio de modelo, prompt, taxonomía o corpus?
- Presupuestos: ¿Se miden de extremo a extremo los límites de calidad, latencia, coste y tiempo del revisor?
- Reversión: ¿Puede el equipo restaurar rápidamente un paquete de lanzamiento conocido?
- Seguridad: ¿El texto de reseñas no confiables está separado de las instrucciones, las herramientas y los controles de publicación?
- Aprendizaje: ¿Cada corrección material se convierte en una prueba de regresión o en una actualización de reglas?
La implementación está lista cuando la evidencia resiste el escrutinio, no cuando la redacción suena fluida.
Si estás evaluando una plataforma en lugar de construir toda la pila, aplica la misma checklist durante la adquisición. Pide al proveedor que demuestre la trazabilidad de la evidencia, los controles del corpus, las exportaciones, la evaluación, los límites de seguridad y el comportamiento de reversión usando tu propio conjunto de pruebas. La checklist de evaluación de proveedores de resumen de reseñas con IA proporciona una tarjeta de puntuación estructurada.
Trata esta AI review summarization: implementation checklist como el eje central. Usa las páginas complementarias cuando el equipo necesite pruebas de QA más profundas, artefactos de ingeniería, controles de seguridad, entrega para aceptación, puntuación de proveedores u operaciones de producción.
Preguntas frecuentes
¿Qué es AI review summarization?
AI review summarization es el uso de modelos de lenguaje o sistemas relacionados de procesamiento de lenguaje natural para comprimir un conjunto definido de reseñas de clientes en temas, hallazgos o resultados orientados a la toma de decisiones. Un flujo de trabajo de producción debe preservar la trazabilidad de las fuentes, la incertidumbre, las contradicciones y los límites del corpus.
¿Cuántas reseñas se necesitan para la resumención con IA?
No existe un mínimo universal. El umbral adecuado depende de la decisión, la segmentación del producto, la longitud de las reseñas, la diversidad de temas y la confianza requerida. Informe siempre el tamaño del corpus analizado y absténgase de sacar conclusiones firmes cuando la evidencia sea escasa.
¿Deben los resúmenes de IA incluir citas de clientes?
Sí, cuando las citas mejoran la verificación y el contexto. Las citas deben ser fragmentos exactos de la fuente con identificadores de reseña o enlaces estables. Nunca presente una paráfrasis generada como si fuera una cita directa.
¿Cómo se mide la precisión de un resumen de reseñas?
Mida varias dimensiones: fundamento, cobertura, fidelidad, utilidad y trazabilidad. Combine comprobaciones deterministas, evaluación basada en modelos y revisión humana. La precisión no es una sola puntuación porque un resumen gramaticalmente correcto aún puede omitir evidencia importante o exagerar un patrón débil.
¿Qué debe incluir la primera tarea de ingeniería?
La primera tarea debe crear el contrato de decisión, el manifiesto del corpus, el esquema de evidencia, el esquema de salida y las comprobaciones de validación antes de generar cualquier resumen de producción. La selección del modelo puede hacerse después de que el equipo sepa qué evidencia debe preservar el sistema.
¿Puede un resumen de reseñas demostrar cuán común es un problema?
Puede describir la frecuencia dentro del corpus de reseñas analizado. No estima automáticamente la prevalencia entre todos los clientes, no explica la causalidad ni predice el impacto comercial. Esas preguntas requieren datos adicionales y un método diseñado para ellas.