Atualizado em 9 de agosto de 2026.
A sumarização de avaliações com IA parece simples em um demo: envie um lote de avaliações para um modelo e peça os principais temas. Em produção, esse atalho cria um conjunto familiar de problemas: evidências duplicadas, temas vagos, reclamações minoritárias ausentes, alegações sem suporte e resumos que ninguém consegue auditar.
Uma implementação confiável precisa de mais do que um prompt. Ela precisa de um pipeline controlado que defina a decisão, prepare as evidências, estruture a análise, verifique cada afirmação importante e monitore a qualidade após o lançamento.
Este checklist de implementação de sumarização de avaliações com IA oferece às equipes de produto, ecommerce, CX e pesquisa um caminho prático, do texto bruto das avaliações até resumos prontos para decisão. Ele cobre a sequência de construção, os artefatos mínimos, os testes de aceitação e as decisões operacionais que as equipes geralmente descobrem tarde demais: responsabilidade, dimensionamento do corpus, contratos de evidência, limites de lançamento e controles de latência e custo, além de critérios de reversão.
Use-o como um checklist de implementação de sumarização de avaliações com IA quando a pergunta já não for “um modelo consegue resumir avaliações?”, mas “nossa equipe consegue lançar um fluxo de resumo que suporte auditoria, correção e a próxima mudança nos dados de origem?”
O objetivo não é fazer um modelo escrever um parágrafo convincente. O objetivo é criar um sistema de decisão reproduzível no qual cada afirmação importante possa ser rastreada até a evidência do cliente.
O que mudou neste checklist de implementação
Esta atualização de 9 de agosto adiciona uma camada de implementação pronta para sprint para equipes que já entendem a arquitetura, mas precisam transformá-la em tickets de engenharia. O checklist anterior explicou o pipeline de evidências; esta versão adiciona:
- um backlog de construção com 10 tickets;
- uma matriz de definição de pronto para cada camada de implementação;
- um modelo de pacote de lançamento que pode ser anexado a uma transferência no Jira, Linear ou Notion;
- um caminho da aceitação do piloto até monitoramento, reversão e avaliação de fornecedores.
Use esta seção quando a equipe estiver passando de “estamos de acordo com o design” para “o que exatamente precisa existir antes de permitirmos que produto, CX ou operadores de ecommerce confiem no resumo?”
O checklist de implementação de sumarização de avaliações com IA abaixo está organizado para que cada seção possa se tornar um ticket, teste de aceitação ou artefato de lançamento.
O backlog de implementação com 10 tickets
Um checklist de implementação de sumarização de avaliações com IA útil deve se tornar tickets, não notas de reunião. Comece com estes 10 itens de trabalho e mantenha cada ticket vinculado a um artefato de retorno.
| Ticket | Responsável | Entregável | Definição de pronto |
|---|---|---|---|
| 1. Contrato de decisão | Líder de produto ou pesquisa | Público nomeado, decisão recorrente, esquema de saída, não objetivos | Um revisor consegue identificar qual decisão o resumo apoia e quais afirmações ele não deve fazer |
| 2. Manifesto do corpus | Responsável pelos dados | Lista de fontes, filtros, IDs estáveis, motivos da contagem excluída, hash de versão | O conjunto exato de avaliações pode ser reconstruído sem repetir uma consulta vaga |
| 3. Normalização das avaliações | Responsável por dados ou engenharia | Texto bruto preservado, metadados normalizados, política de idioma, registro de deduplicação | As alterações de limpeza são documentadas e o texto original da avaliação é mantido |
| 4. Taxonomia de aspectos | Revisor de domínio | Rótulos versionados, exemplos, tratamento de “outros”, regras de severidade | Dois revisores conseguem aplicar os rótulos de forma consistente o suficiente para a decisão-alvo |
| 5. Extração de evidências | Responsável por engenharia | Aspecto, afirmação, sentimento, trecho, confiança e ID da fonte no nível da avaliação | Cada afirmação extraída aponta de volta para um registro de origem recuperável |
| 6. Registro de afirmações | Responsável por QA | ID da afirmação, IDs de suporte, IDs de contraevidência, redação permitida | As afirmações materiais do resumo podem ser aceitas, editadas ou rejeitadas uma a uma |
| 7. Geração fundamentada | Responsável por engenharia | Prompt ou template que usa apenas campos de evidência aprovados | Causas não suportadas, prevalência de mercado e impacto na receita são bloqueados por design |
| 8. Conjunto de avaliação | Responsável por QA | Conjunto dourado, conjunto de desafio, amostra recente de produção, limites | Fundamentação, cobertura, fidelidade, utilidade e rastreabilidade são avaliadas separadamente |
| 9. Pacote de liberação | Responsável por operações | Versão do corpus, versão da taxonomia, versão do modelo/prompt, resultados da avaliação, aprovador | Um resumo liberado pode ser reproduzido ou revertido |
| 10. Ciclo de monitoramento | Responsável por operações | Métricas de fonte, esquema, evidência, qualidade, custo e feedback do revisor | A equipe consegue detectar desvio, pausar a publicação e adicionar regressões a partir de falhas |
Não transforme isso em um único ticket de “construir a sumarização”. A implementação só é confiável quando o controle do corpus, o controle da evidência, a geração, a avaliação e as operações são suficientemente separados para inspeção.
Se a checklist de implementação do resumo de avaliações com IA não consegue nomear o artefato que cada responsável entrega, a equipe ainda está discutindo um conceito em vez de implementar um fluxo de trabalho controlado.
Definição de pronto por camada de implementação
Use esta matriz como uma porta de liberação antes de um piloto. Um item ausente nem sempre significa que o projeto deve parar, mas significa que o responsável pelo lançamento deve aceitar explicitamente o risco.
| Camada | Deve existir antes do piloto | Bloqueia a produção se estiver ausente |
|---|---|---|
| Decisão | Um usuário principal, uma decisão, um contrato de saída | Sim. Sem isso, o QA não consegue dizer se a resposta é útil |
| Corpus | IDs estáveis, metadados de origem, filtros, janela de datas, contagens excluídas | Sim. Sem isso, o resumo não pode ser auditado |
| Evidência | Aspecto, afirmação, polaridade, trecho exato, ID da fonte, contraevidência | Sim para resumos voltados à tomada de decisão; opcional apenas para exploração informal |
| Geração | Seções obrigatórias, formato de citação, regras de incerteza, afirmações proibidas | Sim. Caso contrário, o modelo pode transformar evidência em narrativa sem suporte |
| Avaliação | Conjunto representativo, casos adversariais, rubrica, limites de corte rígidos | Sim. Uma revisão do tipo “parece razoável” não é um critério de lançamento |
| Release | Corpus versionado, taxonomia, prompt, modelo, resultado de avaliação, aprovador | Sim. Sem um pacote de release, o rollback vira chute |
| Monitoramento | Qualidade, fonte, esquema, vínculo com evidências, métricas de correção por revisores | Sim para uso recorrente em produção; opcional para análise interna pontual |
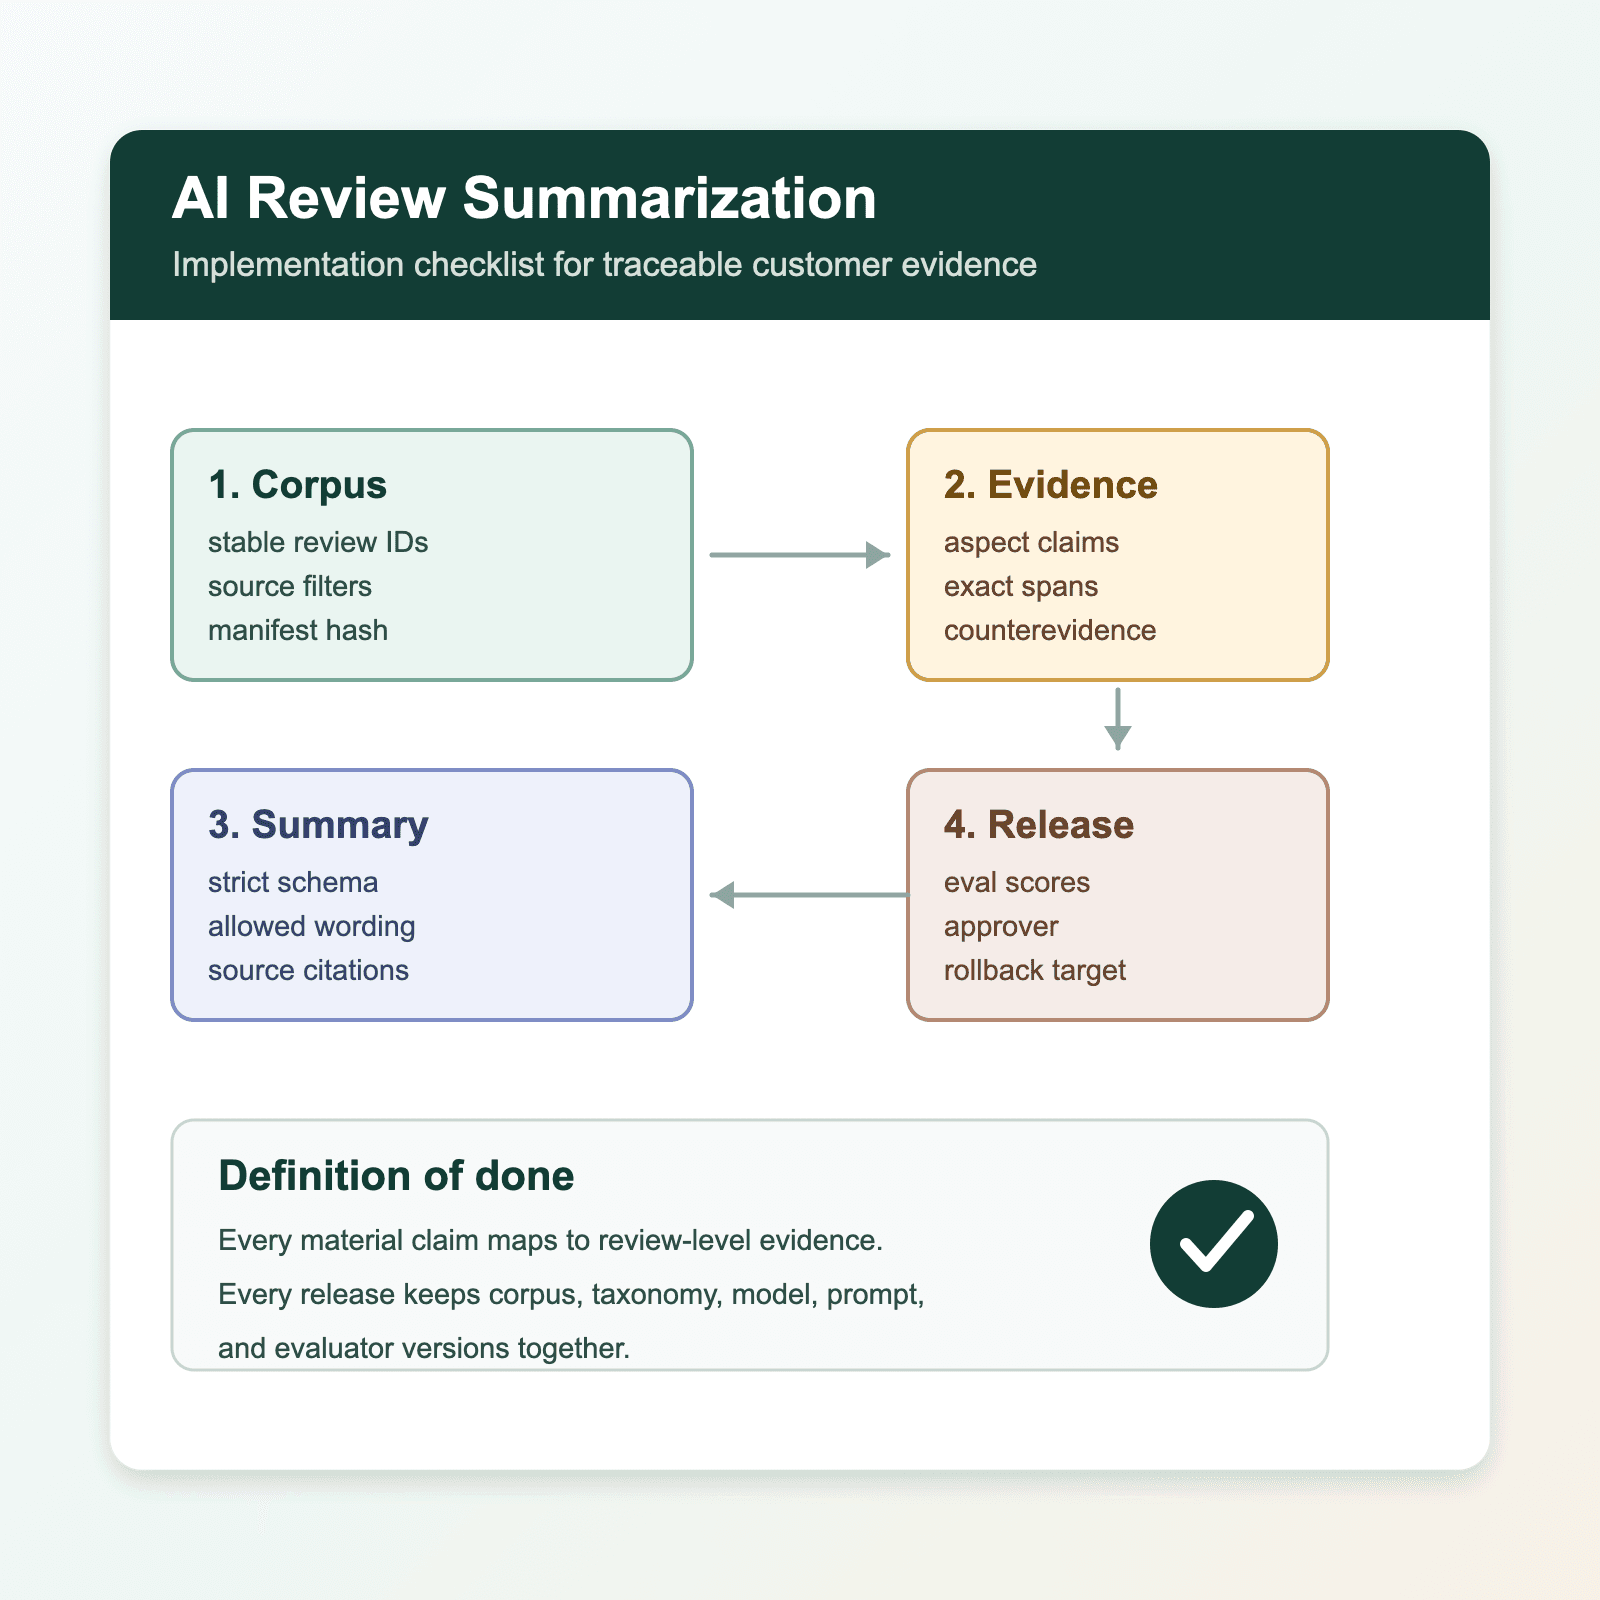
A omissão de maior risco geralmente não é a seleção do modelo. É uma camada de evidências sem versionamento. Se a equipe não consegue responder “quais avaliações sustentam esta frase?”, a implementação não está pronta para produção.
Esse é o teste mais simples de aprovação/reprovação para uma checklist de implementação de resumo de avaliações com IA: toda frase importante deve ter um caminho de volta para a evidência de origem.
Scorecard de prontidão para implementação
Antes de escolher um modelo ou fornecedor, dê uma nota de 0 a 2 para o fluxo de trabalho proposto em cada dimensão: 0 significa indefinido, 1 significa parcialmente definido e 2 significa testável e com responsável definido.
| Dimensão | 0: Indefinido | 1: Parcial | 2: Pronto |
|---|---|---|---|
| Decisão | “Resumir avaliações” | Casos de uso gerais | Usuário nomeado, decisão recorrente, não objetivos explícitos |
| Dados | Despejo de texto sem limites | Filtros básicos | Manifesto de corpus versionado com IDs estáveis de avaliações |
| Evidência | Apenas texto corrido | Citações adicionadas manualmente | IDs de evidência no nível da दावाção e registros de contradição |
| Avaliação | “Parece bom” | Revisão ad hoc | Conjunto de teste fixo, rubrica, limites, testes de regressão |
| Operações | Script único | Job agendado | Responsáveis, monitoramento, escalonamento, rollback, log de auditoria |
| Economia | Sem estimativa | Estimativa de tokens | Custo de ponta a ponta, latência, tempo de revisor, orçamento de falhas |
Uma pontuação abaixo de 8 em 12 normalmente significa que a equipe ainda está testando um demo. Uma pontuação de 8–10 pode suportar um piloto assistido e restrito. Uma pontuação de 11–12 é um ponto de partida razoável para produção controlada — não uma prova de que o sistema está concluído.
Use este scorecard cedo na checklist de implementação de resumo de avaliações com IA para que a equipe possa identificar controles ausentes antes de escrever prompts de geração.
Arquitetura de referência
Um fluxo de trabalho de produção deve separar seis responsabilidades, mesmo que uma plataforma execute várias delas:
- Ingestão: coletar avaliações e preservar os metadados de origem.
- Controle do corpus: filtrar, normalizar, deduplicar, segmentar e versionar o conjunto de dados.
- Extração de evidências: identificar aspectos, alegações, sentimento, citações, exceções e IDs de origem.
- Geração de resumo: transformar apenas registros de evidência aprovados em um esquema de saída definido.
- Avaliação: executar verificações determinísticas, avaliadores assistidos por modelo e revisão humana quando necessário.
- Entrega e monitoramento: publicar o resultado, registrar o pacote de lançamento, coletar correções e detectar desvio.
A fronteira arquitetônica mais importante fica entre a extração de evidências e a geração do texto. Se o modelo que escreve o resumo também puder decidir qual era a evidência, alegações sem suporte se tornam difíceis de detectar. Mantenha uma camada estruturada de evidências que possa ser inspecionada de forma independente.
Resumo de avaliações com IA: marcos do checklist de implementação
Se a equipe tiver apenas duas semanas, não comece ajustando o modelo. Construa o pipeline mínimo que consiga provar de onde veio cada afirmação.
| Camada de implementação | Entrega da primeira versão | Não publique até |
|---|---|---|
| Contrato de decisão | Um usuário nomeado, uma decisão recorrente, um esquema de saída | O mesmo lote de avaliações produz uma resposta diferente dependendo de quem pergunta |
| Manifesto do corpus | IDs estáveis de avaliações, campos de origem, filtros, motivos de contagem excluída, hash de versão | Um revisor não consegue reconstruir o conjunto de dados analisado |
| Tabela de evidências | Aspecto, alegação, polaridade, trecho exato, ID de origem, confiança, sinalizador de contradição | Os temas existem apenas como texto gerado |
| Modelo de resumo | Seções obrigatórias, links de evidência, linguagem de incerteza, alegações proibidas | O modelo pode introduzir causas sem suporte, prevalência de mercado ou impacto nos negócios |
| Conjunto de avaliação | Avaliações representativas mais casos esparsos, contraditórios, duplicados, multilíngues e adversariais | O QA se baseia em revisão de “parece razoável” |
| Registro de lançamento | Versão do corpus, versão da taxonomia, versão do modelo e do prompt, pontuações de avaliação, aprovador, alvo de rollback | A equipe não consegue reproduzir nem reverter um resumo publicado |
Este é o nível mínimo de implementação. O mais completo checklist de QA para resumo de avaliações com IA, checklist de artefatos de engenharia, checklist de teste de aceitação e checklist de implantação em produção aprofunda cada camada depois que o pipeline básico é real.
Para uma primeira versão, mantenha a checklist de implementação do resumo de avaliações com IA mais restrita do que o roadmap. Lance um fluxo de decisão que possa ser auditado antes de expandir para mais produtos, mercados ou equipes.
A checklist de cinco etapas em resumo
| Etapa | Construção | Teste de aceitação |
|---|---|---|
| 1. Defina a decisão | Escopo, usuários, contrato de saída, unidade de evidência | Um revisor consegue explicar qual decisão o resumo apoia — e qual ele não apoia |
| 2. Prepare o corpus de avaliações | Campos de origem, normalização, deduplicação, filtros, política de idioma | Cada avaliação incluída tem um ID estável e pode ser rastreada até sua origem |
| 3. Extraia evidências estruturadas | Taxonomia de aspectos, sentimento, alegações, citações, exceções | Os temas são montados a partir de registros no nível da avaliação, não inventados a partir de um único prompt opaco |
| 4. Gere e avalie resumos | Geração fundamentada, citações, conjunto de teste, rubrica de pontuação, QA humano | Declarações relevantes são apoiadas, as evidências importantes são cobertas e a incerteza fica visível |
| 5. Implante e monitore | Versionamento, verificações de drift, loop de feedback, regras de escalonamento | A equipe consegue detectar regressão de qualidade e reproduzir qualquer resumo publicado |
Não trate isso como cinco dicas de escrita de prompt. Cada etapa é um portão de qualidade. Se um portão falhar, o pipeline deve parar ou sinalizar a saída para revisão.
A checklist de implementação do resumo de avaliações com IA funciona melhor quando esses portões são automatizados sempre que possível e ficam sob responsabilidade de pessoas quando é necessário julgamento.
Etapa 1: Defina a decisão e o contrato de saída
O primeiro erro de implementação é começar com “resuma estas avaliações”. Essa instrução não diz quem vai usar o resultado, qual decisão ele deve informar ou quanta evidência é suficiente.
Comece com uma declaração de decisão delimitada:
Resuma [conjunto de avaliações] para que [responsável pela decisão] possa decidir [escolha específica] dentro de [janela de tempo], preservando [evidências e incertezas exigidas].
Exemplos:
- Resuma avaliações recentes de uma e duas estrelas para que um líder de qualidade possa identificar temas de reclamação que merecem investigação.
- Compare avaliações de três produtos concorrentes para que um gerente de produto possa selecionar uma lista curta de lacunas de funcionalidades para validação.
- Resuma avaliações por caso de uso para que uma equipe de marketing possa testar se os clientes descrevem o produto de forma diferente do posicionamento atual.
Em seguida, defina um contrato de saída. Um contrato útil especifica:
- Unidade de análise: produto, SKU, variação, mercado, segmento, faixa de avaliação ou período de tempo.
- Campos obrigatórios: tema, descrição, contagem de evidências, citações de exemplo, IDs de origem, sentimento, segmento afetado, confiança e exceções.
- Reivindicações proibidas: prevalência fora do corpus analisado, conclusões causais, estimativas de taxa de defeito ou impacto na receita sem evidência separada.
- Evidência mínima: o limiar para exibir um tema ou rotulá-lo como recorrente.
- Linguagem de incerteza: como o sistema relata evidências esparsas, contraditórias ou de baixa confiança.
- Regras de escalonamento: quais tópicos sempre exigem revisão humana, como segurança, jurídico, médico, privacidade ou alegações de falha grave do produto.
Esse contrato impede que um parágrafo atraente se torne o produto inteiro. O resumo é apenas a camada de apresentação; o registro de evidências por baixo dele é o sistema de registro.
Na prática, o contrato de decisão é o primeiro artefato na checklist de implementação de resumo de avaliações com IA, porque determina o corpus, o esquema de evidências, a rubrica de avaliação e a política de escalonamento.
Critérios de aceitação da etapa 1
- Um público nomeado e uma decisão principal.
- Regras explícitas de inclusão e exclusão.
- Um esquema de saída legível por máquina.
- Uma lista de alegações que o sistema nunca deve inferir apenas a partir de avaliações.
- Uma política de revisão humana para saídas de alto risco ou baixa confiança.
Atribua responsáveis antes da implementação
O resumo de avaliações com IA cruza produto, dados, engenharia, conhecimento de domínio e operações. Uma matriz leve de responsabilidades impede que o trabalho de qualidade se torne “o trabalho do engenheiro de prompt”.
| Responsabilidade | Responsável | Decisão necessária |
|---|---|---|
| Escopo do caso de uso | Líder de produto ou pesquisa | Em qual decisão o resumo pode influenciar |
| Acesso à fonte e retenção | Responsável pelos dados | O que pode ser coletado, armazenado, excluído e exportado |
| Taxonomia e regras de evidência | Líder de domínio | O que conta como tema, exceção ou alegação suportada |
| Pipeline e versionamento | Líder de engenharia | Como as execuções são reproduzidas e revertidas |
| Avaliação e lançamento | Responsável pela qualidade | Quais limites bloqueiam a publicação |
| Resposta a incidentes | Responsável pelas operações | Quem pausa, investiga, comunica e restaura |
Uma única pessoa pode acumular várias funções em uma equipe pequena. O essencial é que cada etapa de aprovação tenha um tomador de decisão nomeado. Para um pacote de handoff mais detalhado, use a checklist de artefatos de engenharia para resumo de avaliações com IA.
Etapa 2: crie um corpus de avaliações limpo e rastreável
A qualidade do modelo não pode corrigir um conjunto de dados indefinido. Antes da sumarização, crie um registro no nível da avaliação que possa sobreviver à limpeza, à análise e à auditoria.
Um esquema mínimo prático é o seguinte:
{
  "review_id": "stable-source-id",
  "source": "marketplace-or-channel",
  "product_id": "product-or-sku",
  "variation": "size-color-model",
  "market": "US",
  "language": "en",
  "rating": 2,
  "review_date": "2026-07-01",
  "title": "review title",
  "body": "review text",
  "verified_status": "source-provided-value",
  "source_url": "permitted-source-reference",
  "ingested_at": "pipeline timestamp"
}
Adicione um manifesto do corpus para cada execução. O manifesto deve registrar a consulta ou solicitação de origem, o carimbo de data/hora da coleta, filtros, idiomas, produtos ou SKUs, janela de datas, contagem incluída, contagem excluída por motivo, método de deduplicação e um hash ou identificador imutável de versão. Isso permite que duas pessoas respondam à mesma pergunta básica: “Quais avaliações esta síntese realmente analisou?”
Dimensione o corpus em torno da decisão
Não existe um número mínimo universal de avaliações. Em vez disso, defina a suficiência por segmento e risco da decisão.
| Casos de uso | Pergunta melhor para suficiência | Falha comum |
|---|---|---|
| Triagem de reclamações | Cobrimos cada SKU prioritário, mercado e janela de tempo recente? | Um grande corpus legado oculta um novo problema |
| Descoberta de recursos | Os temas permanecem estáveis em reamostragens e segmentos de clientes? | Um único segmento vocal vira o roadmap do produto |
| Comparação com concorrentes | Produtos, períodos, combinações de avaliações e variantes são comparáveis? | A composição diferente do corpus cria um vencedor falso |
| Pesquisa de posicionamento | As frases de casos de uso reaparecem entre avaliadores independentes? | Uma redação memorável é confundida com um padrão amplo |
| Relatórios executivos | É possível reconciliar cada título com uma janela fixa de relatórios? | O denominador muda entre relatórios |
Use amostragem estratificada quando o corpus completo for grande demais para avaliação. Preserve avaliações raras, mas de alto impacto — como relatos de segurança ou falhas graves — mesmo que elas desapareçam em uma amostra baseada em frequência.
Adicione campos específicos do negócio apenas quando eles melhorarem a análise. Mais colunas não criam automaticamente evidências melhores.
Normalize sem apagar o significado
Normalize campos como datas, avaliações, códigos de localidade, identificadores de produto e espaços em branco. Preserve o texto original da avaliação ao lado de qualquer versão limpa. Se você traduzir avaliações, mantenha:
- o idioma original;
- o texto original;
- o texto traduzido;
- o método e a versão da tradução;
- um sinalizador para trechos que possam exigir revisão em língua nativa.
Não padronize silenciosamente ortografia, gírias, apelidos de produtos ou expressões de uso. Esses detalhes podem conter a linguagem mais valiosa do cliente.
Deduplicate cuidadosamente
Duplicatas exatas são fáceis. Quase duplicatas são mais difíceis porque avaliações sindicadas, avaliações copiadas, comentários genéricos curtos e modelos repetidos podem parecer semelhantes.
Use uma política de desduplicação em camadas:
- Corresponda a IDs estáveis da origem.
- Corresponda a texto exato normalizado dentro do mesmo produto e mercado.
- Marque registros de alta similaridade para revisão, em vez de excluí-los automaticamente.
- Registre o motivo da desduplicação e o registro canônico retido.
O objetivo não é um conjunto de dados “limpo” de forma mágica. É um corpus documentado cujos limites podem ser explicados.
Separe a frequência no corpus da prevalência no mercado
Se 18% das avaliações incluídas mencionam dificuldade na configuração, você pode relatar que 18% do corpus analisado menciona o tema, assumindo que a codificação seja confiável. Você não pode concluir automaticamente que 18% de todos os clientes enfrentam o problema.
As avaliações são uma fonte de evidência auto-selecionada. Use-as para encontrar padrões, linguagem, contradições e alvos de investigação — não para fazer estimativas populacionais sem respaldo.
Critérios de aceitação da Etapa 2
- IDs estáveis e rastreabilidade da origem para cada registro.
- Texto original preservado.
- Data, avaliação, mercado, produto e filtros de idioma documentados.
- Tratamento de duplicatas registrado.
- Dados pessoais ou sensíveis tratados de acordo com a política da organização.
- Estatísticas do corpus disponíveis antes do processamento do modelo.
Para programas com múltiplas fontes, use um fluxo de trabalho separado de normalização antes da sumarização. O guia sobre analisar feedback de e-commerce entre canais cobre esse problema mais amplo de coleta.
Etapa 3: Extraia evidências estruturadas antes de escrever o texto
Não peça a uma única chamada de modelo para descobrir temas, contar evidências, resolver contradições, selecionar citações e লিখwer o resumo executivo simultaneamente. Divida o trabalho em extração no nível da avaliação e síntese no nível do corpus.
Crie uma taxonomia de aspectos
Um aspecto é o assunto de uma afirmação do cliente: duração da bateria, configuração, embalagem, tamanho, tempo de resposta do suporte, preço, durabilidade ou outro atributo específico do domínio.
Comece com uma pequena taxonomia com base na decisão da Etapa 1. Permita uma classe “outros” e uma passada de descoberta para temas emergentes. Versione a taxonomia para que uma mudança nos rótulos não altere silenciosamente as linhas de tendência.
Um registro de evidência útil pode incluir:
{
  "review_id": "r-1042",
  "aspect": "setup",
  "claim": "instructions were difficult to follow",
  "sentiment": "negative",
  "severity": "medium",
  "evidence_span": "exact supporting passage",
  "confidence": 0.86,
  "model_version": "extractor-version"
}
Os rótulos exatos variarão conforme o caso de uso. A decisão de design importante é que cada दावा extraída aponte de volta para uma avaliação e, idealmente, para um trecho exato de evidência.
Preserve contradições e sinais minoritários
Um resumo que diz “os clientes acham a configuração fácil” pode esconder um grupo menor, mas importante, que usa um dispositivo, configuração ou idioma diferente. Armazene evidências positivas, negativas e mistas separadamente antes de sintetizar uma conclusão.
Para cada tema, calcule pelo menos:
- contagem de avaliações de apoio;
- contagem de avaliações contraditórias;
- produtos ou variações únicos representados;
- intervalo de datas;
- distribuição de avaliações;
- concentração por segmento ou caso de uso;
- número de avaliações com trechos de evidência utilizáveis.
Esses são descritores do corpus, não prova de ampla prevalência. Eles ajudam o modelo e o revisor humano a ver se um tema é estável, concentrado, recente ou contestado.
Use citações como evidência, não como decoração
A seleção de citações deve ocorrer após a extração de evidências. Exija trechos exatos do texto-fonte. Rejeite paráfrases geradas apresentadas como citações diretas.
Um registro de tema forte contém:
- um rótulo conciso;
- uma explicação em linguagem simples;
- uma citação representativa;
- uma exceção ou citação contraditória quando relevante;
- IDs de origem;
- contagens do corpus;
- confiança e limitações.
Pesquisas sobre sumarização guiada por aspectos e por opinião reforçam o valor de conectar os resumos a aspectos específicos e opiniões de apoio, em vez de produzir um resumo genérico não estruturado. Veja o benchmark MARS para sumarização de avaliações orientada por aspectos e o trabalho da Wayfair sobre sumarização fiel e abstrativa de avaliações de produtos.
Use um contrato de evidência no nível da afirmação
Uma contagem no nível do tema não basta quando um resumo contém várias afirmações distintas. Armazene um pacote de evidências para cada afirmação material:
{
  "claim_id": "claim-battery-cold-weather",
  "claim_text": "Cold-weather battery performance is a recurring complaint in the analyzed corpus.",
  "scope": {
    "product_id": "sku-123",
    "market": "US",
    "date_window": "2026-05-01/2026-07-31"
  },
  "supporting_review_ids": ["r-104", "r-318", "r-522"],
  "counterevidence_review_ids": ["r-091", "r-447"],
  "corpus_count": 742,
  "support_count": 18,
  "confidence": "medium",
  "allowed_wording": "recorrente no corpus analisado",
  "prohibited_wording": "afeta a maioria dos clientes"
}
Esse contrato dá ao gerador menos liberdade e ao avaliador mais alavancagem. Ele também permite que a equipe altere o modelo de redação sem reconstruir a camada de evidências.
Trate o texto das avaliações como entrada não confiável. O conteúdo do cliente pode conter instruções, texto copiado, URLs ou tentativas de manipular um sistema automatizado. A orientação da OWASP sobre prompt injection recomenda separar o conteúdo não confiável das instruções do sistema e limitar a autoridade do modelo. O texto das avaliações nunca deve poder alterar permissões de ferramentas, filtros do corpus, regras de avaliação ou configurações de publicação.
Critérios de aceitação da etapa 3
- Taxonomia versionada e esquema de extração.
- Registros de evidência por avaliação.
- Intervalos exatos da fonte para reivindicações materiais.
- Contradições preservadas, não suavizadas por média.
- Contagens de temas calculadas a partir dos registros, em vez de estimadas pelo gerador.
- Um caminho reproduzível da frase do resumo até a avaliação de origem.
Passo 4: Gere resumos fundamentados e avalie-os
Uma vez que a camada de evidências exista, o modelo de sumarização tem uma tarefa mais restrita: comprimir evidências estruturadas em um artefato útil para decisão, sem acrescentar conclusões sem समर्थन.
Dê ao gerador um contrato rigoroso
A instrução de geração deve definir:
- o público e a decisão;
- os campos de evidência permitidos;
- a estrutura de saída obrigatória;
- o formato de citação ou ID da fonte;
- a formulação para incerteza;
- as regras para evidência conflitante;
- inferências proibidas;
- o comprimento máximo;
- o que fazer quando a evidência for insuficiente.
Uma regra prática é: se uma afirmação não puder ser vinculada à evidência fornecida, omita-a ou rotule-a como hipótese.
Monte um conjunto de teste antes do lançamento
Crie um conjunto de avaliação representativo que inclua:
- lotes de avaliações grandes e pequenos;
- produtos positivos, negativos e mistos;
- temas esparsos;
- avaliações multilíngues;
- duplicatas e quase duplicatas;
- evidência contraditória;
- avaliações com sarcasmo ou linguagem ambígua;
- reclamações graves que exijam escalonamento;
- produtos com múltiplas variações ou casos de uso.
Inclua casos adversariais. Um sistema testado apenas em exemplos limpos e óbvios parecerá confiável até encontrar dados de produção.
Pontue a saída em cinco dimensões
Use uma rubrica de 1 a 5 para cada dimensão:
| Dimensão | Pergunta | Exemplo de falha |
|---|---|---|
| Fundamentação | Toda afirmação material é apoiada pela evidência fornecida? | O resumo inventa uma causa para a falha da bateria |
| Cobertura | O resumo inclui os temas e exceções relevantes para a decisão? | Ele omite uma reclamação de segurança de baixa frequência |
| Fidelidade | Ele preserva polaridade, escopo e incerteza? | “Algumas avaliações” vira “os clientes dizem consistentemente” |
| Utilidade | O usuário pretendido consegue tomar a próxima decisão mais rápido? | O resumo lista temas, mas não oferece segmentação nem evidência |
| Rastreabilidade | Um revisor consegue chegar aos registros subjacentes? | Contagens e citações não აქვთ IDs de स्रोत |
Não reduza a avaliação a uma única pontuação automática. Use verificações determinísticas para esquema, IDs de fonte, contagens e correspondência de citações; avaliação baseada em modelo para qualidades semânticas; e revisão humana para utilidade na decisão e casos de alto risco.
As melhores práticas de avaliação da OpenAI recomendam avaliações específicas da tarefa, conjuntos de dados representativos e avaliação contínua, em vez de depender de impressões informais. A documentação do Google Cloud para avaliação de resumos também separa qualidades como completude, correção e aderência.
Defina limites de lançamento
Defina limites antes de ver as pontuações finais. Por exemplo:
- zero citações diretas sem suporte;
- zero IDs de fonte ausentes para temas de alta prioridade;
- nenhuma afirmação de alto risco publicada sem revisão humana;
- pontuações mínimas de groundedness e cobertura no conjunto de teste;
- mismatch máximo de contagem permitido;
- abstenção explícita quando a evidência estiver abaixo do limite mínimo.
Os limites devem refletir o risco da decisão. Um resumo diário de orientação pode tolerar mais incerteza do que um resumo usado para uma investigação de recall de produto ou para uma afirmação pública.
Crie uma matriz de avaliação, não uma única pontuação de acurácia
Crie um conjunto de avaliação fixo que inclua exemplos comuns e casos de estresse deliberados. Cada falha de produção relevante deve se tornar um novo caso de regressão.
| Família de teste | Caso de exemplo | Condição de aprovação |
|---|---|---|
| Suporte de evidência | Resumo afirma um defeito recorrente | Cada afirmação mapeia para IDs de fonte válidos e formulação permitida |
| Cobertura | Corpus contém um tema dominante e dois temas minoritários | O tema dominante aparece; sinais minoritários materiais não são apagados |
| Contradição | Avaliações discordam por variante do produto | A saída separa as variantes em vez de fazer uma média entre elas |
| Evidência escassa | Apenas duas avaliações mencionam um tópico | O sistema se abstém ou rotula a evidência como escassa |
| Integridade da citação | A avaliação inclui pontuação incomum | A citação corresponde exatamente ao trecho de origem |
| Resistência a injeção | O texto da avaliação contém instruções para o modelo | As instruções são tratadas como conteúdo e não têm efeito de controle |
| Reprodutibilidade | O mesmo pacote de lançamento é executado novamente | A saída permanece dentro da tolerância de estabilidade definida |
| Conformidade com o esquema | O gerador omite um campo obrigatório | A validação falha antes da publicação |
O guia de melhores práticas de avaliação da OpenAI recomenda avaliações específicas da tarefa, registro de logs, automação sempre que possível e avaliação contínua. O princípio se aplica independentemente do fornecedor do modelo: defina o comportamento de que você precisa, teste-o em dados representativos e preserve as falhas que importam.
Para um gate formal de pré-lançamento, consulte a lista de verificação de testes de aceitação e handoff para resumo de avaliações com IA.
Critérios de aceitação da etapa 4
- Prompts versionados e configuração do modelo.
- Casos de teste representativos e adversariais.
- Julgamentos de referência escritos por humanos para uma parte do conjunto.
- Pontuações separadas de fundamentação, cobertura, fidelidade, utilidade e rastreabilidade.
- Limiares de release fixos e regras de escalonamento.
- Exemplos de falhas armazenados para testes de regressão.
Se você está avaliando software em vez de construir toda a stack, o guia de requisitos da ferramenta de análise de avaliações de clientes oferece uma checklist de capacidades mais abrangente.
Passo 5: Implante com monitoramento, versionamento e loops de feedback
Um sumarizador pode passar em uma avaliação de lançamento e ainda assim se degradar. O idioma das avaliações muda, os catálogos de produtos mudam, os campos de origem desaparecem, as taxonomias evoluem, os prompts sofrem deriva e as versões do modelo se comportam de forma diferente.
Trate o sistema implantado como um fluxo de trabalho analítico monitorado.
Registre o suficiente para reproduzir cada resumo
Armazene:
- consulta e definição de filtros do corpus;
- IDs das avaliações e horário do snapshot do corpus;
- versão da limpeza e da desduplicação;
- versão da taxonomia;
- modelo de extração e versão do prompt;
- modelo de geração e versão do prompt;
- saída e links de evidência;
- resultados da avaliação;
- edições humanas e estado de aprovação.
A reprodutibilidade importa quando uma parte interessada pergunta por que a conclusão deste mês difere da do mês passado.
Monitore o pipeline, não apenas o modelo
Acompanhe indicadores operacionais e de qualidade, como:
- falhas de ingestão e campos ausentes;
- taxa de duplicados;
- taxa de aspectos não classificados;
- taxa de extração com baixa confiança;
- taxa de falha no link de evidência;
- taxa de incompatibilidade de citações;
- erros de reconciliação de contagem;
- taxa de abstenção;
- taxa de edição humana;
- taxa de aceitação pelos revisores;
- tempo da ingestão até a saída pronta para decisão.
Um aumento repentino em aspectos “outros” pode indicar desvio na taxonomia. Uma queda nas contagens de temas pode ser um problema de ingestão da fonte, e não uma tendência real dos clientes.
Adicione três orçamentos operacionais:
- Orçamento de qualidade: a taxa máxima tolerada de alegações sem suporte, falta de evidência ou omissão grave.
- Orçamento de latência: o tempo máximo da disponibilidade da fonte até um resumo utilizável, incluindo tentativas पुनरadas e revisão humana.
- Orçamento de custo: minutos de ingestão, armazenamento, extração, geração, avaliação e revisores por unidade de decisão concluída.
A chamada de modelo mais barata ainda pode produzir o fluxo de trabalho mais caro se gerar mais verificação manual. Meça o custo de ponta a ponta por resumo aceito, não apenas os tokens.
Defina gatilhos de rollback antes do lançamento
O rollback deve ser automático ou estar imediatamente disponível quando:
- O volume da fonte cai inesperadamente ou um conector para de atualizar.
- A validação do esquema falha para campos de evidência obrigatórios.
- Reivindicações não suportadas excedem o orçamento de qualidade.
- Um tema de alta severidade é publicado sem a revisão exigida.
- Um modelo, prompt, taxonomia ou alteração de recuperação causa regressão no benchmark.
- As correções do revisor se concentram em um segmento, idioma ou variante do produto.
Rollback significa restaurar um pacote de versão conhecido, e não apenas alterar o prompt novamente. Mantenha juntos o identificador do modelo anterior, a versão do prompt, a taxonomia, as regras do corpus, a revisão do código e os resultados da avaliação. A checklist de lançamento em produção cobre modo shadow, incidentes e expansão controlada com mais detalhes.
Crie um loop de feedback do revisor
Capture por que um revisor altera ou rejeita um resumo. Use motivos estruturados como:
- reivindicação não suportada;
- tema importante ausente;
- polaridade incorreta;
- generalização enganosa;
- citação fraca;
- contagem incorreta;
- tema duplicado;
- próximo passo pouco claro;
- escalonamento necessário.
Transforme essas falhas em novos casos de avaliação. É assim que o sistema melhora sem depender de instruções vagas para “tornar o resumo melhor”.
Aplique gestão de risco ao caso de uso
O Perfil de IA Generativa do NIST enfatiza o gerenciamento de riscos ao longo do design, desenvolvimento, implantação e uso. Para resumo de avaliações, isso significa documentar limitações, testar modos de falha previsíveis, monitorar o comportamento em produção e alinhar os controles à consequência do erro. O mais amplo Framework de Gestão de Risco de IA do NIST fornece uma sequência operacional útil: governar a responsabilidade, mapear o caso de uso e as partes afetadas, medir qualidade e risco, e gerenciar problemas ao longo do tempo.
Critérios de aceitação da etapa 5
- Registro de versão de ponta a ponta.
- Painéis de qualidade e operacionais.
- Alertas para falhas de fonte, esquema e evidência.
- Feedback estruturado do revisor.
- Um teste de regressão adicionado para cada falha material.
- Um caminho de rollback para alterações de modelo, prompt, taxonomia e pipeline.
Um plano prático de lançamento de 30 dias
| Período | Objetivo | Entregável |
|---|---|---|
| Dias 1–5 | Definir o escopo e as regras de evidência | Declaração de decisão, esquema de saída, política de risco, conjunto de testes inicial |
| Dias 6–10 | Construir o pipeline do corpus | Registros rastreáveis, regras de normalização, log de deduplicação, relatório do corpus |
| Dias 11–17 | Construir a extração estruturada | Taxonomia, registros de evidência, verificações de citações, tratamento de contradições |
| Dias 18–24 | Gerar e avaliar | Contrato de resumo, rubrica de avaliação, revisão humana, limites de liberação |
| Dias 25–27 | Executar em modo sombra | Comparar os resultados gerados com o fluxo de trabalho humano atual sem alterar decisões |
| Dias 28–30 | Piloto assistido | Execução limitada em produção, painel, feedback dos revisores, simulação de rollback |
Mantenha o primeiro piloto restrito. Uma família de produto, um mercado, um responsável pela decisão e uma decisão recorrente lhe ensinarão mais do que um lançamento amplo com responsabilidade pouco clara.
No fim de 30 dias, tome uma de três decisões: ampliar o escopo, manter o escopo enquanto corrige lacunas específicas ou interromper o fluxo de trabalho. “Os resumos parecem úteis” não é uma decisão. Compare o piloto com os limites de liberação, os orçamentos operacionais, o tempo dos revisores e o processo de base que ele deveria melhorar.
Mapa de passagem de implementação
Use este mapa de passagem quando a checklist sair do planejamento e entrar nas tarefas de engenharia.
| Responsável | Recebe | Deve devolver | Pergunta bloqueadora |
|---|---|---|---|
| Líder de produto ou pesquisa | Contrato de decisão e esquema de saída | Caso de uso aprovado, não objetivos, tópicos de escalonamento | Que decisão muda se o resumo estiver errado? |
| Responsável pelos dados | Lista de fontes e política de retenção | Campos do manifesto do corpus, regras de exclusão/exportação, referências de fontes permitidas | É possível rastrear cada avaliação sem expor dados desnecessários? |
| Líder de engenharia | Esquemas do corpus e da evidência | Pipeline versionado, verificações de validação, registro de liberação, caminho de rollback | É possível reproduzir a execução após uma mudança de prompt ou de modelo? |
| Revisor de domínio | Taxonomia de aspectos e amostra de evidência | Regras de rotulagem, regras de contradição, definições de severidade | Quais sinais minoritários nunca devem ser diluídos na média? |
| Responsável pela QA | Conjunto de testes e rubrica de avaliação | Limites de liberação, suíte de regressão, log de falhas | Quais falhas bloqueiam o lançamento em vez de gerar trabalho de acompanhamento? |
| Responsável pelas operações | Requisitos de monitoramento | Painéis, alertas, responsáveis por incidentes, regras de lançamento assistido | Quem pausa o fluxo de trabalho quando a qualidade da evidência cai? |
A passagem só está completa quando cada responsável tiver um artefato de retorno. Uma nota de reunião que diz “aprovado” não é suficiente para uma checklist de implementação de resumo de avaliações com IA. Os artefatos precisam sobreviver à próxima versão, ao próximo revisor e à próxima mudança nos dados de origem.
Construir, comprar ou combinar?
A checklist se aplica quer você construa com modelos e APIs, compre uma plataforma dedicada ou combine ambos.
- Construir quando o fluxo de trabalho for estrategicamente único, a responsabilidade de engenharia for estável e a sua equipe conseguir manter o acesso aos dados, a avaliação, a segurança e o monitoramento.
- Comprar quando velocidade, inteligência de avaliações repetível, usabilidade para analistas e fluxos de trabalho existentes importarem mais do que infraestrutura personalizada.
- Combinar quando uma plataforma lidar com a coleta e a análise enquanto uma API ou aplicação interna entrega os resultados em um fluxo específico de produto, pesquisa ou relatório.
Ao comparar opções, execute o mesmo corpus definido em cada fluxo de trabalho. Verifique a rastreabilidade das evidências, o tratamento de contradições, o controle de taxonomia, o suporte à avaliação e a exportabilidade — não apenas o quão polido o resumo parece.
O VOC AI oferece suporte a fluxos de trabalho de análise de avaliações em Voice of Customer Analysis, Product Research com base em avaliações, análise de concorrentes e na Review Analysis API. O caminho certo depende de a sua necessidade imediata ser um fluxo de trabalho para analistas, um sistema de decisão recorrente ou uma integração de produto.
Checklist final de implementação
Antes do lançamento, confirme que você pode responder sim a todas as perguntas:
- Decisão: O resumo está vinculado a um usuário nomeado e a uma decisão recorrente?
- Não objetivos: O contrato especifica o que o resumo não pode estabelecer?
- Responsável: Há uma pessoa responsável por cada etapa de liberação?
- Corpus: Cada avaliação incluída pode ser rastreada até um registro de origem estável?
- Manifesto: É possível reconstruir o conjunto de dados exato e os filtros?
- Segmentação: As diferenças de produto, mercado, idioma, avaliação e tempo são preservadas quando relevante?
- Deduplicação: As remoções são registradas sem apagar repetições legítimas?
- Evidência: Toda afirmação material se vincula a evidências no nível da avaliação?
- Contraevidência: Os sinais minoritários e conflitantes estão visíveis?
- Afirmações: As observações do corpus estão separadas de afirmações populacionais ou causais?
- Citações: As citações são exatas, atribuíveis e protegidas contra injeção de prompt?
- Esquema: A saída inválida falha antes da publicação?
- Avaliação: Você testou fundamentação, cobertura, fidelidade, utilidade e rastreabilidade?
- Testes de estresse: O benchmark inclui exemplos esparsos, contraditórios, segmentados e adversariais?
- Limiar: Os critérios de liberação e de abstenção estão explícitos?
- Risco: Tópicos de alto risco acionam revisão humana?
- Versionamento: Você consegue reproduzir um resumo após uma mudança de modelo, prompt, taxonomia ou corpus?
- Orçamentos: Os limites de qualidade, latência, custo e tempo do revisor são medidos de ponta a ponta?
- Rollback: A equipe consegue restaurar rapidamente um pacote de liberação conhecido?
- Segurança: O texto não confiável das avaliações é separado de instruções, ferramentas e controles de publicação?
- Aprendizado: Toda correção material se torna um teste de regressão ou uma atualização de regra?
A implementação está pronta quando a evidência resiste ao escrutínio — não quando a redação soa fluente.
Se você estiver avaliando uma plataforma em vez de construir a pilha completa, aplique o mesmo checklist durante a aquisição. Peça ao fornecedor que demonstre rastreabilidade da evidência, controles do corpus, exportações, avaliação, limites de segurança e comportamento de rollback usando seu próprio conjunto de testes. O checklist de avaliação de fornecedores para resumo de avaliações com IA fornece uma tabela de pontuação estruturada.
Trate este resumo de avaliações com IA: checklist de implementação como o hub. Use as páginas complementares quando a equipe precisar de testes de QA mais profundos, artefatos de engenharia, controles de segurança, handoff de aceitação, pontuação de fornecedores ou operações de produção.
Perguntas frequentes
O que é resumo de avaliações com IA?
Resumo de avaliações com IA é o uso de modelos de linguagem ou sistemas relacionados de processamento de linguagem natural para comprimir um conjunto definido de avaliações de clientes em temas, conclusões ou resultados orientados à decisão. Um fluxo de trabalho de produção deve preservar a rastreabilidade da origem, a incerteza, as contradições e os limites do corpus.
Quantas avaliações são necessárias para a sumarização com IA?
Não existe um mínimo universal. O limiar adequado depende da decisão, da segmentação do produto, do comprimento das avaliações, da diversidade de temas e do nível de confiança necessário. Sempre informe o tamanho do corpus analisado e evite conclusões fortes quando as evidências forem escassas.
Os resumos de IA devem incluir citações de clientes?
Sim, quando as citações melhoram a verificação e o contexto. As citações devem ser trechos exatos da fonte, com IDs de avaliação ou links estáveis. Nunca apresente uma paráfrase gerada como uma citação direta.
Como você mede a precisão do resumo de avaliações?
Meça várias dimensões: fundamentação, cobertura, fidelidade, utilidade e rastreabilidade. Combine verificações determinísticas, avaliação baseada em modelo e revisão humana. Precisão não é uma única pontuação, porque um resumo gramaticalmente correto ainda pode omitir evidências importantes ou exagerar um padrão fraco.
O que deve estar no primeiro ticket de engenharia?
O primeiro ticket deve criar o contrato de decisão, o manifesto do corpus, o esquema de evidências, o esquema de saída e as verificações de validação antes que qualquer resumo de produção seja gerado. A seleção do modelo pode acontecer depois que a equipe souber quais evidências o sistema precisa preservar.
Um resumo de avaliações pode provar quão comum é um problema?
Ele pode descrever a frequência dentro do corpus de avaliações analisado. Ele não estima automaticamente a prevalência entre todos os clientes, não explica causalidade nem prevê impacto nos negócios. Essas questões exigem dados adicionais e um método projetado para elas.