Aktualisiert am 9. August 2026.
KI-Rezensionszusammenfassungen wirken in einer Demo einfach: Man sendet einen Stapel Rezensionen an ein Modell und bittet es um die wichtigsten Themen. In der Produktion erzeugt dieser Shortcut eine vertraute Reihe von Problemen: doppelte Belege, vage Themen, fehlende Minderheitskritik, unbelegte Behauptungen und Zusammenfassungen, die niemand prüfen kann.
Eine zuverlässige Implementierung braucht mehr als einen Prompt. Sie braucht eine kontrollierte Pipeline, die die Entscheidung definiert, die Belege vorbereitet, die Analyse strukturiert, jede wichtige Behauptung verifiziert und die Qualität nach dem Start überwacht.
Diese Implementierungs-Checkliste für KI-Rezensionszusammenfassungen bietet Produkt-, E-Commerce-, CX- und Forschungsteams einen praktischen Weg von Rohdaten aus Rezensionen zu entscheidungsreifen Zusammenfassungen. Sie behandelt die Build-Reihenfolge, die Mindest-Artefakte, die Abnahmetests und die betrieblichen Entscheidungen, die Teams oft zu spät entdecken: Verantwortlichkeiten, Korpusgröße, Belegverträge, Freigabeschwellen, Latenz- und Kostenkontrollen sowie Rollback-Kriterien.
Verwenden Sie sie als Implementierungs-Checkliste für KI-Rezensionszusammenfassungen, wenn die Frage nicht mehr lautet: „Kann ein Modell Rezensionen zusammenfassen?“, sondern: „Kann unser Team einen Zusammenfassungs-Workflow ausliefern, der Audit, Korrekturen und die nächste Änderung der Quelldaten übersteht?“
Das Ziel ist nicht, dass ein Modell einen überzeugenden Absatz schreibt. Das Ziel ist, ein reproduzierbares Entscheidungssystem zu schaffen, in dem jede wichtige Aussage auf Kundennachweise zurückgeführt werden kann.
Was sich in dieser Implementierungs-Checkliste geändert hat
Dieses Update vom 9. August fügt eine sprintbereite Implementierungsebene für Teams hinzu, die die Architektur bereits verstehen, sie aber in Engineering-Tickets umsetzen müssen. Die frühere Checkliste erklärte die Evidenz-Pipeline; diese Version ergänzt:
- ein Build-Backlog mit 10 Tickets;
- eine Definition-of-Done-Matrix für jede Implementierungsebene;
- eine Release-Paket-Vorlage, die an einen Jira-, Linear- oder Notion-Übergabeprozess angehängt werden kann;
- einen Pfad von der Pilotabnahme zu Monitoring, Rollback und Lieferantenbewertung.
Verwenden Sie diesen Abschnitt, wenn das Team von „wir sind uns bei dem Design einig“ zu „was genau muss existieren, bevor wir Produkt-, CX- oder E-Commerce-Operatoren auf die Zusammenfassung vertrauen lassen?“ übergeht.
Die nachstehende Implementierungs-Checkliste für KI-Rezensionszusammenfassungen ist so strukturiert, dass jeder Abschnitt zu einem Ticket, einem Abnahmetest oder einem Release-Artefakt werden kann.
Das Implementierungs-Backlog mit 10 Tickets
Eine nützliche Implementierungs-Checkliste für KI-Rezensionszusammenfassungen sollte zu Tickets werden, nicht zu Besprechungsnotizen. Beginnen Sie mit diesen 10 Arbeitspaketen und halten Sie jedes Ticket an ein Rückgabe-Artefakt gebunden.
| Ticket | Verantwortliche Person | Lieferergebnis | Definition von erledigt |
|---|---|---|---|
| 1. Entscheidungsvertrag | Produkt- oder Forschungsleitung | Benannte Zielgruppe, wiederkehrende Entscheidung, Ausgabeschema, Nicht-Ziele | Ein Reviewer kann erkennen, welche Entscheidung die Zusammenfassung unterstützt und welche Aussagen sie nicht machen darf |
| 2. Korpus-Manifest | Datenverantwortliche Person | Quellenliste, Filter, stabile IDs, Gründe für ausgeschlossene Einträge, Versions-Hash | Der genaue Review-Satz kann rekonstruiert werden, ohne eine ungenaue Abfrage erneut auszuführen |
| 3. Review-Normalisierung | Verantwortliche Person für Daten oder Engineering | Bewahrter Rohtext, normalisierte Metadaten, Sprachrichtlinie, Deduplizierungsprotokoll | Bereinigungsänderungen sind dokumentiert und der ursprüngliche Review-Text bleibt erhalten |
| 4. Aspekt-Taxonomie | Fachliche Prüferin / fachlicher Prüfer | Versionierte Labels, Beispiele, Behandlung von „andere“, Regeln zur Schweregradbewertung | Zwei Reviewer können die Labels konsistent genug für die Zielentscheidung anwenden |
| 5. Evidenzextraktion | Verantwortliche Person für Engineering | Aspekt, Aussage, Sentiment, Span, Konfidenz, Quell-ID auf Review-Ebene | Jede extrahierte Aussage verweist zurück auf einen abrufbaren Quelldatensatz |
| 6. Claim-Ledger | QA-Verantwortliche Person | Claim-ID, Unterstützungs-IDs, Gegenbeleg-IDs, zulässige Formulierung | Wesentliche Zusammenfassungsaussagen können einzeln akzeptiert, bearbeitet oder abgelehnt werden |
| 7. Grounded Generation | Verantwortliche Person für Engineering | Prompt oder Vorlage, die nur genehmigte Evidenzfelder verwendet | Unbelegte Ursachen, Marktverbreitung und Umsatzwirkung sind konstruktiv ausgeschlossen |
| 8. Evaluierungssuite | QA-Verantwortliche Person | Goldenes Set, Challenge-Set, aktuelles Produktions-Sample, Schwellenwerte | Groundedness, Abdeckung, Treue, Nützlichkeit und Nachvollziehbarkeit werden getrennt bewertet |
| 9. Release-Paket | Verantwortliche Person für den Betrieb | Korpusversion, Taxonomieversion, Modell-/Prompt-Version, Evaluationsergebnisse, Genehmigende Person | Eine veröffentlichte Zusammenfassung kann reproduziert oder zurückgerollt werden |
| 10. Monitoring-Schleife | Verantwortliche Person für den Betrieb | Metriken zu Quelle, Schema, Evidenz, Qualität, Kosten und Reviewer-Feedback | Das Team kann Drift erkennen, die Veröffentlichung pausieren und aus Fehlern Regressionen ableiten |
Fassen Sie diese nicht zu einem einzigen Ticket „Zusammenfassung erstellen“ zusammen. Die Implementierung ist nur dann zuverlässig, wenn Korpussteuerung, Evidenzsteuerung, Generierung, Bewertung und Betrieb so getrennt sind, dass sie überprüft werden können.
Wenn die Implementierungs-Checkliste für KI-Rezensionszusammenfassungen nicht benennen kann, welches Artefakt jede verantwortliche Person zurückgibt, dann diskutiert das Team noch ein Konzept, statt einen kontrollierten Workflow zu implementieren.
Definition von erledigt nach Implementierungsebene
Verwenden Sie diese Matrix als Release-Gate vor einem Pilotlauf. Ein fehlender Punkt bedeutet nicht immer, dass das Projekt gestoppt werden sollte, aber er bedeutet, dass die verantwortliche Person für den Launch das Risiko ausdrücklich akzeptieren sollte.
| Ebene | Muss vor dem Pilotbetrieb vorhanden sein | Blockiert die Produktion, wenn fehlend |
|---|---|---|
| Entscheidung | Ein primärer Nutzer, eine Entscheidung, ein Ausgabevertrag | Ja. Ohne dies kann QA nicht feststellen, ob die Antwort nützlich ist |
| Korpus | Stabile IDs, Quellmetadaten, Filter, Zeitfenster, ausgeschlossene Anzahlen | Ja. Ohne dies kann die Zusammenfassung nicht geprüft werden |
| Belege | Aspekt, Behauptung, Polarität, exakter Ausschnitt, Quell-ID, Gegenbelege | Ja für entscheidungsrelevante Zusammenfassungen; nur optional für informelle Erkundungen |
| Generierung | Erforderliche Abschnitte, Zitationsformat, Regeln für Unsicherheit, verbotene Behauptungen | Ja. Andernfalls kann das Modell Belege in eine ungestützte Erzählung verwandeln |
| Bewertung | Repräsentativer Satz, adversarielle Fälle, Bewertungsraster, harte Stopp-Schwellen | Ja. Eine Prüfung nach dem Motto „wirkt vernünftig“ ist kein Freigabekriterium |
| Freigabe | Versionierter Korpus, Taxonomie, Prompt, Modell, Eval-Ergebnis, Genehmiger | Ja. Ohne Freigabepaket wird ein Rollback zum Rätselraten |
| Monitoring | Qualitäts-, Quellen-, Schema-, Belegverknüpfungs-, Reviewer-Korrektur-Metriken | Ja für wiederkehrende Produktionseinsätze; optional für einmalige interne Analysen |
Die riskanteste Auslassung ist meist nicht die Modellauswahl. Es ist eine nicht versionierte Belegebene. Wenn das Team nicht beantworten kann: „Welche Bewertungen stützen diesen Satz?“, ist die Implementierung nicht produktionsreif.
Das ist der einfachste Bestehens-/Nichtbestehens-Test für eine AI review summarization implementation checklist: Jeder wichtige Satz sollte einen Weg zurück zu den Quellbelegen haben.
Scorecard zur Implementierungsbereitschaft
Bevor Sie ein Modell oder einen Anbieter auswählen, bewerten Sie den vorgeschlagenen Workflow in jeder Dimension von 0 bis 2: 0 bedeutet undefiniert, 1 bedeutet teilweise definiert und 2 bedeutet testbar und verantwortet.
| Dimension | 0: Undefiniert | 1: Teilweise | 2: Bereit |
|---|---|---|---|
| Entscheidung | „Bewertungen zusammenfassen“ | Allgemeiner Anwendungsfall | Benannter Nutzer, wiederkehrende Entscheidung, explizite Nicht-Ziele |
| Daten | Unbegrenzter Text-Dump | Grundlegende Filter | Versioniertes Korpus-Manifest mit stabilen Bewertungs-IDs |
| Belege | Nur Fließtext | Manuell hinzugefügte Zitate | Beleg-IDs auf Behauptungsebene und Widerspruchsdatensätze |
| Bewertung | „Sieht gut aus“ | Ad-hoc-Prüfung | Festes Testset, Rubrik, Schwellenwerte, Regressionstests |
| Betrieb | Einmaliges Skript | Geplanter Job | Verantwortliche, Monitoring, Eskalation, Rollback, Audit-Log |
| Ökonomie | Keine Schätzung | Token-Schätzung | End-to-End-Kosten, Latenz, Reviewer-Zeit, Fehlerbudget |
Eine Punktzahl unter 8 von 12 bedeutet in der Regel, dass das Team noch einen Prototypen testet. Eine Punktzahl von 8–10 kann einen engen, unterstützten Pilotbetrieb tragen. Eine Punktzahl von 11–12 ist ein vernünftiger Ausgangspunkt für kontrollierte Produktion – kein Beweis dafür, dass das System fertig ist.
Verwenden Sie diese Scorecard früh in der AI review summarization implementation checklist, damit das Team fehlende Kontrollen identifizieren kann, bevor Generierungs-Prompts geschrieben werden.
Referenzarchitektur
Ein Produktions-Workflow sollte sechs Verantwortlichkeiten trennen, auch wenn eine Plattform mehrere davon übernimmt:
- Ingestion: Rezensionen erfassen und Quellmetadaten bewahren.
- Corpus Control: den Datensatz filtern, normalisieren, deduplizieren, segmentieren und versionieren.
- Evidence Extraction: Aspekte, Aussagen, Sentiment, Zitate, Ausnahmen und Quell-IDs identifizieren.
- Summary Generation: nur freigegebene Evidenzdatensätze in ein definiertes Ausgabeschema überführen.
- Evaluation: deterministische Prüfungen, modellgestützte Bewerter und bei Bedarf menschliche Überprüfung ausführen.
- Delivery and Monitoring: das Ergebnis veröffentlichen, das Release-Paket protokollieren, Korrekturen erfassen und Drift erkennen.
Die wichtigste architektonische Grenze liegt zwischen Evidence Extraction und Prosa-Generierung. Wenn das Modell, das die Zusammenfassung schreibt, auch frei entscheiden darf, was die Evidenz war, werden unbelegte Aussagen schwer zu erkennen. Halten Sie eine strukturierte Evidenzschicht vor, die unabhängig geprüft werden kann.
KI-Rezensionszusammenfassung: Meilensteine der Implementierungs-Checkliste
Wenn das Team nur zwei Wochen hat, beginnen Sie nicht mit dem Tuning des Modells. Erstellen Sie die kleinste Pipeline, die belegen kann, woher jede Aussage stammt.
| Implementierungsschicht | Lieferumfang der ersten Version | Nicht ausliefern, bevor |
|---|---|---|
| Entscheidungsvertrag | Ein benannter Benutzer, eine wiederkehrende Entscheidung, ein Ausgabeschema | Dasselbe Rezensionspaket je nach Fragesteller eine andere Antwort erzeugt |
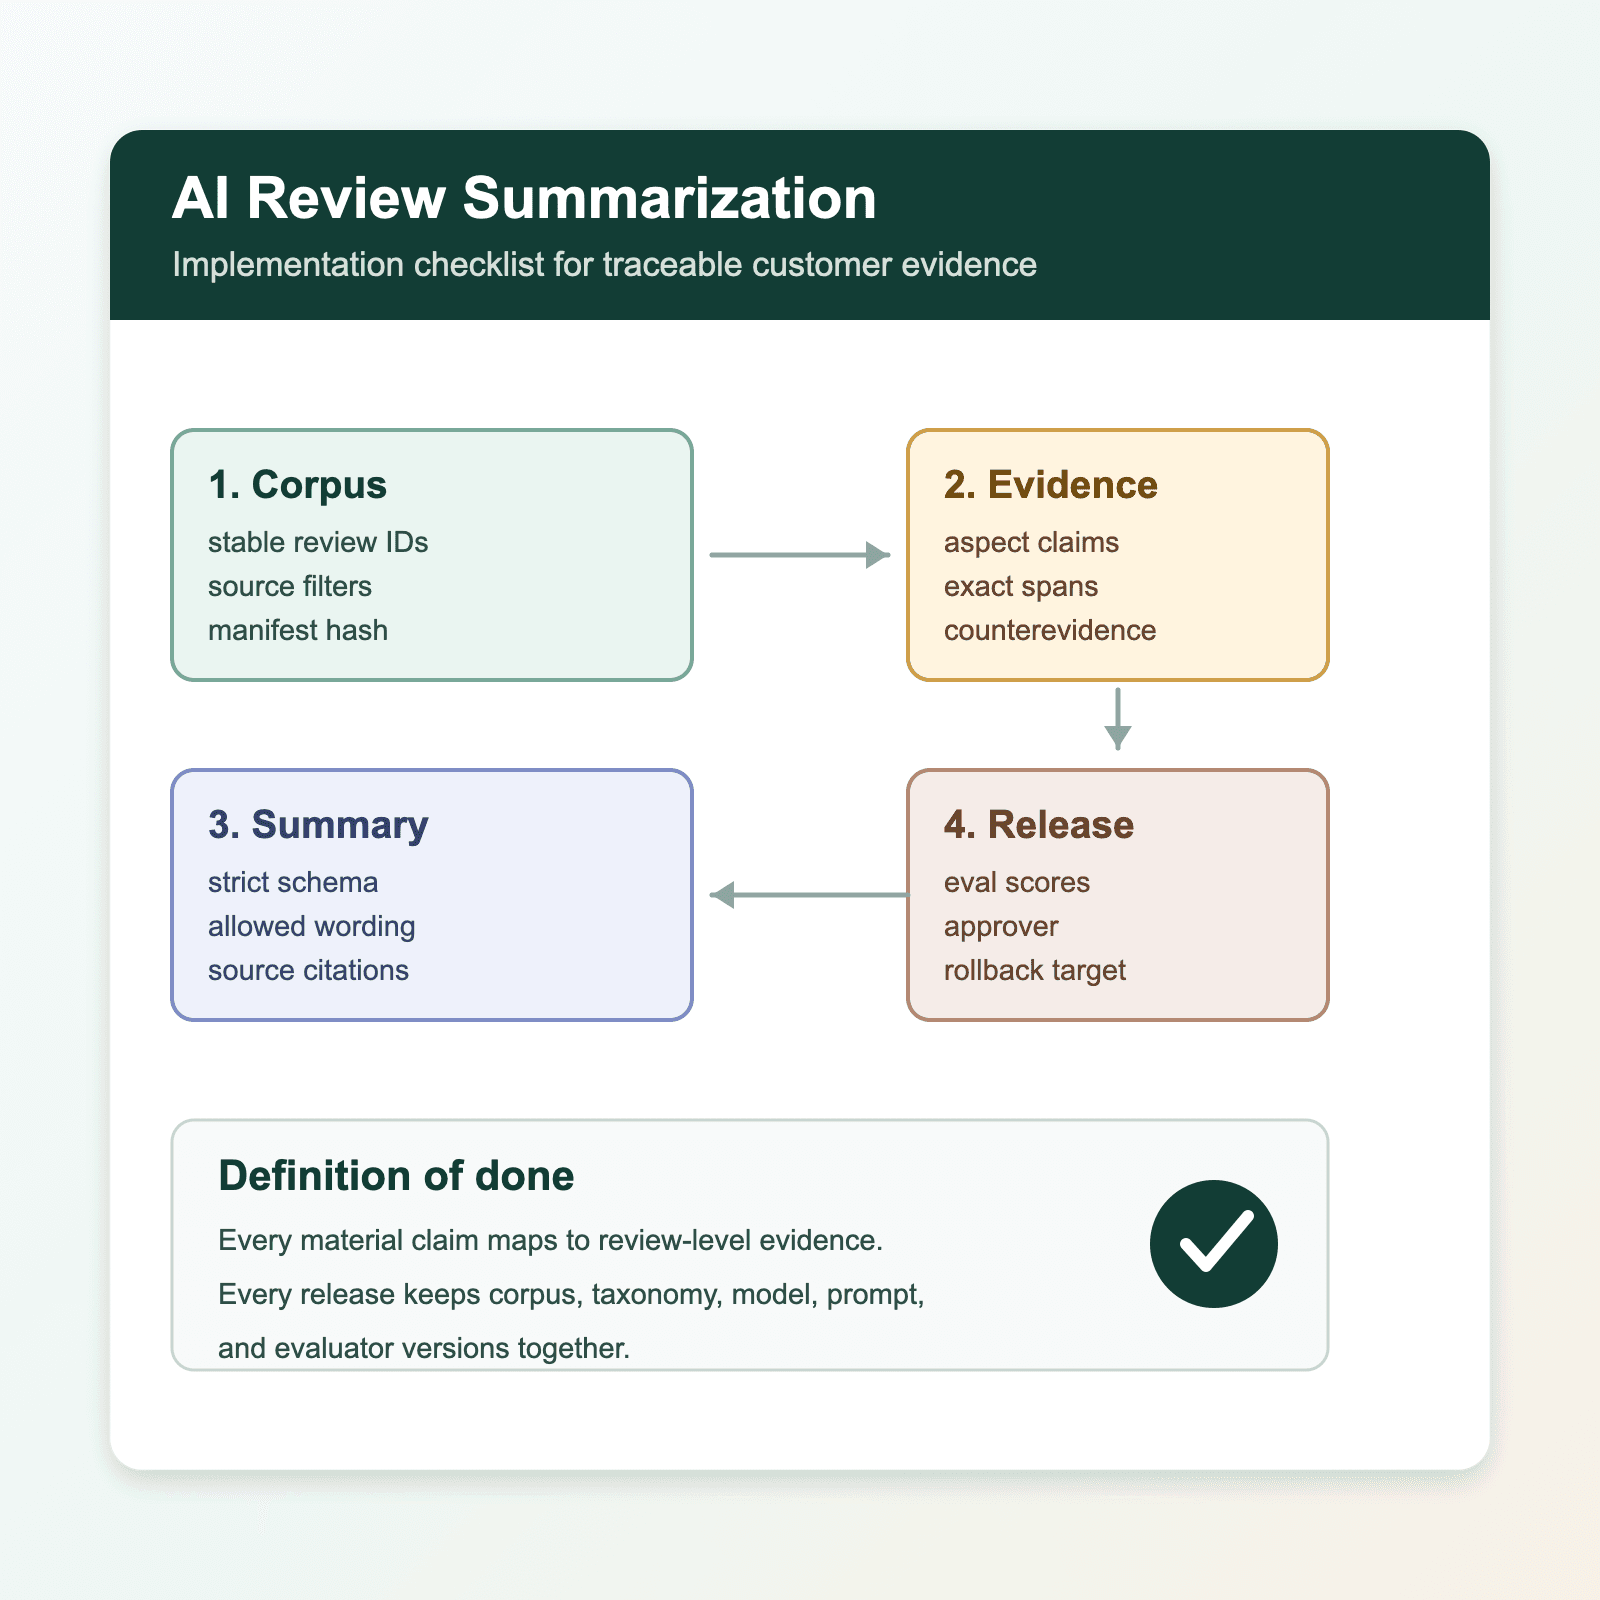
| Corpus-Manifest | Stabile Review-IDs, Quellfelder, Filter, Gründe für ausgeschlossene Anzahlen, Versions-Hash | Ein Prüfer den analysierten Datensatz nicht rekonstruieren kann |
| Evidence-Tabelle | Aspekt, Aussage, Polarität, exakter Ausschnitt, Quell-ID, Konfidenz, Widerspruchsflagge | Themen nur als generierte Prosa existieren |
| Summary-Template | Erforderliche Abschnitte, Evidenz-Links, Formulierungen für Unsicherheit, verbotene Aussagen | Das Modell unbelegte Ursachen, Marktverbreitung oder geschäftliche Auswirkungen einführen kann |
| Evaluierungsset | Repräsentative Rezensionen plus spärliche, widersprüchliche, doppelte, mehrsprachige und adversarielle Fälle | QA auf einer „wirkt plausibel“-Prüfung basiert |
| Release-Aufzeichnung | Corpus-Version, Taxonomie-Version, Modell- und Prompt-Version, Eval-Scores, Freigabeverantwortlicher, Rollback-Ziel | Das Team eine veröffentlichte Zusammenfassung nicht reproduzieren oder zurückrollen kann |
Das ist die unterste Ebene für die Implementierung. Die umfassendere QA-Checkliste für KI-Rezensionszusammenfassungen, die Checkliste für Engineering-Artefakte, die Checkliste für die Abnahmeprüfung und die Checkliste für den Produktions-Rollout vertiefen jede Schicht, nachdem die grundlegende Pipeline real ist.
Für eine erste Veröffentlichung sollte die Implementierungs-Checkliste für KI-Rezensionszusammenfassungen enger gefasst sein als die Roadmap. Liefern Sie einen Entscheidungs-Workflow aus, der geprüft werden kann, bevor auf weitere Produkte, Märkte oder Teams ausgeweitet wird.
Die fünfstufige Checkliste auf einen Blick
| Schritt | Umsetzung | Abnahmetest |
|---|---|---|
| 1. Die Entscheidung definieren | Umfang, Nutzer, Ausgabevertrag, Belegeinheit | Ein Prüfer kann erklären, welche Entscheidung die Zusammenfassung unterstützt — und welche nicht |
| 2. Den Rezensionskorpus vorbereiten | Quellfelder, Normalisierung, Deduplizierung, Filter, Sprachrichtlinie | Jede einbezogene Rezension hat eine stabile ID und kann zu ihrer Quelle zurückverfolgt werden |
| 3. Strukturierte Belege extrahieren | Aspekt-Taxonomie, Sentiment, Aussagen, Zitate, Ausnahmen | Themen werden aus Datensätzen auf Rezensionsbasis zusammengestellt, nicht aus einem einzelnen undurchsichtigen Prompt erfunden |
| 4. Zusammenfassungen erzeugen und bewerten | Geerdete Generierung, Zitate, Testset, Bewertungsrubrik, manuelle QA | Wesentliche Aussagen sind belegt, wichtige Belege sind abgedeckt, und Unsicherheit ist sichtbar |
| 5. Bereitstellen und überwachen | Versionierung, Drift-Prüfungen, Feedback-Schleife, Eskalationsregeln | Das Team kann Qualitätsverschlechterungen erkennen und jede veröffentlichte Zusammenfassung reproduzieren |
Betrachten Sie diese nicht als fünf Tipps zum Schreiben von Prompts. Jeder Schritt ist ein Qualitätsgate. Wenn ein Gate fehlschlägt, sollte die Pipeline stoppen oder die Ausgabe zur Prüfung markieren.
Die Implementierungs-Checkliste für KI-Rezensionszusammenfassungen funktioniert am besten, wenn diese Gates nach Möglichkeit automatisiert sind und dort von Menschen verantwortet werden, wo Urteilsvermögen erforderlich ist.
Schritt 1: Die Entscheidung und den Ausgabevertrag definieren
Der erste Implementierungsfehler besteht darin, mit „Fasse diese Rezensionen zusammen“ zu beginnen. Diese Anweisung sagt nicht, wer die Ausgabe verwenden wird, welche Entscheidung sie unterstützen soll oder wie viel Beleg ausreichend ist.
Beginnen Sie mit einer begrenzten Entscheidungsbeschreibung:
Fasse [Rezensionssatz] zusammen, damit [Entscheidungsverantwortlicher] [spezifische Wahl] innerhalb von [Zeitfenster] treffen kann, während [erforderliche Belege und Unsicherheit] erhalten bleiben.
Beispiele:
- Fasse aktuelle Ein- und Zwei-Sterne-Bewertungen zusammen, damit eine Qualitätsleitung Beschwerdetrends identifizieren kann, die eine Untersuchung verdienen.
- Vergleiche Bewertungen für drei konkurrierende Produkte, damit ein Produktmanager Funktionslücken für die Validierung eingrenzen kann.
- Fasse Bewertungen nach Anwendungsfall zusammen, damit ein Marketingteam testen kann, ob Kunden das Produkt anders beschreiben als die aktuelle Positionierung.
Definieren Sie dann einen Ausgabevertrag. Ein nützlicher Vertrag legt Folgendes fest:
- Analyseeinheit: Produkt, SKU, Variante, Markt, Segment, Bewertungsband oder Zeitraum.
- Erforderliche Felder: Thema, Beschreibung, Evidenzanzahl, Beispielzitate, Quell-IDs, Sentiment, betroffener Segment und Konfidenz sowie Ausnahmen.
- Verbotene Behauptungen: Verbreitung außerhalb des analysierten Korpus, kausale Schlussfolgerungen, Schätzungen der Fehlerquote oder Umsatzauswirkungen ohne separate Evidenz.
- Mindest-Evidenz: die Schwelle, ab der ein Thema angezeigt oder als wiederkehrend gekennzeichnet wird.
- Unsicherheitssprache: wie das System spärliche, widersprüchliche oder evidenzschwache Aussagen wiedergibt.
- Eskalationsregeln: welche Themen immer eine menschliche Prüfung erfordern, etwa Sicherheits-, Rechts-, Medizin-, Datenschutz- oder schwerwiegende Produktfehlerbehauptungen.
Dieser Vertrag verhindert, dass ein ansprechender Absatz zum ganzen Produkt wird. Die Zusammenfassung ist nur die Präsentationsschicht; der darunterliegende Evidenzdatensatz ist das führende System.
In der Praxis ist der Entscheidungsvertrag das erste Artefakt in der Implementierung-Checkliste für KI-Rezensionszusammenfassungen, weil er das Korpus, das Evidenzschema, das Bewertungsraster und die Eskalationsrichtlinie bestimmt.
Akzeptanzkriterien für Schritt 1
- Ein benanntes Publikum und eine primäre Entscheidung.
- Explizite Ein- und Ausschlussregeln.
- Ein maschinenlesbares Ausgabeschema.
- Eine Liste von Behauptungen, die das System niemals allein aus Rezensionen ableiten darf.
- Eine Richtlinie für die menschliche Prüfung bei risikoreichen oder unsicheren Ausgaben.
Verantwortliche vor der Implementierung zuweisen
KI-Rezensionszusammenfassungen überschneiden Produkt, Daten, Engineering, Fachwissen und Betrieb. Eine leichtgewichtige Verantwortungsmatrix verhindert, dass Qualitätsarbeit zur „Aufgabe des Prompt Engineers“ wird.
| Verantwortung | Zuständige Person | Erforderliche Entscheidung |
|---|---|---|
| Anwendungsfall-Umfang | Produkt- oder Forschungsleitung | Welche Entscheidung die Zusammenfassung beeinflussen darf |
| Quellenzugriff und Aufbewahrung | Datenverantwortliche Person | Was erfasst, gespeichert, gelöscht und exportiert werden darf |
| Taxonomie- und Evidenzregeln | Fachliche Leitung | Was als Thema, Ausnahme oder gestützte Behauptung zählt |
| Pipeline und Versionierung | Technische Leitung | Wie Läufe reproduziert und zurückgerollt werden |
| Bewertung und Freigabe | Qualitätsverantwortliche Person | Welche Schwellen die Veröffentlichung blockieren |
| Incident Response | Betriebsverantwortliche Person | Wer pausiert, untersucht, kommuniziert und wiederherstellt |
In einem kleinen Team kann eine Person mehrere Rollen innehaben. Entscheidend ist, dass jede Freigabestufe einen benannten Entscheidungsträger hat. Für ein umfassenderes Übergabepaket verwenden Sie die Checkliste für technische Artefakte der KI-Rezensionszusammenfassung.
Schritt 2: Einen sauberen, nachvollziehbaren Rezensionskorpus aufbauen
Die Modellqualität kann einen undefinierten Datensatz nicht reparieren. Erstellen Sie vor der Zusammenfassung einen Datensatz auf Rezensionsebene, der Bereinigung, Analyse und Audit übersteht.
Ein praktisches Minimal-Schema sieht so aus:
{
  "review_id": "stable-source-id",
  "source": "marketplace-or-channel",
  "product_id": "product-or-sku",
  "variation": "size-color-model",
  "market": "US",
  "language": "en",
  "rating": 2,
  "review_date": "2026-07-01",
  "title": "Bewertungstitel",
  "body": "Bewertungstext",
  "verified_status": "vom Quellsystem bereitgestellter Wert",
  "source_url": "zulässige-Quellenreferenz",
  "ingested_at": "Pipeline-Zeitstempel"
}
Fügen Sie für jeden Lauf ein Korpus-Manifest hinzu. Das Manifest sollte die Abfrage oder Quellanfrage, den Erfassungszeitstempel, Filter, Sprachen, Produkte oder SKUs, das Datumsfenster, die einbezogene Anzahl, die Anzahl der ausgeschlossenen Einträge nach Grund, die Deduplizierungsmethode sowie einen Hash oder eine unveränderliche Versionskennung erfassen. So können zwei Personen dieselbe grundlegende Frage beantworten: „Welche Bewertungen hat diese Zusammenfassung tatsächlich analysiert?“
Bemessen Sie das Korpus an der Entscheidung
Es gibt keine universelle Mindestanzahl an Bewertungen. Definieren Sie die ausreichende Menge stattdessen nach Segment und Entscheidungsrisiko.
| Anwendungsfall | Bessere Frage zur ausreichenden Menge | Häufiger Fehler |
|---|---|---|
| Beschwerdetriage | Haben wir jedes priorisierte SKU, jeden Markt und jedes aktuelle Zeitfenster abgedeckt? | Ein großes Altbestand-Korpus verdeckt ein neues Problem |
| Feature-Entdeckung | Bleiben Themen über Resamples und Kundensegmente hinweg stabil? | Ein lautes Segment wird zur Produkt-Roadmap |
| Wettbewerbsvergleich | Sind Produkte, Zeiträume, Bewertungsmischungen und Varianten vergleichbar? | Eine andere Korpuszusammensetzung erzeugt einen falschen Sieger |
| Positionierungsforschung | Treten Use-Case-Formulierungen bei unabhängigen Rezensenten wiederholt auf? | Einprägsame Formulierungen werden für ein breites Muster gehalten |
| Executive-Reporting | Lässt sich jede Headline mit einem festen Berichtszeitraum abgleichen? | Der Nenner ändert sich zwischen Berichten |
Verwenden Sie geschichtete Stichproben, wenn das vollständige Korpus für die Bewertung zu groß ist. Bewahren Sie seltene, aber folgenreiche Bewertungen auf – etwa Sicherheits- oder schwere Ausfallberichte –, selbst wenn sie in einer frequenzbasierten Stichprobe verschwinden würden.
Fügen Sie geschäftsspezifische Felder nur dann hinzu, wenn sie die Analyse verbessern. Mehr Spalten erzeugen nicht automatisch bessere Evidenz.
Normalisieren, ohne Bedeutung zu löschen
Normalisieren Sie Felder wie Daten, Bewertungen, Gebietsschemacodes, Produktkennungen und Leerzeichen. Bewahren Sie den ursprünglichen Bewertungstext zusammen mit jeder bereinigten Version auf. Wenn Sie Bewertungen übersetzen, behalten Sie Folgendes bei:
- die ursprüngliche Sprache;
- den ursprünglichen Text;
- den übersetzten Text;
- die Übersetzungsmethode und -version;
- eine Kennzeichnung für Passagen, die möglicherweise eine Prüfung in der Originalsprache erfordern.
Standardisieren Sie Rechtschreibung, Slang, Produkt-Spitznamen oder Gebrauchsformulierungen nicht stillschweigend weg. Diese Details können die wertvollste Kundensprache enthalten.
Sorgfältig deduplizieren
Exakte Duplikate sind einfach. Nahezu-Duplikate sind schwieriger, da syndizierte Bewertungen, kopierte Bewertungen, kurze allgemeine Kommentare und wiederholte Vorlagen ähnlich aussehen können.
Verwenden Sie eine mehrschichtige Deduplizierungsrichtlinie:
- Gleichen Sie stabile Quell-IDs ab.
- Gleichen Sie normalisierten, exakten Text innerhalb desselben Produkts und Marktes ab.
- Markieren Sie Datensätze mit hoher Ähnlichkeit zur Prüfung, anstatt sie automatisch zu löschen.
- Protokollieren Sie den Deduplizierungsgrund und den beibehaltenen kanonischen Datensatz.
Das Ziel ist kein magisch „sauberer“ Datensatz. Es ist ein dokumentierter Korpus, dessen Grenzen erklärbar sind.
Trennen Sie Korpus-Häufigkeit von Marktprävalenz
Wenn 18 % der enthaltenen Rezensionen Schwierigkeiten bei der Einrichtung erwähnen, können Sie berichten, dass 18 % des analysierten Korpus das Thema erwähnen, vorausgesetzt, die Kodierung ist zuverlässig. Sie können daraus nicht automatisch schließen, dass 18 % aller Kunden das Problem erleben.
Rezensionen sind eine selbst ausgewählte Evidenzquelle. Nutzen Sie sie, um Muster, Sprache, Widersprüche und Untersuchungspunkte zu finden — nicht, um unbelegte Populationsschätzungen vorzunehmen.
Abnahmekriterien für Schritt 2
- Stabile IDs und Quellennachverfolgbarkeit für jeden Datensatz.
- Ursprünglicher Text beibehalten.
- Dokumentierte Filter für Datum, Bewertung, Markt, Produkt und Sprache.
- Protokollierte Behandlung von Duplikaten.
- Personenbezogene oder sensible Daten gemäß der Richtlinie des Unternehmens behandelt.
- Korpusstatistiken vor der Modellverarbeitung verfügbar.
Für Programme mit mehreren Quellen verwenden Sie vor der Zusammenfassung einen separaten Normalisierungs-Workflow. Der Leitfaden zum Analysieren von E-Commerce-Feedback über verschiedene Kanäle hinweg behandelt dieses umfassendere Erfassungsproblem.
Schritt 3: Strukturierte Evidenz extrahieren, bevor Prosa verfasst wird
Bitten Sie nicht einen einzelnen Modellaufruf gleichzeitig darum, Themen zu erkennen, Evidenz zu zählen, Widersprüche aufzulösen, Zitate auszuwählen und die Management-Zusammenfassung zu verfassen. Teilen Sie die Aufgabe in Extraktion auf Rezensionsebene und Synthese auf Korpusebene auf.
Erstellen Sie eine Aspekt-Taxonomie
Ein Aspekt ist das Thema einer Kundenäußerung: Akkulaufzeit, Einrichtung, Verpackung, Größen, Support-Antwort, Preis, Haltbarkeit oder ein anderes domänenspezifisches Attribut.
Beginnen Sie mit einer kleinen Taxonomie auf Grundlage der Entscheidung aus Schritt 1. Erlauben Sie eine „sonstige“-Klasse und einen Erkundungsdurchlauf für aufkommende Themen. Versionieren Sie die Taxonomie, damit eine Änderung der Bezeichnungen die Trendlinien nicht stillschweigend verändert.
Ein nützliches Evidenz-Record kann Folgendes enthalten:
{
  "review_id": "r-1042",
  "aspect": "setup",
  "claim": "instructions were difficult to follow",
  "sentiment": "negative",
  "severity": "medium",
  "evidence_span": "exact supporting passage",
  "confidence": 0.86,
  "model_version": "extractor-version"
}
Die genauen Bezeichnungen unterscheiden sich je nach Anwendungsfall. Die wichtige Designentscheidung ist, dass jede extrahierte Aussage auf eine Rezension und idealerweise auf einen exakten Evidenzabschnitt zurückverweist.
Widersprüche und Minderheitssignale bewahren
Eine Zusammenfassung, die sagt „Kunden finden die Einrichtung einfach“, kann eine kleinere, aber wichtige Gruppe verbergen, die ein anderes Gerät, eine andere Konfiguration oder eine andere Sprache verwendet. Speichern Sie positive, negative und gemischte Evidenz getrennt, bevor Sie eine Schlussfolgerung synthetisieren.
Berechnen Sie für jedes Thema mindestens:
- die Anzahl unterstützender Rezensionen;
- die Anzahl widersprechender Rezensionen;
- die Anzahl repräsentierter eindeutiger Produkte oder Varianten;
- den Datumsbereich;
- die Bewertungsverteilung;
- die Konzentration nach Segment oder Anwendungsfall;
- die Anzahl der Rezensionen mit nutzbaren Evidenz-Abschnitten.
Dies sind Korpusdeskriptoren, kein Beleg für eine breite Verbreitung. Sie helfen dem Modell und dem menschlichen Prüfer zu erkennen, ob ein Thema stabil, konzentriert, aktuell oder umstritten ist.
Verwenden Sie Zitate als Beleg, nicht als Zierde
Die Auswahl von Zitaten sollte nach der Evidenzextraktion erfolgen. Verlangen Sie exakte Textstellen aus dem Quelltext. Lehnen Sie generierte Paraphrasen ab, die als direkte Zitate präsentiert werden.
Ein starkes Themenprotokoll enthält:
- eine prägnante Bezeichnung;
- eine Erklärung in einfacher Sprache;
- ein repräsentatives Zitat;
- eine Ausnahme oder ein widersprüchliches Zitat, sofern vorhanden;
- Quell-IDs;
- Korpuszählungen;
- Vertrauen und Einschränkungen.
Forschung zu aspektgesteuerter und Meinungszusammenfassung unterstreicht den Wert, Zusammenfassungen mit bestimmten Aspekten und unterstützenden Meinungen zu verknüpfen, statt eine unstrukturierte allgemeine Zusammenfassung zu erzeugen. Siehe das MARS-Benchmark für aspektorientierte Rezensionszusammenfassung und Wayfairs Arbeit zu treuer abstrakter Produktrezensionszusammenfassung.
Verwenden Sie einen Evidenzvertrag auf Aussageebene
Eine Zählung auf Themenebene reicht nicht aus, wenn eine Zusammenfassung mehrere unterschiedliche Aussagen enthält. Speichern Sie für jede wesentliche Aussage ein Evidenzpaket:
{
  "claim_id": "claim-battery-cold-weather",
  "claim_text": "Die Batterieleistung bei kaltem Wetter ist eine wiederkehrende Beschwerde im analysierten Korpus.",
  "scope": {
    "product_id": "sku-123",
    "market": "US",
    "date_window": "2026-05-01/2026-07-31"
  },
  "supporting_review_ids": ["r-104", "r-318", "r-522"],
  "counterevidence_review_ids": ["r-091", "r-447"],
  "corpus_count": 742,
  "support_count": 18,
  "confidence": "medium",
  "allowed_wording": "recurring in the analyzed corpus",
  "prohibited_wording": "affects most customers"
}
Dieser Vertrag gibt dem Generator weniger Freiheit und dem Evaluator mehr Hebelwirkung. Außerdem kann das Team das Schreibmodell ändern, ohne die Evidenzschicht neu aufzubauen.
Behandeln Sie Rezensionstext als nicht vertrauenswürdige Eingabe. Kundeninhalte können Anweisungen, kopierten Text, URLs oder Versuche enthalten, ein automatisiertes System zu manipulieren. Die OWASP-Anleitung zur Prompt-Injection empfiehlt, nicht vertrauenswürdige Inhalte von Systemanweisungen zu trennen und die Autorität des Modells zu begrenzen. Rezensionstext darf niemals Berechtigungen für Tools, Korpusfilter, Bewertungsregeln oder Veröffentlichungseinstellungen ändern.
Schritt-3-Abnahmekriterien
- Versionierte Taxonomie und Extraktionsschema.
- Belege auf Rezensionsebene.
- Exakte Quellenspannen für wesentliche Aussagen.
- Widersprüche beibehalten, nicht wegmitteln.
- Themenzählungen aus Datensätzen berechnen statt vom Generator raten lassen.
- Ein reproduzierbarer Pfad vom Zusammenfassungssatz zur Quellrezension.
Schritt 4: Erzeuge fundierte Zusammenfassungen und bewerte sie
Sobald die Belegebene vorhanden ist, hat das Zusammenfassungsmodell eine engere Aufgabe: strukturierte Belege in ein nützliches Entscheidungsartefakt zu verdichten, ohne ungestützte Schlussfolgerungen hinzuzufügen.
Gib dem Generator einen strikten Vertrag
Die Generierungsanweisung sollte definieren:
- das Publikum und die Entscheidung;
- die zulässigen Belegfelder;
- die erforderliche Ausgabestruktur;
- das Format für Zitate oder Quellen-IDs;
- die Formulierung für Unsicherheit;
- Regeln für widersprüchliche Belege;
- verbotene Schlussfolgerungen;
- die maximale Länge;
- was zu tun ist, wenn die Belege unzureichend sind.
Eine praktische Regel lautet: Wenn sich eine Aussage nicht mit den bereitgestellten Belegen verknüpfen lässt, lasse sie weg oder kennzeichne sie als Hypothese.
Erstelle vor dem Start einen Testsatz
Erstelle einen repräsentativen Bewertungssatz, der Folgendes umfasst:
- große und kleine Rezensionstapel;
- positive, negative und gemischte Produkte;
- spärliche Themen;
- mehrsprachige Rezensionen;
- Duplikate und nahezu Duplikate;
- widersprüchliche Belege;
- Rezensionen mit Sarkasmus oder mehrdeutiger Sprache;
- schwere Beschwerden, die eine Eskalation erfordern;
- Produkte mit mehreren Varianten oder Anwendungsfällen.
Nimm adversarische Fälle auf. Ein System, das nur an sauberen, offensichtlichen Beispielen getestet wird, wirkt zuverlässig, bis es auf Produktionsdaten trifft.
Bewerte die Ausgabe anhand von fünf Dimensionen
Verwende für jede Dimension eine 1–5-Bewertungsskala:
| Dimension | Frage | Fehlerbeispiel |
|---|---|---|
| Fundiertheit | Wird jede wesentliche Aussage durch bereitgestellte Belege gestützt? | Die Zusammenfassung erfindet eine Ursache für einen Batteriefehler |
| Abdeckung | Enthält die Zusammenfassung die entscheidungsrelevanten Themen und Ausnahmen? | Sie lässt eine seltene Sicherheitsbeschwerde aus |
| Treue | Bewahrt sie Polarität, Umfang und Unsicherheit? | „Einige Rezensionen“ wird zu „Kunden sagen durchgängig“ |
| Nützlichkeit | Kann der beabsichtigte Nutzer die nächste Entscheidung schneller treffen? | Die Zusammenfassung listet Themen auf, liefert aber keine Segmentierung oder Belege |
| Nachvollziehbarkeit | Kann ein Prüfer die zugrunde liegenden Datensätze erreichen? | Zählungen und Zitate haben keine Quellen-IDs |
Reduziere die Bewertung nicht auf eine einzige automatische Punktzahl. Verwende deterministische Prüfungen für Schema, Quellen-IDs, Zählungen und Zitatabgleich; modellbasierte Bewertung für semantische Qualitäten; und menschliche Prüfung für Entscheidungsnützlichkeit und Fälle mit hohem Risiko.
OpenAIs Best Practices für Evaluierungen empfehlen aufgabenspezifische Evals, repräsentative Datensätze und kontinuierliche Evaluierung, anstatt sich auf informelle Eindrücke zu verlassen. Die Dokumentation von Google Cloud für die Bewertung von Zusammenfassungen trennt ebenfalls Eigenschaften wie Vollständigkeit, Korrektheit und Einhaltung.
Freigabe-Schwellenwerte definieren
Setzen Sie Schwellenwerte, bevor Sie die endgültigen Ergebnisse sehen. Zum Beispiel:
- null nicht gestützte direkte Zitate;
- null fehlende Quell-IDs für Themen mit hoher Priorität;
- keine Hochrisikoaussage ohne menschliche Prüfung veröffentlicht;
- Mindestwerte für Groundedness und Abdeckung im Testset;
- maximal zulässige Abweichung bei der Anzahl;
- explizites Absehen, wenn die Evidenz unter dem Mindestschwellenwert liegt.
Die Schwellenwerte sollten das Entscheidungsrisiko widerspiegeln. Eine tägliche Orientierungszusammenfassung kann mehr Unsicherheit tolerieren als eine Zusammenfassung, die für eine Produkt-Rückrufuntersuchung oder eine öffentliche Aussage verwendet wird.
Eine Evaluierungsmatrix aufbauen, nicht einen einzelnen Genauigkeitswert
Erstellen Sie ein festes Evaluierungsset, das normale Beispiele und bewusst erzeugte Stressfälle enthält. Jeder wesentliche Produktionsfehler sollte zu einem neuen Regressionstestfall werden.
| Testfamilie | Beispielfall | Bestehensbedingung |
|---|---|---|
| Evidenzstützung | Zusammenfassung behauptet einen wiederkehrenden Defekt | Jede Behauptung lässt sich gültigen Quell-IDs und zulässiger Formulierung zuordnen |
| Abdeckung | Korpus enthält ein dominantes und zwei Minderheitenthemen | Dominantes Thema erscheint; wesentliche Minderheitssignale werden nicht ausgelöscht |
| Widerspruch | Bewertungen widersprechen sich je nach Produktvariante | Ausgabe trennt Varianten, statt sie zusammen zu mitteln |
| Dünne Evidenz | Nur zwei Bewertungen erwähnen ein Thema | System sieht ab oder kennzeichnet Evidenz als dünn |
| Zitattreue | Bewertung enthält ungewöhnliche Interpunktion | Zitat stimmt exakt mit dem Quellabschnitt überein |
| Injection-Resistenz | Bewertungstext enthält Anweisungen an das Modell | Anweisungen werden als Inhalt behandelt und haben keine Steuerungswirkung |
| Reproduzierbarkeit | Dasselbe Release-Paket wird erneut ausgeführt | Ausgabe bleibt innerhalb der definierten Stabilitätstoleranz |
| Schema-Konformität | Generator lässt ein erforderliches Feld aus | Validierung schlägt vor der Veröffentlichung fehl |
OpenAIs Leitfaden zu Best Practices für Evaluierungen empfiehlt aufgabenspezifische Evals, Protokollierung, Automatisierung, wo möglich, und kontinuierliche Evaluierung. Das Prinzip gilt unabhängig vom Modellanbieter: Definieren Sie das gewünschte Verhalten, testen Sie es an repräsentativen Daten, und bewahren Sie die relevanten Fehler auf.
Für ein formales Pre-Launch-Gate siehe die Checkliste für Akzeptanztests und Übergabe bei KI-Rezensionszusammenfassungen.
Abnahmekriterien für Schritt 4
- Versionierte Prompts und Modellkonfiguration.
- Repräsentative und adversariale Testfälle.
- Von Menschen verfasste Referenzbewertungen für eine Teilmenge.
- Getrennte Scores für Groundedness, Abdeckung, Treue, Nützlichkeit und Nachverfolgbarkeit.
- Feste Release-Schwellenwerte und Eskalationsregeln.
- Fehlerbeispiele, die für Regressionstests gespeichert werden.
Wenn Sie Software bewerten, statt den vollständigen Stack zu entwickeln, bietet der Leitfaden zu den Anforderungen an ein Tool zur Analyse von Kundenbewertungen eine umfassendere Checkliste der Funktionen.
Schritt 5: Bereitstellung mit Monitoring, Versionierung und Feedback-Schleifen
Ein Zusammenfasser kann eine Launch-Evaluierung bestehen und sich dennoch verschlechtern. Die Sprache der Bewertungen ändert sich, Produktkataloge ändern sich, Quelldatenfelder verschwinden, Taxonomien entwickeln sich weiter, Prompts driften, und Modellversionen verhalten sich unterschiedlich.
Behandeln Sie das eingesetzte System als überwachten analytischen Workflow.
Protokollieren Sie genug, um jede Zusammenfassung reproduzieren zu können
Speichern Sie:
- Abfrage und Filterdefinition des Korpus;
- Bewertungs-IDs und Zeitpunkt des Korpus-Snapshots;
- Version der Bereinigung und Deduplizierung;
- Version der Taxonomie;
- Extraktionsmodell und Prompt-Version;
- Generierungsmodell und Prompt-Version;
- Ausgabe- und Evidenzlinks;
- Evaluationsergebnisse;
- menschliche Bearbeitungen und Freigabestatus.
Reproduzierbarkeit ist wichtig, wenn ein Stakeholder fragt, warum sich die Schlussfolgerung dieses Monats von der des letzten Monats unterscheidet.
Überwachen Sie die Pipeline, nicht nur das Modell
Verfolgen Sie betriebliche und qualitative Indikatoren wie:
- Fehler bei der Ingestion und fehlende Felder;
- Duplikatrate;
- Rate nicht klassifizierter Aspekte;
- Rate von Extraktionen mit geringer Sicherheit;
- Fehlerrate bei Evidenzlinks;
- Rate von Zitierabweichungen;
- Fehler bei der Mengenabstimmung;
- Abstentionsrate;
- Rate menschlicher Bearbeitungen;
- Akzeptanzrate der Prüfer;
- Zeit von der Ingestion bis zur entscheidungsreifen Ausgabe.
Ein plötzlicher Anstieg von „anderen“ Aspekten kann auf Taxonomie-Drift hinweisen. Ein Rückgang der Themenanzahlen kann eher ein Problem bei der Quell-Ingestion als ein echter Kundentrend sein.
Fügen Sie drei Betriebsbudgets hinzu:
- Qualitätsbudget: die maximal tolerierte Rate nicht belegter Behauptungen, fehlender Evidenz oder schwerer Auslassungen.
- Latenzbudget: die maximale Zeit von der Verfügbarkeit der Quelle bis zu einer nutzbaren Zusammenfassung, einschließlich Wiederholungsversuchen und menschlicher Prüfung.
- Kostenbudget: Ingestion, Speicherung, Extraktion, Generierung, Evaluation und Prüferminuten pro abgeschlossener Entscheidungseinheit.
Der günstigste Modellaufruf kann dennoch den teuersten Workflow erzeugen, wenn er mehr manuelle Verifikation verursacht. Messen Sie die End-to-End-Kosten pro akzeptierter Zusammenfassung, nicht nur Tokens.
Definieren Sie Rollback-Trigger vor dem Launch
Rollback sollte automatisch oder sofort verfügbar sein, wenn:
- Die Quellmenge sinkt unerwartet oder ein Connector aktualisiert sich nicht mehr.
- Die Schema-Validierung für erforderliche Nachweisfelder schlägt fehl.
- Nicht unterstützte Behauptungen überschreiten das Qualitätsbudget.
- Ein Thema mit hoher Schwere wird ohne erforderliche Prüfung veröffentlicht.
- Ein Modell-, Prompt-, Taxonomie- oder Retrieval-Änderung führt zu einer Verschlechterung des Benchmarks.
- Die Korrekturen der Prüfer häufen sich um ein Segment, eine Sprache oder eine Produktvariante.
Rollback bedeutet, ein bekanntes Release-Paket wiederherzustellen und nicht lediglich den Prompt erneut zu ändern. Bewahren Sie die vorherige Modellkennung, Prompt-Version, Taxonomie, Korpusregeln, Code-Revision und Evaluationsergebnisse zusammen auf. Die Checkliste für den Produktions-Rollout behandelt Shadow Mode, Incidents und kontrollierte Erweiterung ausführlicher.
Einen Feedback-Loop für Prüfer erstellen
Erfassen Sie, warum ein Prüfer eine Zusammenfassung ändert oder ablehnt. Verwenden Sie strukturierte Gründe wie:
- nicht unterstützte Behauptung;
- wichtige Thematik fehlt;
- falsche Polarität;
- irreführende Verallgemeinerung;
- schwaches Zitat;
- falsche Anzahl;
- doppelte Thematik;
- unklarer nächster Schritt;
- Eskalation erforderlich.
Verwandeln Sie diese Fehler in neue Evaluationsfälle. So verbessert sich das System, ohne sich auf vage Anweisungen zu verlassen, die Zusammenfassung „besser zu machen“.
Risikomanagement auf den Use Case anwenden
Das NIST Generative AI Profile betont das Management von Risiken über Design, Entwicklung, Bereitstellung und Nutzung hinweg. Für die Zusammenfassung von Rezensionen bedeutet das, Einschränkungen zu dokumentieren, vorhersehbare Fehlermodi zu testen, das bereitgestellte Verhalten zu überwachen und Kontrollen an die Folgen von Fehlern anzupassen. Der umfassendere NIST AI Risk Management Framework bietet eine nützliche Abfolge für den Betrieb: Verantwortlichkeiten steuern, den Anwendungsfall und die betroffenen Parteien abbilden, Qualität und Risiko messen und Probleme im Zeitverlauf managen.
Akzeptanzkriterien für Schritt 5
- End-to-End-Versionsprotokollierung.
- Qualitäts- und Betriebs-Dashboards.
- Warnmeldungen bei Fehlern in Quelle, Schema und Nachweisen.
- Strukturiertes Feedback der Prüfer.
- Für jeden wesentlichen Fehler ein hinzugefügter Regressionstest.
- Ein Rollback-Pfad für Änderungen an Modell, Prompt, Taxonomie und Pipeline.
Ein praktischer 30-Tage-Rollout-Plan
| Zeitraum | Ziel | Lieferobjekt |
|---|---|---|
| Tage 1–5 | Umfang und Beweisregeln definieren | Entscheidungserklärung, Ausgabeschema, Risikorichtlinie, erster Testsatz |
| Tage 6–10 | Die Korpus-Pipeline aufbauen | Nachvollziehbare Datensätze, Normalisierungsregeln, Deduplizierungsprotokoll, Korpusbericht |
| Tage 11–17 | Strukturierte Extraktion aufbauen | Taxonomie, Belegdatensätze, Zitatprüfungen, Umgang mit Widersprüchen |
| Tage 18–24 | Generieren und bewerten | Zusammenfassungsvertrag, Bewertungsraster, menschliche Überprüfung, Freigabeschwellen |
| Tage 25–27 | Shadow-Modus ausführen | Generierte Ausgaben mit dem aktuellen menschlichen Workflow vergleichen, ohne Entscheidungen zu ändern |
| Tage 28–30 | Begleiteter Pilot | Begrenzter Produktionslauf, Dashboard, Feedback der Prüfer, Rollback-Übung |
Halten Sie den ersten Pilot klein. Eine Produktfamilie, ein Markt, ein Entscheidungsträger und eine wiederkehrende Entscheidung lehren Sie mehr als ein breiter Start mit unklarer Verantwortlichkeit.
Am Ende von 30 Tagen treffen Sie eine von drei Entscheidungen: den Umfang erweitern, den Umfang beibehalten und spezifische Lücken beheben oder den Workflow stoppen. „Die Zusammenfassungen scheinen nützlich zu sein“ ist keine Entscheidung. Vergleichen Sie den Pilot mit den Freigabeschwellen, Betriebsbudgets, dem Prüferaufwand und dem Basisprozess, den er verbessern sollte.
Implementierungs-Übergabekarte
Verwenden Sie diese Übergabekarte, wenn die Checkliste von der Planung in Engineering-Tickets übergeht.
| Verantwortlicher | Erhält | Muss zurückgeben | Blockierende Frage |
|---|---|---|---|
| Produkt- oder Forschungsleiter | Entscheidungsvertrag und Ausgabeschema | Genehmigter Anwendungsfall, Nicht-Ziele, Eskalationsthemen | Welche Entscheidung ändert sich, wenn die Zusammenfassung falsch ist? |
| Datenverantwortlicher | Quellenliste und Aufbewahrungsrichtlinie | Felder des Korpus-Manifests, Lösch-/Exportregeln, zulässige Quellverweise | Kann jede Bewertung nachvollzogen werden, ohne unnötige Daten offenzulegen? |
| Engineering-Leiter | Korpus- und Belegschemata | Versionierte Pipeline, Validierungsprüfungen, Release-Protokoll, Rollback-Pfad | Kann der Lauf nach einer Prompt- oder Modelländerung reproduziert werden? |
| Fachgutachter | Aspekt-Taxonomie und Beispielbelege | Beschriftungsregeln, Widerspruchsregeln, Definitionen für Schweregrade | Welche Minderheitssignale dürfen niemals wegmittelwertet werden? |
| QA-Verantwortlicher | Testsatz und Bewertungsraster | Freigabeschwellen, Regression-Suite, Fehlerprotokoll | Welche Fehler blockieren den Start, statt Folgearbeit zu erzeugen? |
| Betriebsverantwortlicher | Überwachungsanforderungen | Dashboards, Alarme, Incident-Verantwortliche, Regeln für den begleiteten Start | Wer pausiert den Workflow, wenn die Belegqualität sinkt? |
Die Übergabe ist erst abgeschlossen, wenn jeder Verantwortliche ein Rückgabe-Artefakt hat. Eine Besprechungsnotiz mit „genehmigt“ reicht für eine Implementierungs-Checkliste für KI-Rezensionszusammenfassungen nicht aus. Die Artefakte müssen den nächsten Release, den nächsten Prüfer und die nächste Änderung der Quelldaten überstehen.
Selbst bauen, kaufen oder kombinieren?
Die Checkliste gilt, egal ob Sie mit Modellen und APIs bauen, eine spezielle Plattform kaufen oder beides kombinieren.
- Build, wenn der Workflow strategisch einzigartig ist, die technische Verantwortung stabil ist und Ihr Team Datenzugriff, Evaluierung, Sicherheit und Monitoring aufrechterhalten kann.
- Buy, wenn Geschwindigkeit, wiederholbare Review-Intelligenz, Nutzerfreundlichkeit für Analysten und bestehende Workflows wichtiger sind als eine maßgeschneiderte Infrastruktur.
- Combine, wenn eine Plattform Erfassung und Analyse übernimmt, während eine API oder interne Anwendung Ergebnisse in einen bestimmten Produkt-, Forschungs- oder Reporting-Workflow liefert.
Vergleichen Sie Optionen, indem Sie denselben definierten Korpus durch jeden Workflow laufen lassen. Prüfen Sie die Nachvollziehbarkeit der Belege, den Umgang mit Widersprüchen, die Taxonomie-Kontrolle, die Unterstützung bei der Evaluierung und die Exportierbarkeit – nicht nur, wie ausgefeilt die Zusammenfassung klingt.
VOC AI unterstützt Review-Analyse-Workflows über Voice of Customer Analysis, review-gestützte Product Research, Wettbewerbsanalyse und die Review Analysis API. Der richtige Weg hängt davon ab, ob Ihr unmittelbarer Bedarf ein Analysten-Workflow, ein wiederkehrendes Entscheidungssystem oder eine Produktintegration ist.
Finale Implementierungs-Checkliste
Vor dem Start sollten Sie bestätigen, dass Sie jede Frage mit Ja beantworten können:
- Entscheidung: Ist die Zusammenfassung an einen benannten Benutzer und eine wiederkehrende Entscheidung gebunden?
- Nicht-Ziele: Legt der Vertrag fest, was die Zusammenfassung nicht belegen kann?
- Verantwortliche Person: Ist eine Person für jede Freigabeschranke verantwortlich?
- Korpus: Kann jede enthaltene Bewertung auf einen stabilen Quellensatz zurückgeführt werden?
- Manifest: Können der genaue Datensatz und die Filter rekonstruiert werden?
- Segmentierung: Werden Produkt-, Markt-, Sprach-, Bewertungs- und Zeitunterschiede dort erhalten, wo sie relevant sind?
- Deduplizierung: Werden Entfernungen protokolliert, ohne legitime Wiederholungen zu löschen?
- Belege: Verweist jede wesentliche Behauptung auf Belege auf Bewertungsebene?
- Gegenbelege: Sind Minderheiten- und widersprüchliche Signale sichtbar?
- Behauptungen: Sind Beobachtungen aus dem Korpus von Populations- oder Kausalbehauptungen getrennt?
- Zitate: Sind Zitate wortgetreu, zuordenbar und vor Prompt-Injection geschützt?
- Schema: Scheitert ungültige Ausgabe vor der Veröffentlichung?
- Bewertung: Haben Sie Groundedness, Abdeckung, Treue, Nützlichkeit und Nachvollziehbarkeit getestet?
- Stresstests: Enthält der Benchmark spärliche, widersprüchliche, segmentierte und adversariale Beispiele?
- Schwellenwerte: Sind Freigabe- und Zurückhaltungs-Kriterien explizit?
- Risiko: Lösen Themen mit hohem Risiko eine menschliche Prüfung aus?
- Versionierung: Können Sie eine Zusammenfassung nach einer Änderung von Modell, Prompt, Taxonomie oder Korpus reproduzieren?
- Budgets: Werden Qualitäts-, Latenz-, Kosten- und Prüferzeit-Limits durchgängig gemessen?
- Rollback: Kann das Team ein bekanntes Release-Paket schnell wiederherstellen?
- Sicherheit: Ist unzuverlässiger Bewertungstext von Anweisungen, Tools und Veröffentlichungssteuerungen getrennt?
- Lernen: Wird jede wesentliche Korrektur zu einem Regressionstest oder einer Regelaktualisierung?
Die Implementierung ist bereit, wenn die Belege einer Prüfung standhalten – nicht, wenn der Text flüssig klingt.
Wenn Sie eine Plattform bewerten statt den gesamten Stack zu bauen, wenden Sie dieselbe Checkliste bei der Beschaffung an. Bitten Sie den Anbieter, die Nachvollziehbarkeit der Belege, Korpus-Kontrollen, Exporte, Bewertung, Sicherheitsgrenzen und das Rollback-Verhalten mit Ihrem eigenen Testset zu demonstrieren. Die Checkliste zur Bewertung von Anbietern für KI-Rezensionszusammenfassungen bietet eine strukturierte Bewertungsübersicht.
Behandeln Sie diese Implementierung-Checkliste für KI-Rezensionszusammenfassungen als zentralen Einstiegspunkt. Nutzen Sie die Begleitseiten, wenn das Team tiefere QA-Tests, technische Artefakte, Sicherheitskontrollen, die Abnahmeübergabe, Anbieterbewertung oder Produktionsbetrieb benötigt.
Häufig gestellte Fragen
Was ist KI-Rezensionszusammenfassung?
KI-Rezensionszusammenfassung ist die Verwendung von Sprachmodellen oder verwandten Systemen der Verarbeitung natürlicher Sprache, um eine definierte Menge an Kundenbewertungen in Themen, Erkenntnisse oder entscheidungsorientierte Ausgaben zu komprimieren. Ein Produktionsworkflow sollte die Rückverfolgbarkeit der Quellen, Unsicherheit, Widersprüche und Korpusgrenzen bewahren.
Wie viele Bewertungen werden für die KI-Zusammenfassung benötigt?
Es gibt kein universelles Minimum. Der richtige Schwellenwert hängt von der Entscheidung, der Produktsegmentierung, der Länge der Bewertungen, der Themenvielfalt und dem erforderlichen Konfidenzniveau ab. Berichten Sie stets die Größe des analysierten Korpus und verzichten Sie auf weitreichende Schlussfolgerungen, wenn die Evidenz spärlich ist.
Sollten KI-Zusammenfassungen Kundenzitate enthalten?
Ja, wenn Zitate die Verifikation und den Kontext verbessern. Zitate müssen exakte Quellstellen mit stabilen Bewertungs-IDs oder Links sein. Stellen Sie niemals eine generierte Paraphrase als direktes Zitat dar.
Wie messen Sie die Genauigkeit von Bewertungszusammenfassungen?
Messen Sie mehrere Dimensionen: Fundierung, Abdeckung, Treue, Nützlichkeit und Nachvollziehbarkeit. Kombinieren Sie deterministische Prüfungen, modellbasierte Evaluierung und menschliche Bewertung. Genauigkeit ist nicht eine einzelne Kennzahl, denn eine grammatikalisch korrekte Zusammenfassung kann dennoch wichtige Belege auslassen oder ein schwaches Muster überbewerten.
Was sollte im ersten Engineering-Ticket enthalten sein?
Das erste Ticket sollte den Entscheidungsvertrag, das Korpus-Manifest, das Evidenzschema, das Ausgabeschema und die Validierungsprüfungen erstellen, bevor irgendeine Produktionszusammenfassung generiert wird. Die Modellauswahl kann erfolgen, nachdem das Team weiß, welche Evidenz das System bewahren muss.
Kann eine Bewertungszusammenfassung belegen, wie häufig ein Problem ist?
Sie kann die Häufigkeit innerhalb des analysierten Bewertungskorpus beschreiben. Sie schätzt jedoch nicht automatisch die Prävalenz unter allen Kunden, erklärt keine Kausalität und prognostiziert keine geschäftlichen Auswirkungen. Diese Fragen erfordern zusätzliche Daten und eine dafür entwickelte Methode.