2026年8月9日更新。
AIレビュー要約はデモでは簡単に見えます。レビューのバッチをモデルに送り、主要なテーマを尋ねればよいからです。しかし本番環境では、その近道が見慣れた問題を生みます。重複した証拠、曖昧なテーマ、少数意見の不在、裏付けのない主張、そして誰も監査できない要約です。
信頼できる実装には、プロンプトだけでは不十分です。意思決定を定義し、証拠を整え、分析を構造化し、重要な主張をすべて検証し、リリース後に品質を監視する、管理されたパイプラインが必要です。
このAIレビュー要約実装チェックリストは、プロダクト、eコマース、CX、リサーチの各チームが、未加工のレビュー本文から意思決定に使える要約へ進むための実践的な道筋を示します。構築手順、最小限必要な成果物、受け入れテスト、そしてチームが通常は遅れて気づく運用上の判断――責任範囲、コーパスサイズ、証拠契約、リリース閾値、レイテンシとコストの制御、ロールバック基準――を網羅しています。
問いがもはや「モデルはレビューを要約できるか?」ではなく、「私たちのチームは、監査、修正、そして次のソースデータ変更にも耐えられる要約ワークフローを出荷できるか?」になったとき、このAI review summarization: implementation checklistを使ってください。
目標は、モデルに説得力のある段落を書かせることではありません。すべての重要な記述が顧客の証拠にたどれる、再現可能な意思決定システムを作ることです。
この実装チェックリストで変わったこと
今回の8月9日更新では、すでにアーキテクチャを理解しているが、それをエンジニアリングのチケットに落とし込みたいチーム向けに、スプリント対応の実装レイヤーを追加しました。以前のチェックリストでは証拠パイプラインを説明していましたが、今回の版では次を追加しています。
- 10件のチケットからなる構築バックログ;
- 各実装レイヤーごとの完了定義マトリクス;
- Jira、Linear、またはNotionの引き継ぎに添付できるリリースパケットのテンプレート;
- パイロット受け入れからモニタリング、ロールバック、ベンダー評価までのルート。
チームが「設計には合意している」段階から、「プロダクト、CX、またはeコマース運用者が要約に依存できるようになる前に、具体的に何が存在していなければならないのか?」へ移るときに、このセクションを使ってください。
以下のAIレビュー要約実装チェックリストは、各セクションがチケット、受け入れテスト、またはリリース成果物になれるように構成されています。
10件のチケットからなる実装バックログ
有用なAIレビュー要約実装チェックリストは、会議メモではなくチケットになるべきです。以下の10個の作業項目から始め、各チケットを返却成果物に紐づけてください。
| チケット | 担当者 | 成果物 | 完了条件の定義 |
|---|---|---|---|
| 1. 意思決定契約 | プロダクトまたはリサーチのリード | 対象読者、定常的な意思決定、出力スキーマ、非目標 | レビュアーが、その要約がどの意思決定を支援し、どの主張をしてはいけないかを判断できる |
| 2. コーパス・マニフェスト | データオーナー | ソース一覧、フィルタ、安定ID、除外件数の理由、バージョンハッシュ | 曖昧なクエリを再実行しなくても、正確なレビューセットを再構築できる |
| 3. レビュー正規化 | データまたはエンジニアリングの担当者 | 生テキストの保持、正規化されたメタデータ、言語ポリシー、重複排除ログ | クリーニングによる変更が文書化され、元のレビュー本文が保持されている |
| 4. 観点タクソノミー | ドメインレビュアー | バージョン管理されたラベル、例、「その他」の扱い、重大度ルール | 2人のレビュアーが、対象の意思決定に対して十分一貫してラベルを適用できる |
| 5. 証拠抽出 | エンジニアリングの担当者 | レビュー単位の観点、主張、感情、スパン、信頼度、ソースID | 抽出されたすべての主張が、取得可能なソースレコードに紐づいている |
| 6. 主張台帳 | QA担当者 | 主張ID、支持ID、反証ID、許容される表現 | 重要な要約文を、1件ずつ承認・編集・却下できる |
| 7. グラウンデッド生成 | エンジニアリングの担当者 | 承認済みの証拠フィールドだけを使用するプロンプトまたはテンプレート | 根拠のない原因、市場での普及率、売上への影響は設計上ブロックされる |
| 8. 評価スイート | QA担当者 | ゴールデンセット、チャレンジセット、最新の本番サンプル、しきい値 | グラウンデッドネス、カバレッジ、忠実性、有用性、トレーサビリティが個別に採点される |
| 9. リリースパケット | 運用担当者 | コーパスのバージョン、タクソノミーのバージョン、モデル/プロンプトのバージョン、評価結果、承認者 | リリース済みの要約を再現またはロールバックできる |
| 10. モニタリングループ | 運用担当者 | ソース、スキーマ、証拠、品質、コスト、レビュアーフィードバックの指標 | チームはドリフトを検知し、公開を停止し、障害から回帰を追加できる |
これらを1つの「要約生成の構築」チケットにまとめてはいけない。実装が信頼できるのは、コーパス制御、証拠制御、生成、評価、運用が、検査可能なほど十分に分離されている場合だけである。
AIレビュー要約の実装チェックリストが、各担当者が返す成果物を名指しできないなら、チームはまだ制御されたワークフローを実装しているのではなく、概念について議論している段階である。
実装レイヤーごとの完了条件の定義
このマトリクスを、パイロット前のリリースゲートとして使用する。項目が1つ欠けていても、必ずしもプロジェクトを止めるべきとは限らないが、その場合はローンチ担当者がそのリスクを明示的に受け入れる必要がある。
| レイヤー | パイロット前に必須 | 欠けていると本番導入を阻止する |
|---|---|---|
| 意思決定 | 主要ユーザー1人、意思決定1件、出力契約1つ | はい。これがないと、QAは回答が有用かどうか判断できません |
| コーパス | 安定したID、ソースメタデータ、フィルター、日付範囲、除外件数 | はい。これがないと、要約を監査できません |
| エビデンス | 観点、主張、極性、正確なスパン、ソースID、反証 | 意思決定用の要約では必須です。非公式な探索に限って任意です |
| 生成 | 必須セクション、引用形式、不確実性ルール、禁止主張 | はい。そうでないと、モデルがエビデンスを裏付けのないナラティブに変えてしまう可能性があります |
| 評価 | 代表的なセット、敵対的ケース、ルーブリック、停止閾値 | はい。「もっともらしく見える」レビューは公開のゲートではありません |
| リリース | バージョン管理されたコーパス、分類体系、プロンプト、モデル、評価結果、承認者 | はい。リリースパケットがなければ、ロールバックは勘に頼ることになります |
| モニタリング | 品質、ソース、スキーマ、エビデンスリンク、レビュアー修正の指標 | 継続的な本番利用では必須です。単発の社内分析では任意です |
最もリスクの高い見落としは、通常はモデル選定ではありません。バージョン管理されていないエビデンス層です。チームが「この文を裏付けるレビューはどれか?」に答えられないなら、その実装は本番投入可能ではありません。
それが、AIレビュー要約の実装チェックリストにおける最もシンプルな合否テストです。重要な文はすべて、ソースエビデンスへ戻れる経路を持つべきです。
実装準備度スコアカード
モデルやベンダーを選ぶ前に、提案されたワークフローを各次元ごとに0から2で採点してください。0は未定義、1は部分的に定義済み、2はテスト可能で担当者が明確であることを意味します。
| 次元 | 0: 未定義 | 1: 部分的 | 2: 準備完了 |
|---|---|---|---|
| 意思決定 | 「レビューを要約する」 | 一般的なユースケース | 名前付きユーザー、繰り返し発生する意思決定、明確な非目標 |
| データ | 無制限のテキストダンプ | 基本フィルター | 安定したレビューIDを持つバージョン管理されたコーパスマニフェスト |
| エビデンス | 文章のみ | 引用を手動で追加 | 主張レベルのエビデンスIDと矛盾記録 |
| 評価 | 「良さそう」 | 場当たり的なレビュー | 固定テストセット、ルーブリック、閾値、回帰テスト |
| 運用 | 一回限りのスクリプト | 定期実行ジョブ | 担当者、モニタリング、エスカレーション、ロールバック、監査ログ |
| 経済性 | 見積もりなし | トークン見積もり | エンドツーエンドのコスト、レイテンシ、レビュアー工数、失敗予算 |
12点満点中8点未満は、たいていチームがまだデモを試している段階を意味します。8〜10点なら、限定的な支援付きパイロットを支えられます。11〜12点は、制御された本番運用の妥当な出発点です。ただし、それはシステムが完成していることの証明ではありません。
生成プロンプトを書く前にチームが不足しているコントロールを特定できるよう、AIレビュー要約の実装チェックリストの初期段階でこのスコアカードを使ってください。
リファレンスアーキテクチャ
本番ワークフローでは、1つのプラットフォームが複数の責務を担う場合でも、次の6つの責務を分離すべきです。
- 取り込み: レビューを収集し、ソースのメタデータを保持する。
- コーパス管理: データセットをフィルタリング、正規化、重複排除、分割、バージョン管理する。
- 証拠抽出: 観点、主張、感情、引用、例外、およびソースIDを特定する。
- 要約生成: 承認済みの証拠レコードのみを、定義された出力スキーマに変換する。
- 評価: 決定的チェック、モデル支援の採点、必要に応じた人手レビューを実行する。
- 配信と監視: 結果を公開し、リリースパッケージを記録し、修正を収集し、ドリフトを検知する。
最も重要なアーキテクチャ上の境界は、証拠抽出と文章生成の間にあります。要約を書くモデルが、証拠が何だったかまで自由に判断できると、裏付けのない主張を検出しにくくなります。独立して検査できる構造化された証拠レイヤーを維持してください。
AIレビュー要約: 実装チェックリストのマイルストーン
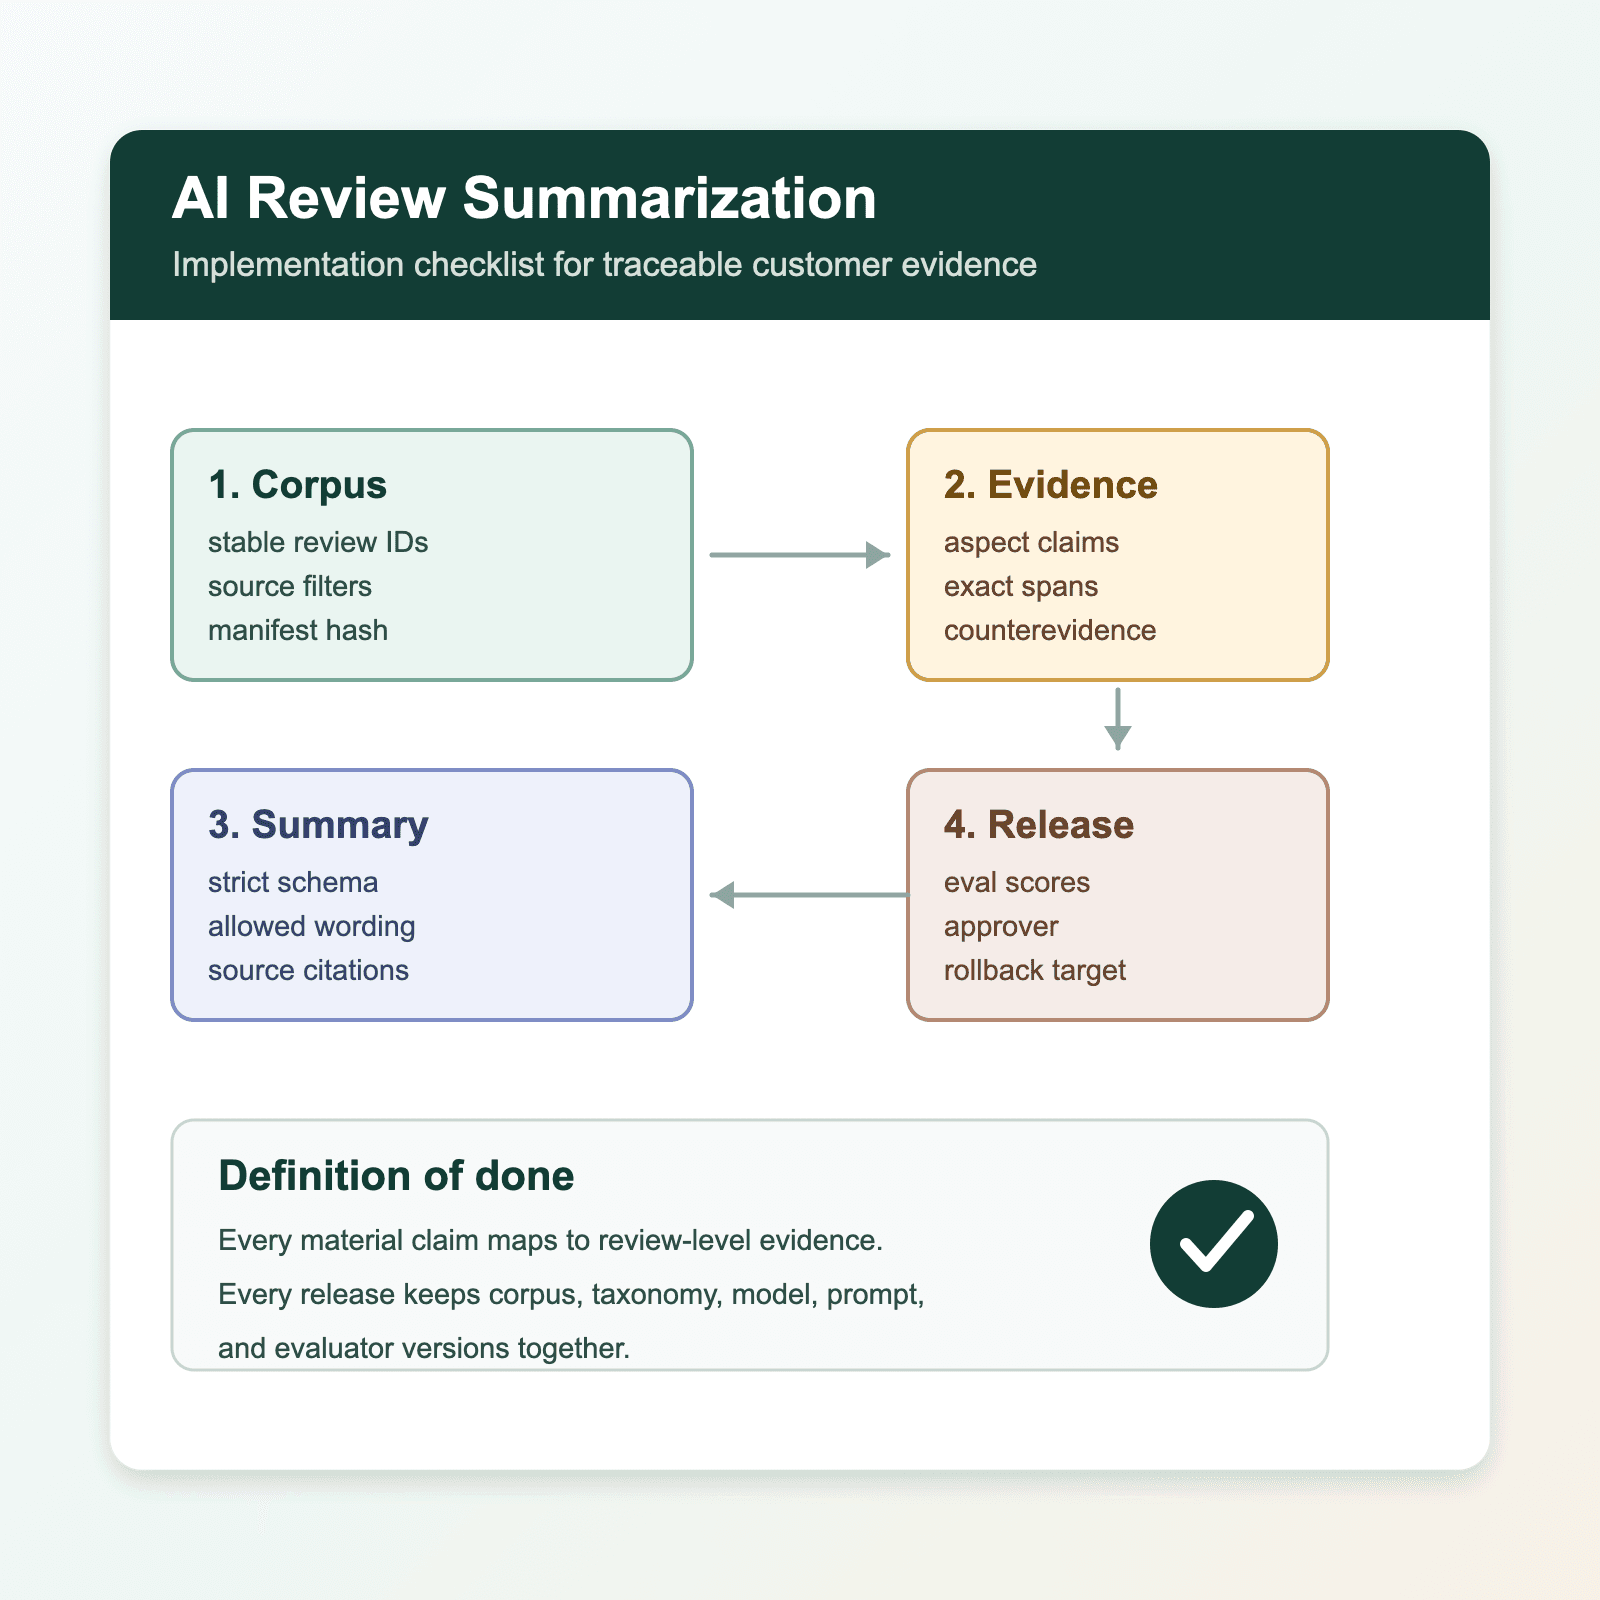
チームに2週間しかないなら、まずモデルのチューニングから始めないでください。各文がどこから来たのかを証明できる、最小限のパイプラインを構築します。
| 実装レイヤー | 最初のバージョンの成果物 | 次の条件を満たすまでリリースしない |
|---|---|---|
| 意思決定契約 | 1人の明確なユーザー、1つの反復的な意思決定、1つの出力スキーマ | 同じレビューのバッチが、誰が尋ねるかによって異なる回答を返す |
| コーパスマニフェスト | 安定したレビューID、ソースフィールド、フィルター、除外件数の理由、バージョンハッシュ | レビュー担当者が分析対象データセットを再構築できない |
| 証拠テーブル | 観点、主張、極性、正確な範囲、ソースID、信頼度、矛盾フラグ | テーマが生成された文章としてしか存在しない |
| 要約テンプレート | 必須セクション、証拠リンク、不確実性の表現、禁止された主張 | モデルが裏付けのない原因、市場での普及率、または事業への影響を持ち込める |
| 評価セット | 代表的なレビューに加え、疎、矛盾、重複、多言語、および敵対的なケース | QAが「もっともらしく見える」レビューに基づいている |
| リリース記録 | コーパスのバージョン、分類体系のバージョン、モデルとプロンプトのバージョン、評価スコア、承認者、ロールバック先 | チームが公開済み要約を再現またはロールバックできない |
これが実装の最低ラインです。より充実した AI review summarization QA checklist、engineering artifacts checklist、acceptance testing checklist、および production rollout checklist は、基本的なパイプラインが実際に動いてから各レイヤーをさらに深めます。
最初のリリースでは、AIレビュー要約の実装チェックリストをロードマップよりも狭く保ってください。より多くの製品、市場、チームへ拡大する前に、監査可能な1つの意思決定ワークフローを出荷します。
5ステップのチェックリスト一覧
| Step | Build | Acceptance test |
|---|---|---|
| 1. Define the decision | Scope, users, output contract, evidence unit | レビュー担当者が、その要約がどの意思決定を支援し、何を支援しないのかを説明できる |
| 2. Prepare the review corpus | Source fields, normalization, deduplication, filters, language policy | 含められたすべてのレビューに安定したIDがあり、元のソースまで追跡できる |
| 3. Extract structured evidence | Aspect taxonomy, sentiment, claims, quotations, exceptions | テーマは、単一の不透明なプロンプトから作り出されるのではなく、レビュー単位のレコードから組み立てられる |
| 4. Generate and evaluate summaries | Grounded generation, citations, test set, scoring rubric, human QA | 重要な記述が裏づけられ、重要な証拠が網羅され、不確実性が可視化されている |
| 5. Deploy and monitor | Versioning, drift checks, feedback loop, escalation rules | チームは品質低下を検知でき、公開済みの要約を再現できる |
これらを5つのプロンプト作成のコツとして扱わないでください。各ステップは品質ゲートです。ゲートに失敗した場合、パイプラインは停止するか、レビュー用に出力をフラグ付けする必要があります。
AIレビュー要約の実装チェックリストは、可能なところは自動化し、判断が必要なところは人が責任を持つときに最も効果を発揮します。
ステップ1: 意思決定と出力契約を定義する
最初にやりがちな実装ミスは、「これらのレビューを要約してください」から始めることです。その指示では、誰が出力を使うのか、どの意思決定に役立てるのか、どれだけの証拠が十分なのかが分かりません。
まず、範囲を限定した意思決定ステートメントから始めます:
[レビューセット]を要約して、[意思決定の責任者]が[特定の選択]を[時間枠]内に決定できるようにし、[必要な証拠と不確実性]を保持する。
例:
- 最近の1つ星および2つ星レビューを要約して、品質責任者が調査すべき苦情のテーマを特定できるようにする。
- 競合する3製品のレビューを比較して、プロダクトマネージャーが検証すべき機能ギャップの候補を絞り込めるようにする。
- ユースケース別にレビューを要約して、マーケティングチームが顧客が現行のポジショニングとは異なる形で製品を説明しているかを検証できるようにする。
次に、出力契約を定義します。有用な契約には次が含まれます:
- 分析単位: 製品、SKU、バリエーション、市場、セグメント、評価帯、または期間。
- 必須フィールド: テーマ、説明、証拠数、例示引用、ソースID、感情、影響を受けるセグメント、信頼度、例外。
- 禁止される主張: 分析対象コーパス外での一般化、因果結論、不具合率の推定、または別途証拠なしの売上への影響。
- 最小証拠: テーマを表示する、または反復的であるとラベル付けするためのしきい値。
- 不確実性の表現: 疑義がある、矛盾している、または信頼度が低い証拠をシステムがどのように報告するか。
- エスカレーションルール: 安全、法務、医療、プライバシー、または重大な製品障害の主張など、常に人間のレビューが必要となるトピック。
この契約によって、魅力的な段落が製品そのものになってしまうことを防げます。要約はあくまで表示層であり、その下にある証拠レコードが信頼できる記録システムです。
実務では、意思決定契約は AIレビュー要約の実装チェックリスト における最初の成果物です。なぜなら、コーパス、証拠スキーマ、評価ルーブリック、エスカレーション方針を決定するからです。
ステップ1の受け入れ基準
- 1つの対象読者と1つの主要な意思決定。
- 明示的な包含ルールと除外ルール。
- 機械可読な出力スキーマ。
- レビューだけからはシステムが絶対に推論してはならない主張の一覧。
- 高リスクまたは信頼度の低い出力に対する人間レビュー方針。
実装前に担当者を割り当てる
AIレビュー要約は、製品、データ、エンジニアリング、ドメイン知識、運用をまたぎます。軽量な責任分担マトリクスが、品質向上の作業を「プロンプトエンジニアの仕事」にしてしまうのを防ぎます。
| 責任 | 説明責任者 | 必要な意思決定 |
|---|---|---|
| ユースケースの範囲 | 製品またはリサーチ責任者 | 要約がどの意思決定に影響しうるか |
| ソースへのアクセスと保持 | データ管理者 | 何を収集、保存、削除、エクスポートできるか |
| 分類体系と証拠ルール | ドメイン責任者 | 何をテーマ、例外、または裏付けのある主張とみなすか |
| パイプラインとバージョニング | エンジニアリング責任者 | 実行をどのように再現し、ロールバックするか |
| 評価とリリース | 品質責任者 | どのしきい値が公開を रोकるか |
| インシデント対応 | 運用責任者 | 誰が停止し、調査し、連絡し、復旧するか |
小規模チームでは、1人が複数の役割を担うこともあります。重要なのは、すべてのリリースゲートに明確な意思決定者がいることです。より詳細な引き継ぎパッケージについては、AIレビュー要約のエンジニアリング成果物チェックリスト を使用してください。
ステップ2: クリーンでトレーサブルなレビューコーパスを構築する
モデルの品質では、定義されていないデータセットは修復できません。要約の前に、クリーニング、分析、監査を経ても維持できるレビュー単位のレコードを作成します。
実用的な最小スキーマは次のようになります:
{
  "review_id": "stable-source-id",
  "source": "marketplace-or-channel",
  "product_id": "product-or-sku",
  "variation": "size-color-model",
  "market": "US",
  "language": "en",
  "rating": 2,
  "review_date": "2026-07-01",
  "title": "review title",
  "body": "review text",
  "verified_status": "source-provided-value",
  "source_url": "permitted-source-reference",
  "ingested_at": "pipeline timestamp"
}
各実行ごとにコーパス・マニフェストを追加します。マニフェストには、クエリまたはソース要求、収集タイムスタンプ、フィルタ、言語、製品またはSKU、日付範囲、含めた件数、理由別の除外件数、重複排除手法、およびハッシュまたは不変のバージョン識別子を記録する必要があります。これにより、2人が同じ基本的な質問に答えられるようになります。「この要約は実際にどのレビューを分析したのか?」
意思決定を中心にコーパスの規模を決める
レビュー数に普遍的な最小値はありません。代わりに、セグメントと意思決定リスクで十分性を定義してください。
| ユースケース | より適切な十分性の質問 | 一般的な失敗 |
|---|---|---|
| 苦情のトリアージ | 各優先SKU、市場、最近の期間を網羅できていますか? | 大規模な過去コーパスが新しい問題を隠してしまう |
| 機能発見 | テーマは再サンプルや顧客セグメントをまたいでも安定していますか? | 声の大きい1つのセグメントが製品ロードマップになってしまう |
| 競合比較 | 製品、期間、評価の構成、バリエーションは比較可能ですか? | コーパス構成の違いが、偽の勝者を生む |
| ポジショニング調査 | ユースケースのフレーズは独立したレビュアー間で繰り返し現れますか? | 印象的な言い回しが、広範なパターンだと誤認される |
| 経営層向け報告 | すべての見出しを固定された報告期間に照合できますか? | レポートごとに分母が変わる |
評価対象の全コーパスが大きすぎる場合は、層化サンプリングを使用してください。頻度ベースのサンプルでは消えてしまう可能性があっても、安全性や重大な障害報告のような、まれだが影響の大きいレビューは保持します。
分析を改善する場合にのみ、業務固有のフィールドを追加します。列を増やしても、自動的により良い証拠になるわけではありません。
意味を消さずに正規化する
日付、評価、ロケールコード、製品識別子、空白などのフィールドを正規化します。クリーン版がある場合でも、元のレビュー本文を併記して保持してください。レビューを翻訳する場合は、以下を保持します。
- 元の言語;
- 元のテキスト;
- 翻訳テキスト;
- 翻訳手法とバージョン;
- ネイティブ言語での確認が必要な可能性がある箇所のフラグ。
スペル、スラング、製品の愛称、使用フレーズを、黙って標準化して消さないでください。そうした詳細に、最も価値の高い顧客の言葉が含まれていることがあります。
慎重に重複排除する
完全一致の重複は簡単です。再配布されたレビュー、転載レビュー、短い一般的なコメント、繰り返し使われるテンプレートは似て見えるため、近似重複の方が難しくなります。
レイヤー化された重複排除ポリシーを使用します:
- 安定したソースIDで一致させる。
- 同一の製品および市場内で、正規化された完全一致テキストで一致させる。
- 高類似度レコードは自動削除せず、レビュー対象としてフラグを付ける。
- 重複排除の理由と保持した正規レコードを記録する。
目標は、魔法のように「きれいな」データセットではありません。境界を説明できる文書化されたコーパスです。
コーパス頻度と市場での有病率を分ける
含まれるレビューの18%がセットアップの難しさに言及している場合、コーディングが信頼できるのであれば、分析対象コーパスの18%がそのテーマに言及していると報告できます。すべての顧客の18%がその問題を経験していると自動的に結論づけることはできません。
レビューは自己選択された証拠ソースです。支持されていない母集団推定を行うのではなく、パターン、用語、矛盾、調査対象の特定に活用してください。
ステップ2の受け入れ基準
- すべてのレコードに対して安定したIDとソースのトレーサビリティがあること。
- 元テキストが保持されていること。
- 日付、評価、市場、製品、言語のフィルタが文書化されていること。
- 重複処理が記録されていること。
- 個人情報または機微情報が組織のポリシーに従って処理されていること。
- モデル処理前にコーパス統計が利用可能であること。
複数ソースのプログラムでは、要約の前に別個の正規化ワークフローを使用します。チャネル横断でeコマースのフィードバックを分析するためのガイドでは、そのより広い収集上の課題を扱っています。
ステップ3: 文章を書く前に構造化された証拠を抽出する
1回のモデル呼び出しに、テーマの発見、証拠数の集計、矛盾の解消、引用の選定、経営層向け要約の作成まで同時に行わせないでください。作業をレビュー単位の抽出とコーパス単位の統合に分けます。
属性分類体系を作成する
属性とは、顧客の発言の主題です: バッテリー寿命、セットアップ、梱包、サイズ感、サポート対応、価格、耐久性、またはその他のドメイン固有属性です。
ステップ1の判断に基づいて、小さな分類体系から始めます。「その他」クラスと、新たに出現するテーマの探索パスを許可します。ラベルの変更がトレンドラインを黙って変えてしまわないよう、分類体系にバージョンを付けます。
有用な証拠レコードには、次のような項目を含められます:
{
  "review_id": "r-1042",
  "aspect": "setup",
  "claim": "instructions were difficult to follow",
  "sentiment": "negative",
  "severity": "medium",
  "evidence_span": "exact supporting passage",
  "confidence": 0.86,
  "model_version": "extractor-version"
}
正確なラベルはユースケースによって異なります。重要な設計上の選択は、抽出されたすべての主張がレビューに、理想的には正確な証拠スパンに紐づくことです。
矛盾と少数のシグナルを保持する
「顧客はセットアップを簡単だと感じている」と述べる要約は、異なるデバイス、構成、または言語を使っている、より小さいが重要なグループを隠してしまう可能性があります。結論を統合する前に、肯定的、否定的、混合の証拠を別々に保存してください。
各テーマについて、少なくとも以下を算出してください:
- 支持するレビュー数;
- 反対するレビュー数;
- 含まれるユニークな製品またはバリエーション数;
- 日付範囲;
- 評価分布;
- セグメントまたはユースケースの集中度;
- 有用な証拠スパンを含むレビュー数。
これらはコーパスの記述子であり、広範な普及の証明ではありません。これらは、テーマが安定しているのか、集中しているのか、新しいのか、または争点になっているのかを、モデルと人間のレビュー担当者が把握するのに役立ちます。
引用は装飾ではなく証拠として使う
引用の選定は、証拠抽出の後に行うべきです。ソーステキストからの正確なスパンを必須にしてください。直接引用として提示された生成済みの言い換えは却下してください。
強いテーマ記録には以下が含まれます:
- 簡潔なラベル;
- 平易な言葉での説明;
- 代表的な引用;
- 該当する場合は例外または反対の引用;
- ソースID;
- コーパスの件数;
- 信頼度と制約。
属性に基づく要約や意見要約に関する研究は、構造化されていない一般的な要約を生成するのではなく、要約を特定の属性やそれを支える意見に結び付ける価値を裏付けています。属性指向レビュー要約のためのMARSベンチマークと、Wayfairによる忠実な抽象的製品レビュー要約の研究を参照してください。
主張レベルの証拠契約を使う
要約に複数の異なる主張が含まれる場合、テーマ単位の件数だけでは不十分です。各重要な文について証拠パケットを保存してください:
{
  "claim_id": "claim-battery-cold-weather",
  "claim_text": "Cold-weather battery performance is a recurring complaint in the analyzed corpus.",
  "scope": {
    "product_id": "sku-123",
    "market": "US",
    "date_window": "2026-05-01/2026-07-31"
  },
  "supporting_review_ids": ["r-104", "r-318", "r-522"],
  "counterevidence_review_ids": ["r-091", "r-447"],
  "corpus_count": 742,
  "support_count": 18,
  "confidence": "medium",
  "allowed_wording": "recurring in the analyzed corpus",
  "prohibited_wording": "affects most customers"
}
この契約により、生成側の自由度は下がり、評価側の有効性は高まります。また、証拠レイヤーを再構築せずに文章生成モデルを変更できるようになります。
レビュー本文は信頼できない入力として扱ってください。顧客コンテンツには、指示、引用されたテキスト、URL、または自動化システムを操作しようとする試みが含まれることがあります。OWASPのプロンプトインジェクションに関するガイダンスでは、信頼できないコンテンツをシステム指示から分離し、モデルの権限を制限することを推奨しています。レビュー本文が、ツール権限、コーパスフィルタ、評価ルール、公開設定を変更できてはなりません。
ステップ3の受け入れ基準
- バージョン管理された分類体系と抽出スキーマ。
- レビュー単位の証拠レコード。
- 重要な主張に対する正確なソース範囲。
- 矛盾は平均化せず、そのまま保持する。
- 件数は、生成器が推測するのではなくレコードから算出する。
- 要約文から元レビューへたどれる再現可能な経路。
ステップ4: 根拠に基づく要約を生成し、評価する
証拠レイヤーが整えば、要約モデルの役割はより限定されます。つまり、構造化された証拠を有用な意思決定用アーティファクトに圧縮しつつ、根拠のない結論を追加しないことです。
生成器に厳格な契約を与える
生成指示では、以下を定義すべきです。
- 対象読者と意思決定;
- 許可される証拠フィールド;
- 必要な出力構造;
- 引用またはソースIDの形式;
- 不確実性の表現;
- 相反する証拠に関するルール;
- 禁止する推論;
- 最大長;
- 証拠が不十分な場合の対応。
実践的なルールの一つは、ある記述を提示された証拠に結び付けられないなら、それを省くか仮説として明記することです。
公開前にテストセットを作る
以下を含む代表的な評価セットを作成します。
- 大規模・小規模のレビュー バッチ;
- ポジティブ、ネガティブ、混在した製品;
- テーマが少ないケース;
- 多言語レビュー;
- 重複およびほぼ重複するレビュー;
- 矛盾する証拠;
- 皮肉や曖昧な表現を含むレビュー;
- エスカレーションが必要な深刻な苦情;
- 複数のバリエーションやユースケースを持つ製品。
敵対的なケースも含めてください。きれいで分かりやすい例だけでテストしたシステムは、本番データに遭遇するまでは信頼できそうに見えます。
出力を5つの観点で採点する
各観点について1〜5のルーブリックを使います。
| 観点 | 質問 | 失敗例 |
|---|---|---|
| 根拠性 | 重要な記述はすべて、与えられた証拠で裏付けられているか? | 要約がバッテリー故障の原因を創作している |
| 網羅性 | 要約は、意思決定に関係するテーマと例外を含んでいるか? | 低頻度の安全性に関する苦情を見落としている |
| 忠実性 | 極性、範囲、不確実性を保持しているか? | 「一部のレビュー」が「顧客は一貫してそう言っている」に変わる |
| 有用性 | 想定ユーザーは次の意思決定をより速く行えるか? | 要約はテーマを列挙するだけで、セグメンテーションや証拠がない |
| 追跡可能性 | レビュー担当者は元のレコードにたどり着けるか? | 件数と引用にソースIDがない |
評価を単一の自動スコアに落とし込まないでください。スキーマ、ソースID、件数、引用の一致については決定論的チェックを使い、意味的な品質についてはモデルベースの採点を使い、意思決定の有用性や高リスク事例については人手レビューを行います。
OpenAIのevaluation best practicesでは、非公式な印象に頼るのではなく、タスク固有の評価、代表的なデータセット、継続的評価を推奨しています。Google Cloudのsummary evaluation向けドキュメントでも同様に、完全性、正確性、順守などの品質を分けて扱っています。
リリースしきい値を定義する
最終スコアを見る前に、しきい値を設定します。たとえば、以下のようにします。
- 裏付けのない直接引用がゼロであること;
- 優先度の高いテーマについて、ソースIDの欠落がゼロであること;
- 人手レビューなしに高リスクな主張を公開しないこと;
- テストセットでの最低限のgroundednessスコアとcoverageスコア;
- 許容される最大の件数不一致;
- 証拠が最小しきい値を下回る場合は明示的に棄権すること。
しきい値は意思決定のリスクを反映している必要があります。日次のオリエンテーション要約は、製品リコール調査や対外的な主張に使う要約よりも、ある程度の不確実性を許容できます。
1つの正解率ではなく、評価マトリクスを構築する
通常の例と意図的なストレスケースを含む、固定の評価セットを作成します。本番で起きた重大な失敗はすべて、新しい回帰ケースにするべきです。
| テストファミリー | 例となるケース | 合格条件 |
|---|---|---|
| 証拠の裏付け | 要約が繰り返し発生する欠陥を主張する | すべての主張が、有効なソースIDと許容された表現に対応している |
| カバレッジ | コーパスに1つの主要テーマと2つの少数派テーマが含まれる | 主要テーマが現れ、重要な少数派シグナルが消されていない |
| 矛盾 | 製品バリアントごとにレビューの内容が食い違う | 出力はそれらを平均化せず、バリアントを分けて扱う |
| 疎な証拠 | あるトピックに言及するレビューが2件しかない | システムが棄権する、または証拠が疎であるとラベル付けする |
| 引用の完全性 | レビューに珍しい句読点が含まれている | 引用がソースのスパンと完全に一致する |
| インジェクション耐性 | レビュー本文にモデルへの指示が含まれている | 指示はコンテンツとして扱われ、制御効果を持たない |
| 再現性 | 同じリリースパッケージを再実行する | 出力が定義された安定性許容範囲内に収まる |
| スキーマ準拠 | ジェネレーターが必須フィールドを省略する | 公開前にバリデーションが失敗する |
OpenAIのevaluation best-practices guideでは、タスク固有の評価、ログ記録、可能な限りの自動化、継続的評価が推奨されています。この原則はモデル提供元にかかわらず当てはまります。必要な挙動を定義し、代表的なデータでテストし、重要な失敗を保存してください。
正式なローンチ前ゲートについては、AI review summarization acceptance testing and handoff checklistを参照してください。
ステップ4の受入基準
- バージョン管理されたプロンプトとモデル設定。
- 代表的なテストケースと敵対的テストケース。
- 一部に対する人手作成の参照判定。
- 根拠性、網羅性、忠実性、有用性、トレーサビリティの各スコアを個別に設定。
- 固定されたリリース閾値とエスカレーションルール。
- 回帰テスト用に保存された失敗例。
フルスタックを構築するのではなくソフトウェアを評価している場合は、customer review analysis tool requirements guideが、より広範な機能チェックリストを提供します。
ステップ5: 監視、バージョン管理、フィードバックループを備えてデプロイする
要約器はローンチ評価に合格しても、なお劣化することがあります。レビューの言語は変わり、製品カタログは変わり、ソース項目は消え、分類体系は進化し、プロンプトはずれ、モデルのバージョンごとに挙動は異なります。
デプロイ済みのシステムは、監視対象の分析ワークフローとして扱ってください。
すべての要約を再現できるだけのログを残す
保存する内容:
- コーパスのクエリとフィルター定義;
- レビューIDとコーパスのスナップショット時刻;
- クレンジングと重複排除のバージョン;
- 分類体系のバージョン;
- 抽出モデルとプロンプトのバージョン;
- 生成モデルとプロンプトのバージョン;
- 出力と証拠リンク;
- 評価結果;
- 人手による編集内容と承認状態。
今月の結論が先月と異なる理由を利害関係者に問われたとき、再現性は重要です。
モデルだけでなくパイプライン全体を監視する
次のような運用指標と品質指標を追跡してください:
- 取り込み失敗と欠損フィールド;
- 重複率;
- 未分類アスペクト率;
- 低信頼度の抽出率;
- 証拠リンク失敗率;
- 引用不一致率;
- 件数照合エラー;
- 保留率;
- 人手編集率;
- レビュー担当者の承認率;
- 取り込みから意思決定可能な出力までの時間。
「その他」のアスペクトが急増した場合、分類体系のドリフトを示している可能性があります。テーマ件数の減少は、実際の顧客動向ではなく、ソース取り込みの問題かもしれません。
次の3つの運用予算を追加してください:
- 品質予算: 許容できる未裏付け主張、証拠不足、または重大な欠落の最大割合。
- レイテンシ予算: リトライと人手レビューを含め、ソース利用可能時点から実用的な要約が得られるまでの最大時間。
- コスト予算: 完了した意思決定単位あたりの取り込み、保存、抽出、生成、評価、レビュー担当者の分数。
最も安価なモデル呼び出しでも、手作業による検証が増えるなら、ワークフロー全体としては最も高コストになりえます。トークン数だけでなく、承認済み要約1件あたりのエンドツーエンドコストを測定してください。
ローンチ前にロールバックのトリガーを定義する
次の場合、ロールバックは自動化されるか、直ちに実行可能であるべきです。
- ソース量が予期せず減少する、またはコネクタの更新が停止する。
- 必須の証跡フィールドに対するスキーマ検証が失敗する。
- サポートされていない主張が品質予算を超過する。
- 高重大度のテーマが必須レビューなしで公開される。
- モデル、プロンプト、タクソノミー、または検索の変更によってベンチマークが退行する。
- レビュアーの修正が、特定のセグメント、言語、または製品バリアントに集中する。
ロールバックとは、単に再度プロンプトを変更することではなく、既知のリリースパッケージを復元することを意味します。以前のモデル識別子、プロンプトのバージョン、タクソノミー、コーパスルール、コードリビジョン、評価結果をまとめて保持してください。production rollout checklistでは、シャドウモード、インシデント、制御された拡張についてより詳しく説明しています。
レビュアーのフィードバックループを作成する
レビュアーが要約を変更または却下する理由を記録します。次のような構造化された理由を使用してください。
- unsupported claim;
- 重要なテーマの欠落;
- 誤った極性;
- 誤解を招く一般化;
- 弱い引用;
- 不正確な件数;
- 重複するテーマ;
- 次のステップが不明瞭;
- エスカレーションが必要。
これらの失敗を新しい評価ケースに変換してください。そうすることで、「要約をより良くしてください」という曖昧な指示に頼らずに、システムは改善されます。
ユースケースにリスク管理を適用する
NIST Generative AI Profileは、設計、開発、展開、使用全体にわたるリスク管理を重視しています。レビュー要約においては、これは制約事項を文書化し、予見可能な失敗モードをテストし、展開後の挙動を監視し、エラーの結果に見合った統制を適用することを意味します。より広範なNIST AI Risk Management Frameworkは、有用な運用手順を提供します。すなわち、責任範囲を統治し、ユースケースと影響を受ける関係者を把握し、品質とリスクを測定し、時間の経過とともに問題を管理します。
ステップ5の受け入れ基準
- エンドツーエンドのバージョンログ。
- 品質および運用ダッシュボード。
- ソース、スキーマ、証跡の失敗に対するアラート。
- 構造化されたレビュアーフィードバック。
- あらゆる重大な失敗に対して追加された回帰テスト。
- モデル、プロンプト、タクソノミー、パイプラインの変更に対するロールバック経路。
実践的な30日間の展開計画
| 期間 | 目標 | 成果物 |
|---|---|---|
| 1~5日目 | スコープと証拠ルールを定義する | 意思決定ステートメント、出力スキーマ、リスクポリシー、初期テストセット |
| 6~10日目 | コーパスパイプラインを構築する | トレーサブルな記録、正規化ルール、重複排除ログ、コーパスレポート |
| 11~17日目 | 構造化抽出を構築する | 分類体系、証拠レコード、引用チェック、矛盾処理 |
| 18~24日目 | 生成と評価を行う | 要約契約、評価ルーブリック、人手レビュー、リリースしきい値 |
| 25~27日目 | シャドーモードを実行する | 意思決定を変更せずに、生成された出力を現在の人手ワークフローと比較する |
| 28~30日目 | 支援付きパイロット | 限定的な本番稼働、ダッシュボード、レビュアーフィードバック、ロールバック訓練 |
最初のパイロットは狭く保ってください。1つの製品ファミリー、1つの市場、1人の意思決定責任者、そして1つの定常的な意思決定であれば、責任の所在が不明確な広範な立ち上げよりも多くを学べます。
30日後には、3つの判断のうち1つを下してください。スコープを拡大する、特定のギャップを修正しながらスコープを維持する、またはワークフローを停止する、のいずれかです。「要約は役に立ちそうだ」は判断ではありません。パイロットを、リリースしきい値、運用予算、レビュアーの工数、そして改善対象だったベースラインプロセスと比較してください。
実装引き継ぎマップ
チェックリストが計画段階からエンジニアリングチケットへ移る際には、この引き継ぎマップを使用してください。
| 担当者 | 受け取るもの | 返却必須のもの | ブロッキング質問 |
|---|---|---|---|
| プロダクトまたはリサーチリード | 意思決定契約と出力スキーマ | 承認済みユースケース、非対象、エスカレーション事項 | 要約が誤っていた場合、どの意思決定が変わりますか? |
| データオーナー | ソース一覧と保持ポリシー | コーパスマニフェストのフィールド、削除/エクスポートルール、許可されたソース参照 | 不要なデータを公開せずに、すべてのレビューを追跡できますか? |
| エンジニアリングリード | コーパスと証拠のスキーマ | バージョン管理されたパイプライン、検証チェック、リリース記録、ロールバック経路 | プロンプトやモデルの変更後でも実行を再現できますか? |
| ドメインレビュアー | 観点の分類体系とサンプル証拠 | ラベル規則、矛盾ルール、重大度定義 | どの少数派シグナルも平均化によって消してはならないのはどれですか? |
| QAオーナー | テストセットと評価ルーブリック | リリースしきい値、回帰テストスイート、失敗ログ | どの失敗が、後続作業を生むのではなくローンチを阻止しますか? |
| 運用オーナー | 監視要件 | ダッシュボード、アラート、インシデント担当者、支援付きローンチルール | 証拠品質が低下したとき、誰がワークフローを停止しますか? |
引き継ぎは、すべての担当者が返却成果物を持っていて初めて完了です。「承認済み」と書かれた会議メモだけでは、AIレビュー要約の実装チェックリストとしては不十分です。成果物は、次のリリース、次のレビュアー、そして次のソースデータ変更にも耐えられる必要があります。
構築するか、購入するか、それとも組み合わせるか?
このチェックリストは、モデルとAPIで構築する場合、専用プラットフォームを購入する場合、あるいはその両方を組み合わせる場合のいずれにも適用されます。
- 構築する のは、ワークフローが戦略的に独自で、エンジニアリングの責任体制が安定しており、チームがデータアクセス、評価、セキュリティ、監視を維持できる場合です。
- 購入する のは、スピード、再現性のあるレビューインテリジェンス、アナリストの使いやすさ、既存のワークフローが、カスタムインフラよりも重要な場合です。
- 組み合わせる のは、プラットフォームが収集と分析を担い、APIまたは社内アプリケーションが出力を特定の製品、リサーチ、またはレポーティングのワークフローに届ける場合です。
選択肢を比較する際は、同じ定義済みコーパスを各ワークフローに通してください。要約がどれだけ洗練されて見えるかだけでなく、証拠の追跡可能性、矛盾の扱い、分類体系の制御、評価支援、エクスポート可能性を確認してください。
VOC AI は、Voice of Customer Analysis、レビューに基づく Product Research、競合分析、および Review Analysis API にわたってレビュー分析ワークフローをサポートします。適切な道筋は、差し迫ったニーズがアナリスト向けワークフローなのか、繰り返し発生する意思決定システムなのか、それとも製品統合なのかによって決まります。
最終実装チェックリスト
リリース前に、すべての質問に「はい」と答えられることを確認してください:
- Decision: 要約は、特定のユーザーと反復される意思決定に紐づいていますか?
- Non-goals: 契約には、この要約で何を立証できないかが明記されていますか?
- Owner: 各リリースゲートについて、責任を負う担当者は1人ですか?
- Corpus: 含まれる各レビューを、安定したソースレコードまで追跡できますか?
- Manifest: 正確なデータセットとフィルターを再構築できますか?
- Segmentation: 関連する場合、製品、市場、言語、評価、時系列の違いは保持されていますか?
- Deduplication: 正当な繰り返しを消してしまわずに、削除が記録されていますか?
- Evidence: すべての重要な主張に、レビュー単位の証拠へのリンクがありますか?
- Counterevidence: 少数意見や相反するシグナルは可視化されていますか?
- Claims: コーパスの観察結果と、母集団に関する主張や因果的主張は分けられていますか?
- Quotes: 引用は正確で、帰属可能で、プロンプトインジェクションから保護されていますか?
- Schema: 無効な出力は公開前に失敗しますか?
- Evaluation: グラウンディング、カバレッジ、忠実性、有用性、追跡可能性をテストしましたか?
- Stress tests: ベンチマークには、希薄、矛盾、分割、敵対的な例が含まれていますか?
- Thresholds: リリース基準と棄却基準は明示されていますか?
- Risk: 高リスクのトピックは人手レビューをトリガーしますか?
- Versioning: モデル、プロンプト、タクソノミー、またはコーパスが変更された後でも、要約を再現できますか?
- Budgets: 品質、レイテンシ、コスト、レビュー工数の上限はエンドツーエンドで測定されていますか?
- Rollback: チームは既知のリリースパッケージを迅速に復元できますか?
- Security: 信頼できないレビュー本文は、指示、ツール、公開制御から分離されていますか?
- Learning: すべての重要な修正は、回帰テストまたはルール更新になりますか?
実装の準備が整うのは、文章が流暢に聞こえるときではなく、証拠が精査に耐えるときです。
フルスタックを構築するのではなくプラットフォームを評価している場合でも、調達時に同じチェックリストを適用してください。ベンダーに、独自のテストセットを使って、証拠の追跡可能性、コーパス制御、エクスポート、評価、セキュリティ境界、ロールバック動作を実演するよう求めてください。AI review summarization vendor evaluation checklistは、構造化されたスコアカードを提供します。
このAI review summarization: implementation checklistをハブとして扱ってください。チームがより深いQAテスト、エンジニアリング成果物、セキュリティ制御、受け渡し時の承認、ベンダースコアリング、または本番運用を必要とするときは、関連ページを参照してください。
よくある質問
AI review summarizationとは何ですか?
AI review summarizationとは、言語モデルや関連する自然言語処理システムを使って、定義された顧客レビューの集合をテーマ、知見、または意思決定向けの出力に圧縮することです。本番ワークフローでは、ソースの追跡可能性、不確実性、矛盾、コーパスの境界を保持する必要があります。
AI要約に必要なレビュー数はどれくらいですか?
सार्व一な最小値はありません。適切な閾値は、意思決定、製品セグメンテーション、レビューの長さ、テーマの多様性、必要な確信度によって異なります。分析したコーパスの規模は必ず報告し、証拠が乏しい場合は強い結論を控えてください。
AI要約には顧客の引用を含めるべきですか?
はい、引用が検証と文脈の理解を向上させる場合は含めるべきです。引用は、安定したレビューIDまたはリンクを伴う、ソースの正確な抜粋でなければなりません。生成した言い換えを直接引用として提示してはいけません。
レビュー要約の精度はどのように測定しますか?
複数の次元を測定します。根拠性、網羅性、忠実性、有用性、トレーサビリティです。決定的なチェック、モデルベースの評価、人手によるレビューを組み合わせます。文法的に正しい要約であっても、重要な証拠を省いたり、弱い傾向を過大に述べたりすることがあるため、精度は1つのスコアではありません。
最初のエンジニアリングチケットには何を含めるべきですか?
最初のチケットでは、本番の要約を生成する前に、意思決定契約、コーパスのマニフェスト、証拠スキーマ、出力スキーマ、検証チェックを作成する必要があります。モデル選定は、システムがどの証拠を保持しなければならないかをチームが把握した後で行えば十分です。
レビュー要約で、問題がどれほど一般的かを証明できますか?
分析したレビューコーパス内での頻度は記述できます。すべての顧客における有病率を自動的に推定したり、因果関係を説明したり、ビジネス影響を予測したりはできません。それらの問いには、追加データと、それらのために設計された方法が必要です。